# BEiT
## Обзор
Модель BEiT была предложена в статье [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) авторами Хангбо Бао, Ли Дун и Фуру Вэй. Вдохновлённая BERT, BEiT стала первой работой, в которой самообучаемая предварительная настройка Vision Transformers (ViT) превзошла по результатам надзорное обучение. Вместо того чтобы обучать модель предсказывать класс изображения (как это делалось в [оригинальной статье о ViT](https://huggingface.co/papers/2010.11929)), модели BEiT предварительно обучаются предсказывать визуальные токены из кодовой книги модели [DALL-E](https://huggingface.co/papers/2102.12092) от OpenAI на основе замаскированных патчей.
Аннотация из статьи следующая:
*Мы представляем модель представления изображений с самообучением BEiT (Bidirectional Encoder representation from Image Transformers). Следуя подходу BERT, разработанному в области обработки естественного языка, мы предлагаем задачу моделирования изображений с маскированием для предварительного обучения зрительных Transformers. В частности, в процессе предварительного обучения каждое изображение имеет два представления: патчи изображений (например, 16x16 пикселей) и визуальные токены (то есть дискретные токены). Сначала мы «токенизируем» исходное изображение в визуальные токены. Затем мы случайно маскируем некоторые патчи изображений и подаем их в базовый Transformer. Целью предварительного обучения является восстановление исходных визуальных токенов на основе поврежденных патчей изображений. После предварительного обучения BEiT мы напрямую дообучаем параметры модели на задачах нижнего уровня, добавляя слои задач поверх предварительно обученного энкодера. Экспериментальные результаты на задачах классификации изображений и семантической сегментации показывают, что наша модель достигает конкурентоспособных результатов по сравнению с предыдущими методами предварительного обучения. Например, BEiT базового размера достигает точности top-1 83,2% на ImageNet-1K, значительно превосходя обучение DeiT с нуля (81,8%) при той же конфигурации. Более того, BEiT большого размера достигает 86,3%, используя только ImageNet-1K, что даже превосходит ViT-L с надзорным предварительным обучением на ImageNet-22K (85,2%).*
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/microsoft/unilm/tree/master/beit).
## Советы по использованию
- Модели BEiT представляют собой обычные Vision Transformers, но обучаются в режиме самообучения (self-supervised), а не с учителем. При дообучении на ImageNet-1K и CIFAR-100 они превосходят как [оригинальную модель (ViT)](vit), так и [Data-efficient Image Transformers (DeiT)](deit). Демонстрационные ноутбуки с примерами инференса и дообучения на собственных данных доступны [здесь](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (достаточно заменить [ViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTImageProcessor) на [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor), а [ViTForImageClassification](/docs/transformers/v5.23.0/ru/model_doc/vit#transformers.ViTForImageClassification) — на [BeitForImageClassification](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForImageClassification)).
- Также доступен демонстрационный ноутбук, показывающий, как объединить токенизатор изображений DALL-E с BEiT для выполнения моделирования изображений с маскированием. Вы можете найти его [здесь](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT).
- Поскольку модели BEiT ожидают, что все изображения будут иметь одинаковый размер (разрешение), можно использовать [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor) для изменения размера (или масштабирования) и нормализации изображений перед подачей в модель.
- Как разрешение патчей, так и разрешение изображений, используемые при предварительном обучении или дообучении, отражаются в имени каждой контрольной точки. Например, `microsoft/beit-base-patch16-224` указывает на архитектуру базового размера с разрешением патчей 16x16 и разрешением дообучения 224x224. Все контрольные точки можно найти на [хабе](https://huggingface.co/models?search=microsoft/beit).
- Доступные контрольные точки либо (1) предварительно обучены только на [ImageNet-22k](http://www.image-net.org/) (наборе из 14 миллионов изображений и 22 тыс. классов), либо (2) дополнительно дообучены на ImageNet-22k, либо (3) дополнительно дообучены на [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (также известном как ILSVRC 2012, набор из 1,3 миллиона изображений и 1000 классов).
- BEiT использует относительные позиционные эмбеддинги, вдохновлённые моделью T5. Во время предварительного обучения авторы разделяли смещение относительных позиций между несколькими слоями само-внимания. Во время дообучения смещение относительных позиций каждого слоя инициализируется общим смещением относительных позиций, полученным после предварительного обучения. Обратите внимание, что если требуется обучить модель с нуля, необходимо установить атрибут `use_relative_position_bias` или `use_relative_position_bias` объекта [BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig) в значение `True`, чтобы добавить позиционные эмбеддинги.
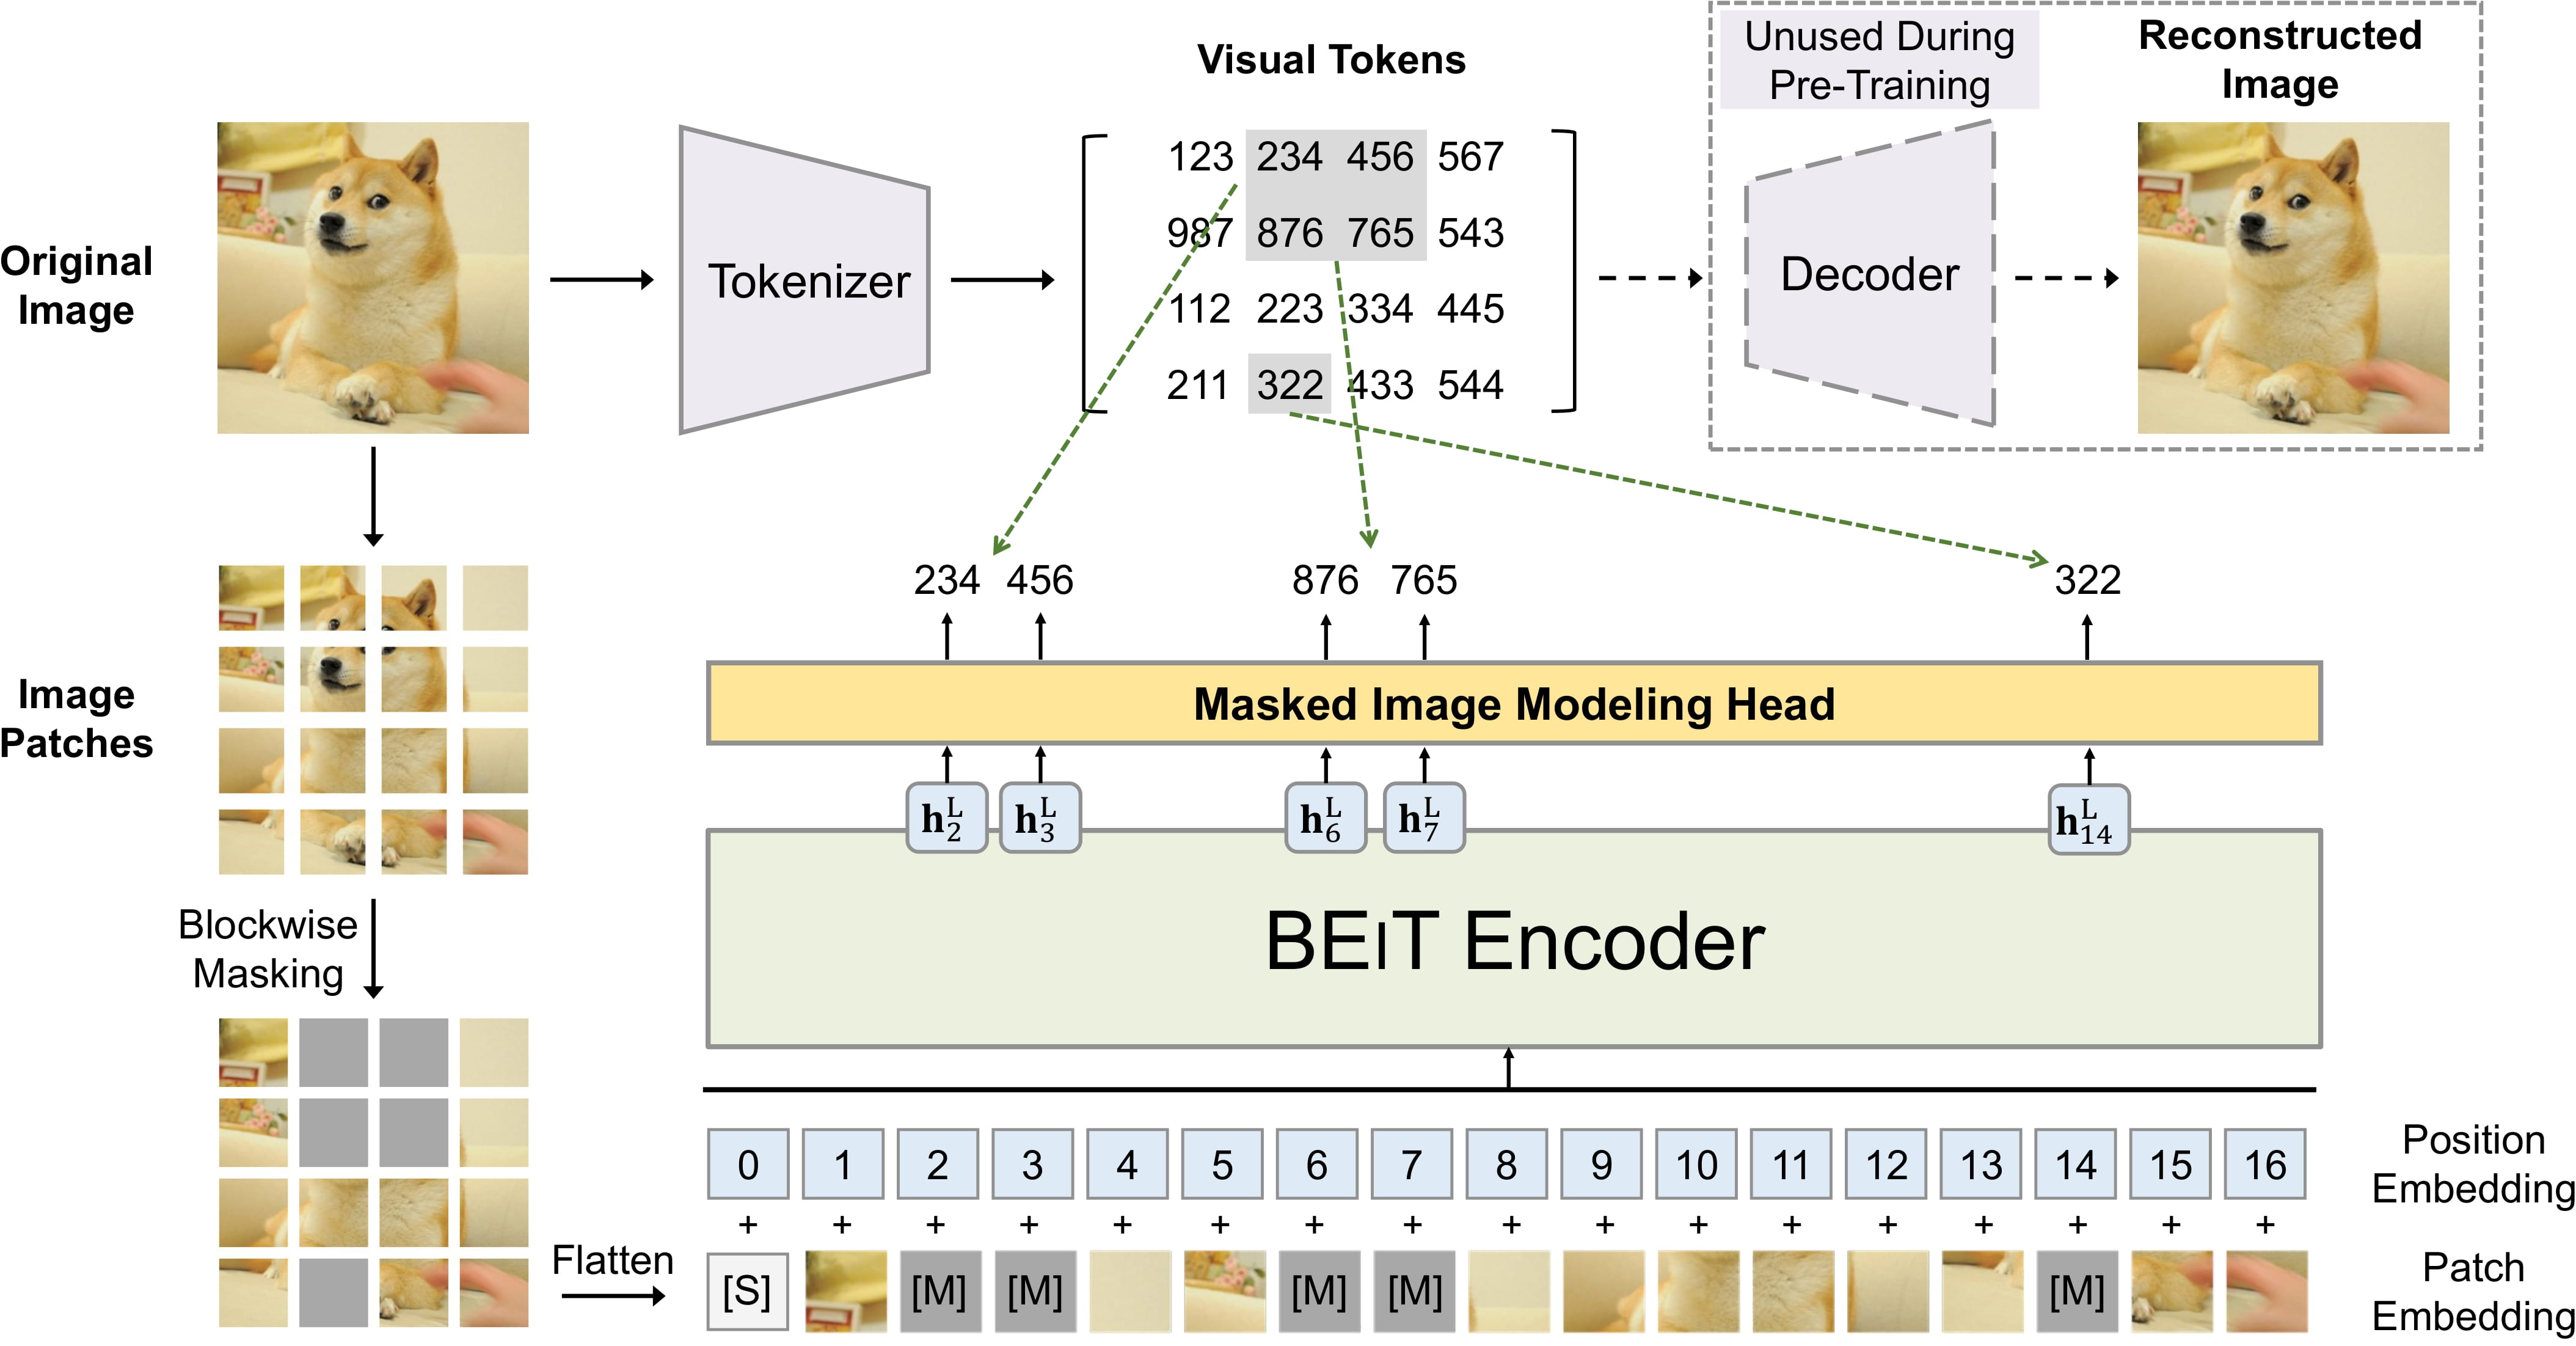 Предобучение BEiT. Взято из оригинальной статьи.
### Использование масштабированного внимания на основе скалярного произведения (SDPA)
PyTorch включает в себя нативный оператор масштабированного внимания на основе скалярного произведения (SDPA) в составе `torch.nn.functional`. Эта функция объединяет несколько реализаций, которые могут применяться в зависимости от входных данных и используемого оборудования. Подробнее см. в [официальной документации](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) или на странице [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention).
SDPA используется по умолчанию для `torch>=2.1.1`, когда доступна соответствующая реализация, но вы также можете установить `attn_implementation="sdpa"` в `from_pretrained()`, чтобы явно запросить использование SDPA.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
Для достижения максимального ускорения мы рекомендуем загружать модель в половинной точности (например, `torch.float16` или `torch.bfloat16`).
На локальном бенчмарке (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, ОС Ubuntu 20.04) с `float16` и моделью `microsoft/beit-base-patch16-224` мы наблюдали следующие улучшения при обучении и инференсе:
#### Обучение
| num_training_steps | batch_size | image_size | is_cuda | Время на батч (eager - с) | Время на батч (sdpa - s) | Ускорение (%) | Пиковая память Eager (МБ) | Пиковая память SDPA (МБ) | Экономия памяти (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | True | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Вывод
| Размер батча изображений | Eager (с/итер) | Eager CI, % | Оперативная память (МБ) | SDPA (с/итер) | SDPA CI, % | Память SDPA (МБ) | Ускорение SDPA | Экономия памяти SDPA (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены 🌎), которые помогут вам начать работу с BEiT.
- [BeitForImageClassification](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForImageClassification) поддерживается в этом [ноутбуке](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- См. также: [Руководство по задаче классификации изображений](../tasks/image_classification)
**Семантическая сегментация**
- [Руководство по задаче семантической сегментации](../tasks/semantic_segmentation)
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
## Специфические выходные данные BEiT[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L54)
**Параметры:**
last_hidden_state (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) : Последовательность скрытых состояний на выходе последнего слоя модели.
pooler_output (`torch.Tensor` формы `(batch_size, hidden_size)`) : Среднее значение скрытых состояний последнего слоя для токенов патчей (без токена *[CLS]*), если *config.use_mean_pooling* установлено в True. Если установлено в False, возвращается финальное скрытое состояние токена *[CLS]*.
hidden_states (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) : Кортеж из `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные данные начальных встраиваний.
attentions (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Класс для результатов работы [BeitModel](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitModel).
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/configuration_beit.py#L25)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `8192`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Вероятность dropout для всех полносвязных слоёв в эмбеддингах, энкодере и пулере.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `224`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `16`) : Размер (разрешение) каждого патча.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
use_mask_token (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли токен маски для моделирования замаскированных изображений.
use_absolute_position_embeddings (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли абсолютные позиционные эмбеддинги.
use_relative_position_bias (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли относительные позиционные эмбеддинги в стиле T5 в слоях само-внимания.
use_shared_relative_position_bias (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли одни и те же вложения относительных позиций во всех слоях само-внимания Transformer.
layer_scale_init_value (`float`, *optional*, по умолчанию `0.1`) : Масштаб, используемый в слоях само-внимания. 0.1 для базовых моделей, 1e-6 для крупных. Установите 0, чтобы отключить масштабирование слоя.
drop_path_rate (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Коэффициент drop path для слияния патчей.
use_mean_pooling (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли усреднение (mean pooling) финальных скрытых состояний патчей вместо финального скрытого состояния токена CLS перед применением классификационной головы.
pool_scales (`tuple[int]`, *optional*, по умолчанию `[1, 2, 3, 6]`) : Масштабы пулинга, используемые в Pooling Pyramid Module, применяемые к последней карте признаков.
use_auxiliary_head (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли вспомогательный слой во время обучения.
auxiliary_loss_weight (`float`, *необязательный*, по умолчанию 0.4) : Вес функции потерь кросс-энтропии для вспомогательной головы.
auxiliary_channels (`int`, *необязательный*, по умолчанию 256) : Количество каналов, используемых в вспомогательной голове.
auxiliary_num_convs (`int`, *optional*, по умолчанию 1) : Количество свёрточных слоёв, используемых в вспомогательной голове.
auxiliary_concat_input (`bool`, *необязательный*, по умолчанию `False`) : Служит для определения, следует ли конкатенировать выход вспомогательного слоя с входом перед слоем классификации.
semantic_loss_ignore_index (`int`, *необязательный*, по умолчанию `255`) : Индекс, который игнорируется функцией потерь модели семантической сегментации.
add_fpn (`bool`, *необязательный*, по умолчанию `False`) : Добавлять ли FPN как часть backbone. Актуально только для `BeitBackbone`.
reshape_hidden_states (`bool`, *необязательный*, по умолчанию `True`) : Указывает, следует ли преобразовать карты признаков в 4D-тензоры формы `(batch_size, hidden_size, height, width)`, если модель используется как backbone. Если `False`, карты признаков будут 3D-тензорами формы `(batch_size, seq_len, hidden_size)`. Актуально только для `BeitBackbone`.
Это класс конфигурации для хранения настроек модели BeitModel. Он используется для создания модели Beit в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L50)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_reduce_labels (`bool`, *kwargs*, *optional*, по умолчанию `self.do_reduce_labels`) : Нужно ли уменьшить все значения меток в сегментационных картах на 1. Обычно используется для наборов данных, где 0 обозначает фон, а сам фон не входит в число всех классов набора данных (например, ADE20k). Метка фона будет заменена на 255.
Создает процессор изображений BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L70)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
segmentation_maps (`ImageInput`, *необязательный*) : карты сегментации для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_reduce_labels (`bool`, *kwargs*, *optional*, по умолчанию `self.do_reduce_labels`) : Нужно ли уменьшить все значения меток в сегментационных картах на 1. Обычно используется для наборов данных, где 0 обозначает фон, а сам фон не входит в число всех классов набора данных (например, ADE20k). Метка фона будет заменена на 255.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L183)
**Параметры:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Сырые выходные данные модели.
target_sizes (`list[Tuple]` длины `batch_size`, *необязательный*) : Список кортежей, соответствующих запрашиваемому конечному размеру (высота, ширина) каждого предсказания. Если не задано, предсказания не будут изменены в размере.
return_segmentation_scores (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли возвращать оценки сегментации вместе с картой сегментации. Если `True`, каждый элемент возвращаемого списка представляет собой `SemanticSegmentationPostProcessorOutput` с полями `segmentation` (идентификаторы классов, форма `(height, width)`) и `segmentation_scores` (форма `(num_classes, height, width)`).
**Возвращает:** `list[torch.Tensor]` или `list[SemanticSegmentationPostProcessorOutput]`
Если `return_segmentation_scores=False` (по умолчанию), возвращается список длины `batch_size`, где каждый элемент — карта сегментации формы `(height, width)` с идентификаторами классов. Если `return_segmentation_scores=True`, возвращается список объектов `SemanticSegmentationPostProcessorOutput` с полями `segmentation` (идентификаторы классов, форма `(height, width)`) и `segmentation_scores` (форма `(num_classes, height, width)`). В обоих случаях `(height, width)` соответствует целевому размеру (если указан `target_sizes`).
Преобразует выход [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForSemanticSegmentation) в карты семантической сегментации.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_reduce_labels (`bool`, *kwargs*, *optional*, по умолчанию `self.do_reduce_labels`) : Нужно ли уменьшить все значения меток в сегментационных картах на 1. Обычно используется для наборов данных, где 0 обозначает фон, а сам фон не входит в число всех классов набора данных (например, ADE20k). Метка фона будет заменена на 255.
Создает процессор изображений BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
segmentation_maps (`ImageInput`, *необязательный*) : карты сегментации для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_reduce_labels (`bool`, *kwargs*, *optional*, по умолчанию `self.do_reduce_labels`) : Нужно ли уменьшить все значения меток в сегментационных картах на 1. Обычно используется для наборов данных, где 0 обозначает фон, а сам фон не входит в число всех классов набора данных (например, ADE20k). Метка фона будет заменена на 255.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Параметры:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Сырые выходные данные модели.
target_sizes (`list[Tuple]` длины `batch_size`, *необязательный*) : Список кортежей, соответствующих запрашиваемому конечному размеру (высота, ширина) каждого предсказания. Если не задано, предсказания не будут изменены в размере.
return_segmentation_scores (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли возвращать оценки сегментации вместе с картой сегментации. Если `True`, каждый элемент возвращаемого списка представляет собой `SemanticSegmentationPostProcessorOutput` с полями `segmentation` (идентификаторы классов, форма `(height, width)`) и `segmentation_scores` (форма `(num_classes, height, width)`).
**Возвращает:** `list[torch.Tensor]` или `list[SemanticSegmentationPostProcessorOutput]`
Если `return_segmentation_scores=False` (по умолчанию), возвращается список длины `batch_size`, где каждый элемент — карта сегментации формы `(height, width)` с идентификаторами классов. Если `return_segmentation_scores=True`, возвращается список объектов `SemanticSegmentationPostProcessorOutput` с полями `segmentation` (идентификаторы классов, форма `(height, width)`) и `segmentation_scores` (форма `(num_classes, height, width)`). В обоих случаях `(height, width)` соответствует целевому размеру (если указан `target_sizes`).
Преобразует выход [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForSemanticSegmentation) в карты семантической сегментации.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L486)
**Параметры:**
config ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
add_pooling_layer (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли добавлять слой пулинга
Модель Beit без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L512)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor). Подробности см. в [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor) для обработки изображений).
bool_masked_pos (`torch.BoolTensor` формы `(batch_size, num_patches)`, *необязательный*) : Позиции с булевым маскированием. Указывает, какие патчи замаскированы (1), а какие нет (0).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) и входных данных.
Метод forward модели [BeitModel](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Среднее значение скрытых состояний последнего слоя для токенов патчей (без токена *[CLS]*), если *config.use_mean_pooling* установлено в True. Если установлено в False, возвращается финальное скрытое состояние токена *[CLS]*.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L583)
**Параметры:**
config ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель-трансформер Beit с «языковой» головной частью. BEiT выполняет маскированное моделирование изображений, предсказывая визуальные токены векторно-квантованного вариационного автоэнкодера (VQ-VAE), тогда как другие модели компьютерного зрения, такие как ViT и DeiT, предсказывают значения пикселей RGB. В результате этот класс несовместим с [AutoModelForMaskedImageModeling](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoModelForMaskedImageModeling), поэтому для выполнения маскированного моделирования изображений с помощью BEiT необходимо использовать [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForMaskedImageModeling) напрямую.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L600)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor). Подробности см. в [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor) для обработки изображений).
bool_masked_pos (`torch.BoolTensor` формы `(batch_size, num_patches)`) : Булевы позиции маски. Указывает, какие патчи замаскированы (1), а какие нет (0).
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) и входных данных.
Метод forward класса [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForMaskedImageModeling) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери маскированного языкового моделирования (MLM).
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L675)
**Параметры:**
config ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Beit — трансформер с головой для классификации изображений (линейный слой поверх среднего значения финальных скрытых состояний токенов патчей), например, для ImageNet.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L688)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor). Подробности см. в [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor) для обработки изображений).
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [ImageClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) или `tuple(torch.Tensor)`
Объект [ImageClassifierOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) и входных данных.
Метод forward класса [BeitForImageClassification](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForImageClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) — Кортеж из `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет такой слой, + один для вывода каждого этапа) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния (также называемые картами признаков) модели на выходе каждого этапа.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, patch_size, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L978)
**Параметры:**
config ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Beit с головой семантической сегментации, например, для ADE20K, CityScapes.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L1000)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor). Подробности см. в [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [BeitImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitImageProcessor) для обработки изображений).
labels (`torch.LongTensor` формы `(batch_size, height, width)`, *необязательный*) : Карты семантической сегментации для вычисления функции потерь. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels > 1`, вычисляется функция потерь классификации (Cross-Entropy).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [SemanticSegmenterOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) или `tuple(torch.Tensor)`
Объект [SemanticSegmenterOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([BeitConfig](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitConfig)) и входных данных.
Метод forward класса [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/ru/model_doc/beit#transformers.BeitForSemanticSegmentation) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels, logits_height, logits_width)`) — Оценки классификации для каждого пикселя.
Возвращаемые logits не обязательно имеют тот же размер, что и переданные на вход `pixel_values`. Это сделано для того, чтобы избежать двух интерполяций и потери качества, когда пользователю необходимо изменить размер logits до исходного размера изображения на этапе постобработки. Всегда проверяйте форму logits и изменяйте размер по мере необходимости.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, patch_size, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, patch_size, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```