
Datasets documentation
Bir veri setini Hub'da paylaş
Bir veri setini Hub'da paylaş
Hub, topluluk tarafından derlenen ve popüler araştırma veri setlerinden oluşan kapsamlı bir koleksiyona ev sahipliği yapar. ML topluluğunun büyümesine katkıda bulunmak ve herkes için ilerlemeyi hızlandırmak için veri setinizi Hub'a paylaşmanızı öneririz. Tüm katkılar memnuniyetle karşılanır; bir veri seti eklemek sadece sürükle ve bırak kadar kolaydır!
Henüz bir hesabınız yoksa Hugging Face Hub hesabı oluşturarak başlayın.
Hub arayüzüyle yükle
Hub'ın web tabanlı arayüzü, herhangi bir geliştirici deneyimine sahip olmayan kullanıcıların bir veri seti yüklemesine olanak tanır.
Depo oluşturun
Bir depo, revizyon geçmişi dahil olmak üzere tüm veri seti dosyalarınızı barındırır ve bu sayede birden fazla veri seti sürümünün saklanmasını mümkün kılar.
- Profilinize tıklayın ve yeni bir veri seti deposu oluşturmak için Yeni Veri Seti seçeneğini seçin.
- Veri setiniz için bir ad seçin ve veri setinin herkese açık mı yoksa özel mi olduğunu belirleyin. Herkese açık bir veri seti herkes tarafından görüntülenebilirken, özel bir veri seti yalnızca siz veya organizasyonunuzun üyeleri tarafından görüntülenebilir.

Veri setini yükle
Bir depo oluşturduktan sonra, bir dosya eklemek için Dosyalar ve sürümler sekmesine gidin. Veri seti dosyalarınızı yüklemek için Dosya ekle seçeneğini seçin.
.csv,.mp3ve.jpggibi birçok metin, ses ve görüntü veri uzantısını destekliyoruz..csv,.json,.jsonlve.txtgibi metin veri uzantıları için, Hub'a yüklemelerinden önce bunları sıkıştırmanızı öneririz (örneğin.zipveya.gzdosya uzantısına dönüştürerek).Metin dosya uzantıları varsayılan olarak Git LFS tarafından izlenmez ve 10MB'dan büyüklerse commit edilip yüklenmez. İzlenen dosya uzantılarının tam listesi için depodaki
.gitattributesdosyasına bakın. Bu öğretici için küçük olduklarından aşağıdaki örnek.csvdosyalarını kullanabilirsiniz: train.csv, test.csv.
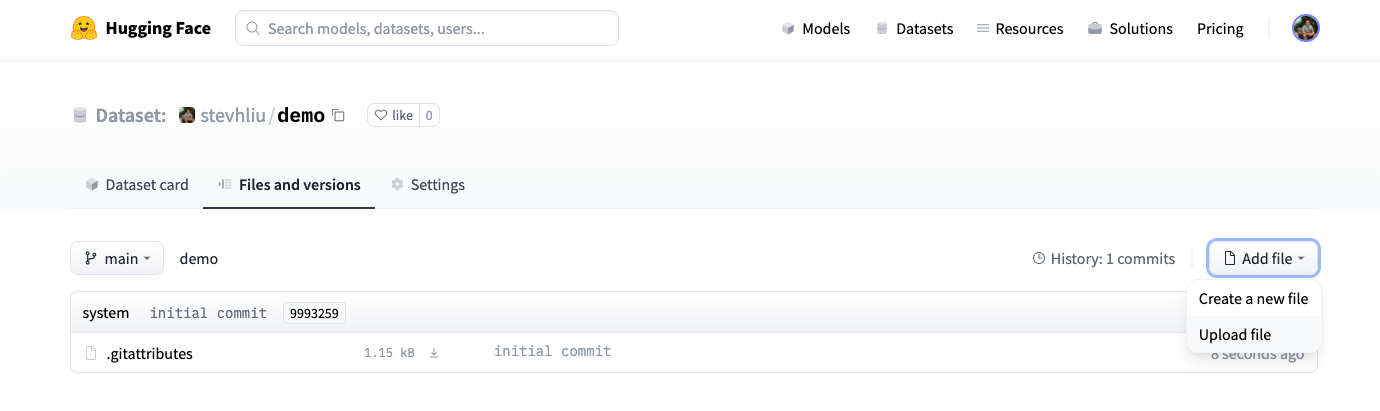
- Veri seti dosyalarınızı sürükleyip bırakın ve kısa bir açıklayıcı commit mesajı ekleyin.

- Veri seti dosyalarınızı yükledikten sonra, bu dosyalar veri seti deponuzda saklanır.

Bir Dataset kartı oluşturun
Bir Veri seti kartı eklemek, kullanıcıların veri setinizi bulmasına ve onu sorumlu bir şekilde nasıl kullanacaklarını anlamasına yardımcı olmak açısından son derece değerlidir.
- Bir Dataset kartı oluşturmak için Create Dataset Card düğmesine tıklayın. Bu düğme, deposunuzda bir
README.mddosyası oluşturur.

En üstte, lisans, dil ve görev kategorileri gibi seçeneklerden oluşan Metadata UI bileşenini göreceksiniz. Bunlar, kullanıcıların Hub'da veri setinizi keşfetmesine yardımcı olmak için en önemli etiketlerdir. Her bir alandan bir seçenek seçtiğinizde, bunlar otomatik olarak veri seti kartının en üstüne eklenir.
Ayrıca,
annotations_creatorsgibi (zorunlu olmayan) tam bir etiket seçenekleri seti içeren Dataset Card spesifikasyonlarını inceleyerek uygun etiketleri seçmenize yardımcı olabilir.
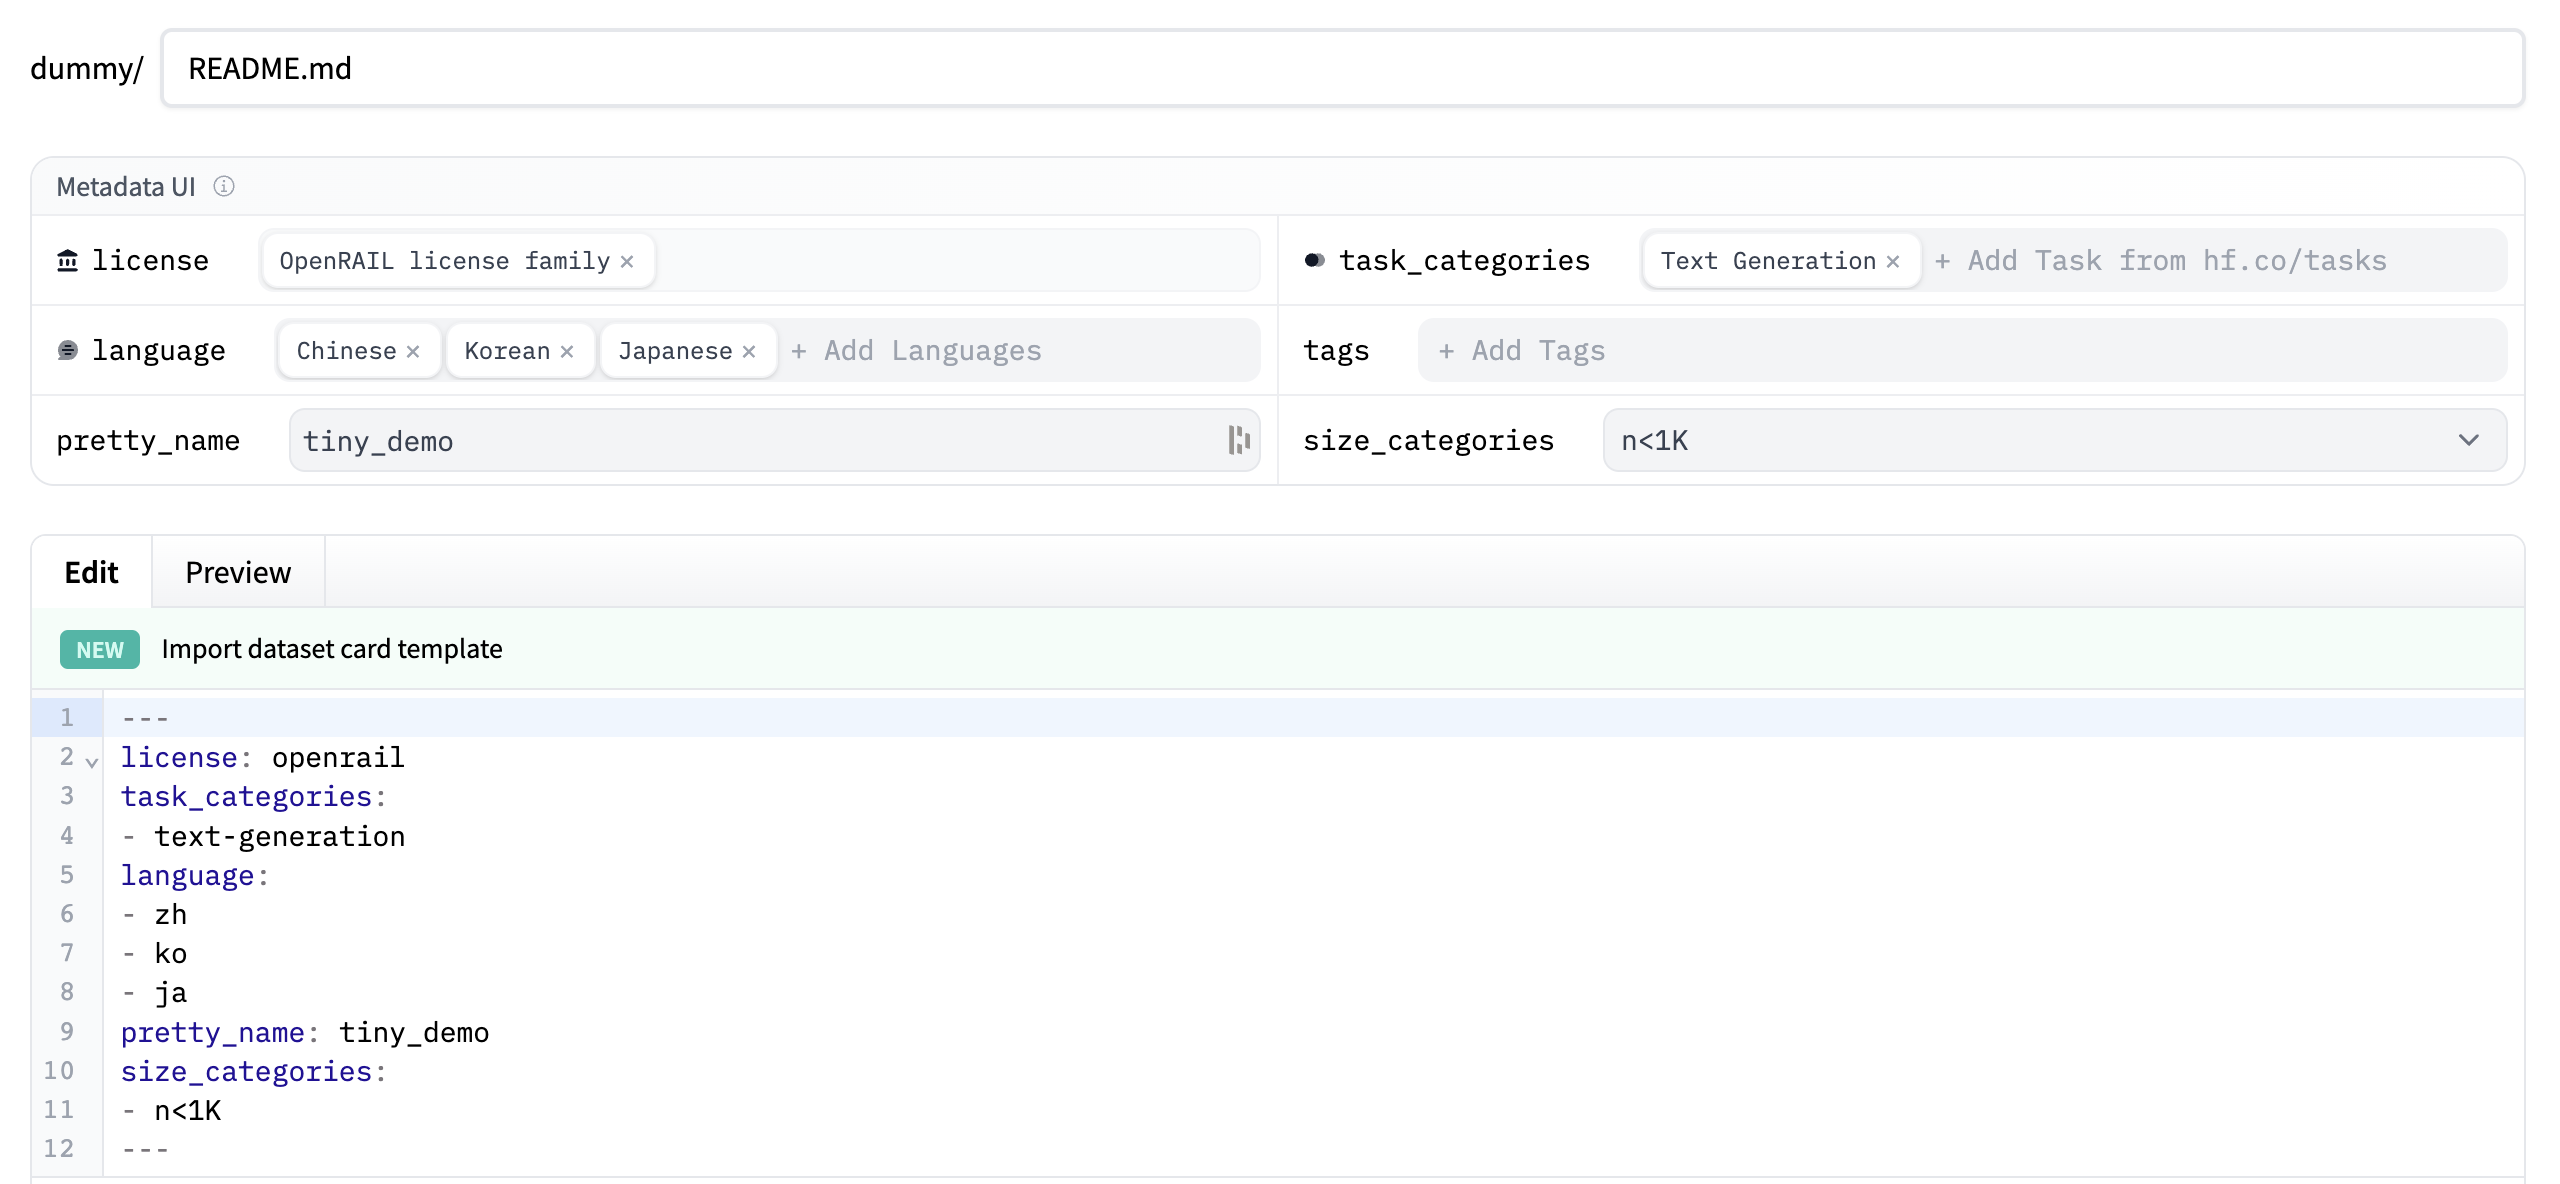
- Düzenleyicinin üstündeki Veri seti kartı şablonu içe aktar bağlantısına tıklayarak bir veri seti kartı şablonu otomatik olarak oluşturun. Şablonu doldurmak, veri setinizi topluluğa tanıtmak ve kullanıcıların onu nasıl kullanacağını anlamalarına yardımcı olmak için harika bir yoldur. İyi bir Veri Seti kartının nasıl görünmesi gerektiğine dair ayrıntılı bir örnek için CNN DailyMail Veri Seti kartına göz atın.
Veri setini yükle
Veri setiniz Hub'da saklandıktan sonra, herkes onu load_dataset() işleviyle yükleyebilir:
>>> from datasets import load_dataset

>>> dataset = load_dataset("stevhliu/demo")
Python ile Yükle
Programatik olarak bir veri seti yüklemeyi tercih eden kullanıcılar huggingface_hub kütüphanesini kullanabilir. Bu kütüphane, kullanıcıların Python üzerinden Hub ile etkileşim kurmasını sağlar.
- Kütüphaneyi kurarak başlayın:
pip install huggingface_hub
- Hub'da bir veri setini Python ile yüklemek için Hugging Face hesabınıza giriş yapmanız gerekir:
hf auth login
- Dosyanızı deponuza eklemek, commit yapmak ve göndermek için
push_to_hub()fonksiyonunu kullanın:
>>> from datasets import load_dataset

>>> dataset = load_dataset("stevhliu/demo")
# dataset = dataset.map(...)  # do all your processing here
>>> dataset.push_to_hub("stevhliu/processed_demo")
Veri setinizi özel olarak ayarlamak için private parametresini True olarak belirleyin. Bu parametre yalnızca bir depoyu ilk kez oluşturuyorsanız çalışır.
>>> dataset.push_to_hub("stevhliu/private_processed_demo", private=True)Bir veri setine yeni bir yapılandırma (veya alt küme) eklemek veya yeni bir bölme (eğitim/doğrulama/test) eklemek için lütfen Dataset.push_to_hub() belgelerine başvurun.
Mevcut bir veri seti deposuna satır eklemek için Dataset.push_to_hub() veya DatasetDict.push_to_hub() ile append=True kullanın. Yeni satırların, mevcut yapılandırma ile aynı özelliklere sahip olması gerekir.
>>> new_rows.push_to_hub("stevhliu/processed_demo", split="train", append=True)
>>> new_splits.push_to_hub("stevhliu/processed_demo", append=True, max_shard_size="500MB")
Kart veri seti istatistiklerine sahip olduğunda, indirme eklemesi yalnızca istenen bölme için yapılandırmanın data_files eşlemesi tarafından seçilen son Parquet parçasını indirir ve bu işlem, eşlemenin sırasına göre listelenen tüm dizinler boyunca uygulanır. Bu dosyanın mevcut kodlanmış satır grupları korunur ve yeni satırlar eklenir. Sonuçlanan dosya max_shard_size sınırını aşacaksa, mevcut parça korunur ve yeni satırlar ek parçalara yazılır. Tek bir satır bu sınırı aşabilir. Değişmeyen parçalar, yalnızca parça sayısı değiştiğinde sunucu tarafı kopyalarla yeniden adlandırılır. PyArrow 21 ve sonraki sürümler, eklenen satır grupları için içerik tanımlı parçalama (chunking) özelliğini etkinleştirir; böylece Xet mevcut parçaları yeniden kullanabilir.
num_shards ile, eşlenmiş tüm dizinler üzerinden eklemenin ardından bölünmenin toplam parça sayısını belirtin.
Bu değer mevcut sayıdan küçük olamaz; aynı sayıyı korumak, son parçayı boyut sınırı olmadan uzatır. Diğer bölünmeler ve yapılandırmalar korunur. Yeni veya yeniden numaralandırılan parçalar data_dir kullanır ve veri seti kartındaki satır ve boyut sayıları güncellenir. Yeni bir bölünme normal şekilde yüklenir. Bir eklem sırasında başka bir push işlemi depoyu değiştirirse, bu değişikliklerin üzerine yazmak yerine commit işlemi başarısız olur; güncellenmiş depoya karşı yeniden deneyin. append=False (varsayılan) normal değiştirme davranışını korur. Ekleme, veri seti depoları için desteklenir, variller için değil.
İstatistikler eksikse, yapılandırmanın eşlenmiş dosyalarından geri kazanılır. Bayt sayılarını geri kazanmak, Arrow bellek boyutlarını ölçmek için bu dosyaların partiler halinde okunmasını gerektirir; Parquet kodlama boyutları, veri seti bellek boyutları olarak kullanılmaz.
Gizlilik
Özel bir veri setine yalnızca siz erişebilirsiniz. Benzer şekilde, bir veri setini organizasyonunuz içinde paylaşırsanız, organizasyonun üyeleri de veri setine erişebilir.
token parametresine kimlik doğrulama belirtecinizi sağlayarak özel bir veri seti yükleyin:
>>> from datasets import load_dataset

# Load a private individual dataset
>>> dataset = load_dataset("stevhliu/demo", token=True)

# Load a private organization dataset
>>> dataset = load_dataset("organization/dataset_name", token=True)
Sonraki adım nedir?
Tebrikler, eğitimleri tamamladınız! 🥳
Buradan şunlara devam edebilirsiniz:
- 🤗 Datasets'in veri setinizi işlemek için kullanılan diğer işlevleri hakkında daha fazla bilgi edinin.
- Büyük veri kümelerini yerel olarak indirmeden akış olarak kullanın.
- Veri seti bölümlerinizi ve yapılandırmalarınızı tanımlayın ve veri setinizi toplulukla paylaşın.
🤗 Datasets hakkında herhangi bir sorunuz varsa, forum üzerinden topluluğa katılmaktan ve soru sormaktan çekinmeyin.
Update on GitHub