
PEFT documentation
IA3
IA3
IA3 est un excellent choix lorsque vous avez besoin de la taille d’adaptateur la plus réduite possible — il utilise des vecteurs appris plutôt que des matrices de faible rang, ce qui en fait l’une des méthodes les plus économes en paramètres disponibles. Si votre priorité est une empreinte disque/mémoire minimale et une formation rapide, IA3 est un candidat solide.
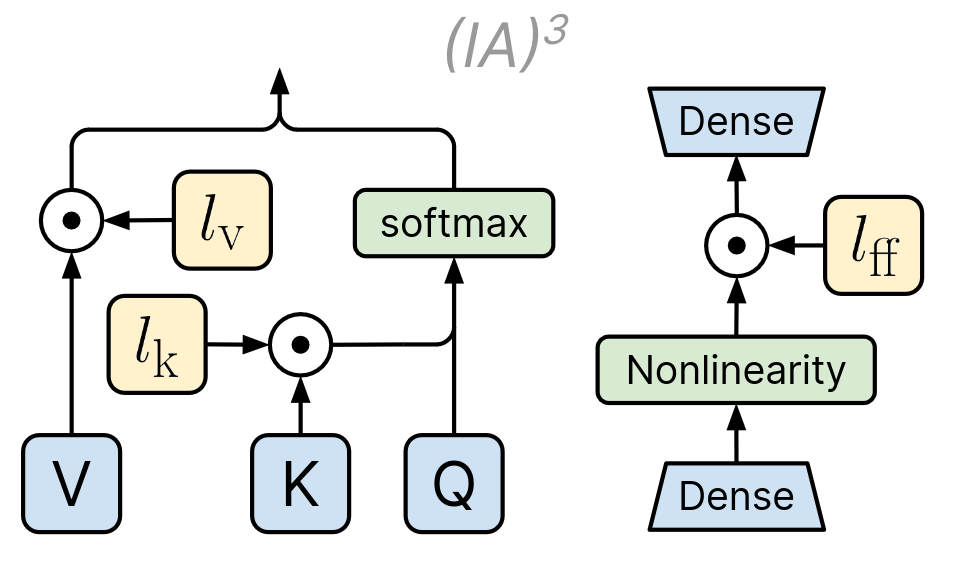
Infused Adapter par inhibition et amplification des activations internes, ou IA3, est une méthode qui ajoute trois vecteurs appris pour redimensionner les clés et les valeurs des couches d'auto-attention et d'attention encodeur-décodeur, ainsi que l'activation intermédiaire du réseau de propagation avant position par position.
L'abstract de l'article est :
L’apprentissage en contexte avec peu d’exemples (Few-shot in-context learning, ICL) permet aux modèles de langage pré-entraînés d’exécuter une tâche inédite sans entraînement par gradient, en fournissant un petit nombre d’exemples d’entraînement comme partie intégrante de l’entrée. L’ICL engendre des coûts de calcul, de mémoire et de stockage considérables, car il implique de traiter tous les exemples d’entraînement à chaque fois qu’une prédiction est effectuée. L’ajustement fin efficace en termes de paramètres (Parameter-efficient fine-tuning, PEFT) (par exemple, modules adaptateurs, ajustement par prompts, méthodes de mise à jour creuse, etc.) offre un paradigme alternatif où un petit ensemble de paramètres est entraîné pour permettre au modèle d’exécuter la nouvelle tâche. Dans cet article, nous comparons rigoureusement l’ICL avec peu d’exemples et le PEFT, et démontrons que ce dernier offre une meilleure précision ainsi que des coûts de calcul nettement inférieurs. Au passage, nous introduisons une nouvelle méthode PEFT appelée (IA)^3 qui met à l’échelle les activations par des vecteurs appris, atteignant des performances supérieures tout en n’ajoutant qu’une quantité relativement faible de nouveaux paramètres. Nous proposons également une recette simple basée sur le modèle T0, appelée T-Few, qui peut être appliquée à de nouvelles tâches sans ajustement spécifique à la tâche ni modifications. Nous validons l’efficacité de T-Few sur des tâches totalement inédites en l’appliquant au benchmark RAFT, atteignant pour la première fois des performances supérieures à celles de l’humain et surpassant l’état de l’art de 6 % en absolu. Tout le code utilisé dans nos expériences est publiquement disponible.
Pour rendre le fine-tuning plus efficace, IA3 (Infused Adapter by Inhibiting and Amplifying Inner Activations) rééchelonne les activations internes à l'aide de vecteurs appris. Ces vecteurs appris sont injectés dans les modules d'attention et de feedforward d'une architecture basée sur un transformer classique. Ces vecteurs appris sont les seuls paramètres entraînables lors du fine-tuning, et les poids d'origine restent donc figés. Le fait de manipuler des vecteurs appris (par opposition à des mises à jour de faible rang d'une matrice de poids, comme avec LoRA) permet de garder le nombre de paramètres entraînables beaucoup plus faible.
De par sa similitude avec LoRA, IA3 présente de nombreux avantages communs :
- IA3 rend le fine-tuning plus efficace en réduisant considérablement le nombre de paramètres entraînables. (Pour T0, un modèle IA3 ne possède que 0,01 % de paramètres entraînables environ, tandis que même LoRA en a > 0,1 %)
- Les poids pré-entraînés d’origine sont maintenus figés, ce qui signifie que vous pouvez disposer de plusieurs modèles IA3 légers et portables pour diverses tâches en aval, construits sur leur base.
- Les performances des modèles affinés à l'aide de IA3 sont comparables à celles des modèles entièrement affinés.
- IA3 n'ajoute aucune latence d'inférence car les poids de l'adaptateur peuvent être fusionnés avec le modèle de base.
En principe, IA3 peut être appliqué à n’importe quel sous-ensemble de matrices de poids d’un réseau de neurones afin de réduire le nombre de paramètres entraînables. Conformément à l’implémentation des auteurs, les poids IA3 sont ajoutés aux couches clé, valeur et feedforward d’un modèle Transformer. Plus précisément, pour les modèles transformer, les poids IA3 sont ajoutés aux sorties des couches clé et valeur, ainsi qu’à l’entrée de la deuxième couche feedforward de chaque bloc transformer.
Étant donné les couches cibles pour l'injection des paramètres IA3, le nombre de paramètres entraîlables peut être déterminé en fonction de la taille des matrices de poids.
Utilisation
Pour les modèles autorégressifs, ciblez
k_proj,v_projetdown_proj— ce sont les couches que les auteurs ont jugées les plus efficaces. Définissezfeedforward_modules=["down_proj"]afin que IA3 sache quelles modules sont des couches feedforward et puisse appliquer le bon échelonnement.
Pour la tâche de classification de séquences, on peut initialiser la configuration IA3 pour un modèle Llama comme suit :
from peft import IA3Config, TaskType, get_peft_model
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("HuggingFaceTB/SmolLM-135M")
peft_config = IA3Config(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["k_proj", "v_proj", "down_proj"],
    feedforward_modules=["down_proj"],
)
model = get_peft_model(model, peft_config)
model.print_healthcheck()
Quand utiliser IA3 plutôt que LoRA
IA3 est particulièrement efficace lorsque vous avez besoin des adaptateurs les plus petits possibles pour des déploiements contraints en stockage, ou lorsque vous souhaitez une convergence rapide avec un nombre réduit de paramètres entraînables. LoRA peut être préférable si vous avez besoin de l’écosystème plus large des variantes de LoRA (DoRA, QLoRA, etc.) ou si vous souhaitez l’approche la plus largement testée, bénéficiant d’un soutien communautaire important.
Aperçu des benchmarks
API
IA3Config
classe peft.IA3Config
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falsetarget_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Nonefeedforward_modules: Optional[Union[list[str], str]] = Nonefan_in_fan_out: bool = Falsemodules_to_save: Optional[list[str]] = Noneinit_ia3_weights: bool = True )
Paramètres
- target_modules (
Optional[Union[List[str], str]]) — Les noms des modules auxquels appliquer l’adaptateur. Si ce paramètre est spécifié, seuls les modules portant les noms indiqués seront remplacés. En cas de chaîne de caractères, une correspondance par expression régulière est effectuée. En cas de liste de chaînes de caractères, une correspondance exacte est réalisée ou il est vérifié si le nom du module se termine par l’une des chaînes fournies. Si la valeur est « all-linear », tous les modules linéaires/Conv1D sont sélectionnés, à l’exception de la couche de sortie. Si ce paramètre n’est pas spécifié, les modules sont choisis en fonction de l’architecture du modèle. Si l’architecture est inconnue, une erreur est levée — dans ce cas, vous devez spécifier manuellement les modules cibles. - exclude_modules (
Optional[Union[List[str], str]]) — Les noms des modules auxquels l’adaptateur ne doit pas être appliqué. Si une chaîne de caractères est transmise, une correspondance par expression régulière est effectuée. Si une liste de chaînes de caractères est transmise, une correspondance exacte est effectuée ou il est vérifié si le nom du module se termine par l’une des chaînes transmises. - feedforward_modules (
Optional[Union[List[str], str]]) — Les noms des modules à traiter comme des modules feedforward, conformément à l’article original. Ces modules verront des vecteurs (IA)³ multipliés à l’entrée, plutôt qu’à la sortie.feedforward_modulesdoit être un nom ou un sous-ensemble de noms présents danstarget_modules. - fan_in_fan_out (
bool) — Définissez cette valeur sur True si la couche à remplacer stocke les poids sous la forme (fan_in, fan_out). Par exemple, gpt-2 utiliseConv1Dqui stocke les poids sous la forme (fan_in, fan_out) et il convient donc de définir cette valeur surTrue. - modules_to_save (
Optional[List[str]]) — Liste des modules, à l'exception des couches (IA)³, à définir comme entraînables et à enregistrer dans le point de contrôle final. - init_ia3_weights (
bool) — Indique s'il faut initialiser les vecteurs des couches (IA)³, par défautTrue. Il est déconseillé de définir cette valeur àFalse.
Ceci est la classe de configuration destinée à stocker la configuration d'un IA3Model.
IA3Model
classe peft.IA3Model
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Paramètres
- model (PreTrainedModel) — Le modèle à adapter.
- config (IA3Config) — La configuration du modèle (IA)^3.
- adapter_name (
str) — Le nom de l'adaptateur, par défaut"default". - low_cpu_mem_usage (
bool,optional, par défautFalse) — Crée des poids d'adaptateurs vides sur l'appareil méta. Utile pour accélérer le processus de chargement.
Retourne
torch.nn.Module
Le modèle (IA)^3.
Crée un modèle Infused Adapter by Inhibiting and Amplifying Inner Activations ((IA)^3) à partir d'un modèle transformers pré-entraîné. La méthode est décrite en détail dans https://huggingface.co/papers/2205.05638
Exemple :
>>> from transformers import AutoModelForSeq2SeqLM
>>> from peft import IA3Config, get_peft_model

>>> config = IA3Config(
...     peft_type="IA3",
...     task_type="SEQ_2_SEQ_LM",
...     target_modules=["k", "v", "w0"],
...     feedforward_modules=["w0"],
... )

>>> model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")
>>> ia3_model = get_peft_model(model, config)
Attributs :
- model (PreTrainedModel) — Le modèle à adapter.
- peft_config (IA3Config) : La configuration du modèle (IA)^3.
add_weighted_adapter
< source >( adapters: list[str]weights: list[float]adapter_name: str )
Cette méthode ajoute un nouvel adaptateur en fusionnant les adaptateurs donnés avec les poids donnés.