
PEFT documentation
IA3
IA3
IA3 是您需要尽可能小的适配器规模时的绝佳选择——它使用学习向量而非低秩矩阵,因此是现有方法中参数效率最高的方法之一。如果您的首要目标是极小的磁盘/内存占用和快速训练,IA3 是一个强有力的候选方案。
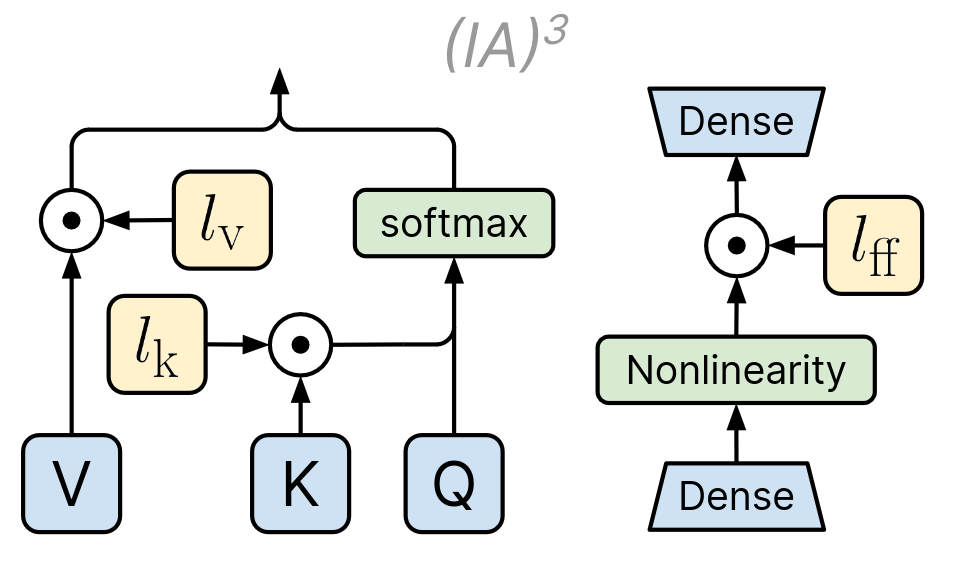
通过抑制和放大内部激活的适配器,即IA3,是一种向自注意力和编码器-解码器注意力层的键与值,以及逐位置前馈网络的中间激活添加三个学习向量以进行重新缩放的方法。
该论文的摘要如下:
少样本上下文学习(ICL)通过提供少量训练示例作为输入的一部分,使预训练语言模型无需任何基于梯度的训练即可执行此前未见过的任务。由于每次进行预测时都需要处理所有训练示例,ICL 会带来巨大的计算、内存和存储开销。参数高效微调(PEFT)(例如适配器模块、提示微调、稀疏更新方法等)提供了一种替代范式,即训练一小部分参数以使模型能够执行新任务。在本文中,我们严格比较了少样本 ICL 和 PEFT,并证明后者不仅具有更高的准确率,而且计算成本大幅降低。在此过程中,我们提出了一种名为 (IA)^3 的新 PEFT 方法,它通过学习的向量对激活值进行缩放,在仅引入相对少量新参数的情况下实现了更强的性能。我们还提出了一种基于 T0 模型的简单方案,称为 T-Few,可以应用于新任务而无需针对特定任务的微调或修改。我们通过在 RAFT 基准上应用 T-Few 来验证其在完全未见过的任务上的有效性,首次实现了超越人类的表现,并比当前最先进的方法高出 6% 的绝对值。我们实验中使用的全部代码均已公开
To make fine-tuning more efficient, IA3 (Infused Adapter by Inhibiting and Amplifying Inner Activations) rescales inner activations with learned vectors. These learned vectors are injected in the attention and feedforward modules in a typical transformer-based architecture. These learned vectors are the only trainable parameters during fine-tuning, and thus the original weights remain frozen. Dealing with learned vectors (as opposed to learned low-rank updates to a weight matrix like LoRA) keeps the number of trainable parameters much smaller.
与 LoRA 类似,IA3 也具有许多相同的优势:
- IA3 通过大幅减少可训练参数的数量,使微调更加高效。(对于 T0,IA3 模型仅包含约 0.01% 的可训练参数,而即使是 LoRA 也超过 0.1%)
- 原始预训练权重保持冻结,这意味着您可以基于这些权重构建多个轻量级且可移植的 IA3 模型,用于各种下游任务。
- 使用 IA3 微调的模型性能与完全微调的模型性能相当。
- IA3 不会增加任何推理延迟,因为适配器权重可以与基础模型合并。
原则上,IA3 可以应用于神经网络中权重矩阵的任意子集,以减少可训练参数的数量。遵循作者的实现方式,IA3 权重被添加到 Transformer 模型的 key、value 和 feedforward 层中。具体而言,对于 transformer 模型,IA3 权重被添加到每个 transformer block 中 key 层和 value 层的输出,以及第二个 feedforward 层的输入。
给定用于注入 IA3 参数的目标层,可以根据权重矩阵的大小确定可训练参数的数量。
用法
对于自回归模型,目标为
k_proj、v_proj和down_proj——这些是作者发现最有效的层。设置feedforward_modules=["down_proj"],以便 IA3 知道哪些模块是前馈层,从而应用正确的缩放。
对于序列分类任务,可以按照以下方式为 Llama 模型初始化 IA3 配置:
from peft import IA3Config, TaskType, get_peft_model
from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("HuggingFaceTB/SmolLM-135M")
peft_config = IA3Config(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["k_proj", "v_proj", "down_proj"],
    feedforward_modules=["down_proj"],
)
model = get_peft_model(model, peft_config)
model.print_healthcheck()
何时使用 IA3 与 LoRA
IA3 在需要尽可能小的适配器以应对存储受限的部署场景,或希望以更少的可训练参数实现快速收敛时尤为有效。如果您需要更广泛的 LoRA 变体生态系统(如 DoRA、QLoRA 等),或希望采用经过最广泛测试且拥有大量社区支持的方法,则 LoRA 可能更为合适。
基准测试概览
API
IA3Config
类 peft.IA3Config
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falsetarget_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Nonefeedforward_modules: Optional[Union[list[str], str]] = Nonefan_in_fan_out: bool = Falsemodules_to_save: Optional[list[str]] = Noneinit_ia3_weights: bool = True )
参数
- target_modules (
Optional[Union[List[str], str]]) — 要应用适配器(adapter)的模块名称。如果指定了此参数,则只有名称匹配的模块会被替换。传入字符串时,将执行正则表达式匹配。传入字符串列表时,将执行精确匹配,或检查模块名称是否以列表中的任一字符串结尾。如果指定为 ‘all-linear’,则选择所有 linear/Conv1D 模块,但不包括输出层。如果未指定,将根据模型架构选择模块。如果架构未知,则会引发错误——在这种情况下,应手动指定目标模块。 - exclude_modules (
Optional[Union[List[str], str]]) — 不应用适配器的模块名称。传入字符串时,将执行正则表达式匹配。传入字符串列表时,将执行精确匹配,或检查模块名称是否以传入的任一字符串结尾。 - feedforward_modules (
Optional[Union[List[str], str]]) — 按照原始论文的定义,被视为前馈模块的模块名称。这些模块将在输入端而非输出端乘以 (IA)³ 向量。feedforward_modules必须是target_modules中存在的名称或名称子集。 - fan_in_fan_out (
bool) — 如果待替换的层以 (fan_in, fan_out) 的形式存储权重,请将此项设置为 True。例如,gpt-2 使用的Conv1D以 (fan_in, fan_out) 的形式存储权重,因此应将其设置为True。 - modules_to_save (
Optional[List[str]]) — 除 (IA)³ 层外,需要设置为可训练并在最终检查点中保存的模块列表。 - init_ia3_weights (
bool) — 是否初始化 (IA)³ 层中的向量,默认为True。不建议将其设置为False。
这是用于存储 IA3Model 配置的类。
IA3Model
类 peft.IA3Model
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
参数
- model (PreTrainedModel) — 要适配的模型。
- config (IA3Config) — (IA)^3 模型的配置。
- adapter_name (
str) — 适配器的名称,默认为"default"。 - low_cpu_mem_usage (
bool,optional, defaults toFalse) — 在 meta 设备上创建空的适配器权重。有助于加快加载过程。
返回值
torch.nn.Module
(IA)^3 模型。
从预训练的 transformers 模型创建一个通过抑制和放大内部激活((IA)^3)的 Infused Adapter 模型。该方法的详细描述见 https://huggingface.co/papers/2205.05638
示例:
>>> from transformers import AutoModelForSeq2SeqLM
>>> from peft import IA3Config, get_peft_model

>>> config = IA3Config(
...     peft_type="IA3",
...     task_type="SEQ_2_SEQ_LM",
...     target_modules=["k", "v", "w0"],
...     feedforward_modules=["w0"],
... )

>>> model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")
>>> ia3_model = get_peft_model(model, config)属性:
- model (PreTrainedModel) — 要适配的模型。
- peft_config (IA3Config): (IA)^3 模型的配置。
add_weighted_adapter
< source >( adapters: list[str]weights: list[float]adapter_name: str )
此方法通过按给定权重合并指定的适配器来添加一个新的适配器。