
Transformers documentation
FastSpeech2Conformer
Este modelo se publicó en HF papers el 26-10-2020 y se contribuyó a Hugging Face Transformers el 03-01-2024.
FastSpeech2Conformer
Resumen
El modelo FastSpeech2Conformer fue propuesto en el artículo Recent Developments On Espnet Toolkit Boosted By Conformer de Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang y Yuekai Zhang.
El resumen del artículo original de FastSpeech2 es el siguiente:
Los modelos de texto a voz (TTS) no autorregresivos, como FastSpeech (Ren et al., 2019), pueden sintetizar voz de manera significativamente más rápida que los modelos autorregresivos anteriores, con una calidad comparable. El entrenamiento del modelo FastSpeech depende de un modelo maestro autorregresivo para la predicción de duración (para proporcionar más información como entrada) y la destilación de conocimiento (para simplificar la distribución de datos en la salida), lo que puede aliviar el problema de mapeo uno a muchos (es decir, múltiples variaciones de voz corresponden al mismo texto) en TTS. Sin embargo, FastSpeech tiene varias desventajas: 1) el pipeline de destilación maestro-estudiante es complicado y consume mucho tiempo, 2) la duración extraída del modelo maestro no es lo suficientemente precisa, y los mel-espectrogramas objetivo destilados del modelo maestro sufren de pérdida de información debido a la simplificación de datos, ambos factores limitan la calidad de la voz. En este artículo, proponemos FastSpeech 2, que aborda los problemas de FastSpeech y resuelve mejor el problema de mapeo uno a muchos en TTS mediante 1) el entrenamiento directo del modelo con el objetivo real en lugar de la salida simplificada del maestro, y 2) la introducción de más información de variación de la voz (p. ej., tono, energía y duración más precisa) como entradas condicionales. Específicamente, extraemos la duración, el tono y la energía de la forma de onda de la voz y los tomamos directamente como entradas condicionales en el entrenamiento, y usamos valores predichos en la inferencia. Además, diseñamos FastSpeech 2s, que es el primer intento de generar directamente la forma de onda de la voz a partir del texto en paralelo, disfrutando del beneficio de una inferencia totalmente de extremo a extremo. Los resultados experimentales muestran que 1) FastSpeech 2 logra una aceleración de entrenamiento 3 veces mayor que FastSpeech, y FastSpeech 2s disfruta de una velocidad de inferencia aún más rápida; 2) FastSpeech 2 y 2s superan a FastSpeech en calidad de voz, y FastSpeech 2 incluso puede superar a los modelos autorregresivos. Las muestras de audio están disponibles en https://speechresearch.github.io/fastspeech2/.
Este modelo fue aportado por Connor Henderson. El código original se puede encontrar aquí.
🤗 Arquitectura del modelo
Se implementó la estructura general de FastSpeech2 con un decodificador de Mel-espectrograma, y los bloques de transformer tradicionales se reemplazaron con bloques conformer, tal como se hace en la biblioteca ESPnet.
Arquitectura del modelo FastSpeech2

Bloques Conformer

Módulo de convolución
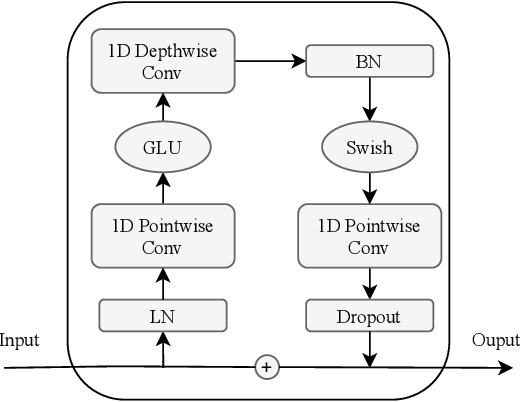
Uso de 🤗 Transformers
Puedes ejecutar FastSpeech2Conformer localmente con la biblioteca 🤗 Transformers.
- Primero instala la biblioteca Transformers de 🤗, g2p-en:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Ejecuta la inferencia mediante el código de modelado de Transformers con el modelo y hifigan por separado
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Ejecuta la inferencia mediante el código de modelado de Transformers con el modelo y hifigan combinados
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Ejecuta la inferencia con un pipeline y especifica qué vocoder usar
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
clase transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Parámetros
- is_encoder_decoder (
bool, opcional, valor predeterminadoTrue) — Indica si el modelo se utiliza como codificador/decodificador o no. - hidden_size (
int, opcional, valor predeterminado384) — Dimensión de las representaciones ocultas. - vocab_size (
int, opcional, valor predeterminado78) — Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse medianteinput_ids. - num_mel_bins (
int, opcional, valor predeterminado80) — Número de características mel utilizadas por cada cuadro de entrada. Debe corresponder al valor utilizado en la claseAutoFeatureExtractor. - encoder_num_attention_heads (
int, opcional, valor predeterminado 2) — El número de cabezas de atención en el codificador. - encoder_layers (
int, opcional, valor predeterminado4) — Número de capas ocultas en el codificador del Transformer. Usará el mismo valor quenum_layerssi no se establece. - encoder_linear_units (
int, opcional, valor predeterminado 1536) — El número de unidades en la capa lineal del codificador. - decoder_layers (
int, opcional, valor predeterminado4) — Número de capas ocultas en el decodificador del Transformer. Si no se establece, se usará el mismo valor quenum_layers. - decoder_num_attention_heads (
int, opcional, valor predeterminado2) — Número de cabezas de atención para cada capa de atención en el decodificador del Transformer. - decoder_linear_units (
int, opcional, valor predeterminado 1536) — El número de unidades en la capa lineal del decodificador. - speech_decoder_postnet_layers (
int, opcional, valor predeterminado 5) — El número de capas en la post-red del decodificador de voz. - speech_decoder_postnet_units (
int, opcional, valor predeterminado 256) — El número de unidades en las capas post-net del decodificador de voz. - speech_decoder_postnet_kernel (
int, opcional, valor predeterminado 5) — El tamaño del kernel en la post-red del decodificador de voz. - positionwise_conv_kernel_size (
int, opcional, valor predeterminado 3) — El tamaño del núcleo de convolución utilizado en la capa posicional. - encoder_normalize_before (
bool, opcional, valor predeterminadoFalse) — Especifica si se debe normalizar antes de las capas del codificador. - decoder_normalize_before (
bool, opcional, valor predeterminadoFalse) — Especifica si se debe normalizar antes de las capas del decodificador. - encoder_concat_after (
bool, opcional, valor predeterminadoFalse) — Especifica si se debe concatenar después de las capas del codificador. - decoder_concat_after (
bool, opcional, valor predeterminadoFalse) — Especifica si se debe concatenar después de las capas del decodificador. - reduction_factor (
int, opcional, valor predeterminado 1) — El factor por el cual se reduce la tasa de fotogramas de voz. - speaking_speed (
float, opcional, valor predeterminado 1.0) — La velocidad del habla producida. - use_macaron_style_in_conformer (
bool, opcional, valor predeterminadoTrue) — Especifica si se debe usar el estilo macaron en el conformer. - use_cnn_in_conformer (
bool, opcional, valor predeterminadoTrue) — Especifica si se deben usar redes neuronales convolucionales en el conformer. - encoder_kernel_size (
int, opcional, valor predeterminado 7) — El tamaño del kernel utilizado en el codificador. - decoder_kernel_size (
int, opcional, valor predeterminado 31) — El tamaño del kernel utilizado en el decodificador. - duration_predictor_layers (
int, opcional, valor predeterminado 2) — El número de capas en el predictor de duración. - duration_predictor_channels (
int, opcional, valor predeterminado 256) — El número de canales en el predictor de duración. - duration_predictor_kernel_size (
int, opcional, valor predeterminado 3) — El tamaño del kernel utilizado en el predictor de duración. - energy_predictor_layers (
int, opcional, valor predeterminado 2) — El número de capas en el predictor de energía. - energy_predictor_channels (
int, opcional, valor predeterminado 256) — El número de canales en el predictor de energía. - energy_predictor_kernel_size (
int, opcional, valor predeterminado 3) — El tamaño del kernel utilizado en el predictor de energía. - energy_predictor_dropout (
float, opcional, valor predeterminado 0.5) — La tasa de dropout en el predictor de energía. - energy_embed_kernel_size (
int, opcional, valor predeterminado 1) — El tamaño del kernel utilizado en la capa de incrustación de energía. - energy_embed_dropout (
float, opcional, valor predeterminado 0.0) — La tasa de dropout en la capa de energía embebida. - stop_gradient_from_energy_predictor (
bool, opcional, valor predeterminadoFalse) — Especifica si se deben detener los gradientes desde el predictor de energía. - pitch_predictor_layers (
int, opcional, valor predeterminado 5) — El número de capas en el predictor de tono. - pitch_predictor_channels (
int, opcional, valor predeterminado 256) — El número de canales en el predictor de tono. - pitch_predictor_kernel_size (
int, opcional, valor predeterminado 5) — El tamaño del kernel utilizado en el predictor de tono. - pitch_predictor_dropout (
float, opcional, valor predeterminado 0.5) — La tasa de dropout en el predictor de tono. - pitch_embed_kernel_size (
int, opcional, valor predeterminado 1) — El tamaño del kernel utilizado en la capa de pitch embed. - pitch_embed_dropout (
float, opcional, valor predeterminado 0.0) — La tasa de dropout en la capa de pitch embed. - stop_gradient_from_pitch_predictor (
bool, opcional, valor predeterminadoTrue) — Especifica si se detienen los gradientes del predictor de tono. - encoder_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout en el codificador. - encoder_positional_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout posicional en el codificador. - encoder_attention_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout de la atención en el codificador. - decoder_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout en el decodificador. - decoder_positional_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout posicional en el decodificador. - decoder_attention_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout de la atención en el decodificador. - duration_predictor_dropout_rate (
float, opcional, valor predeterminado 0.2) — La tasa de dropout en el predictor de duración. - speech_decoder_postnet_dropout (
float, opcional, valor predeterminado 0.5) — La tasa de dropout en la postnet del decodificador de voz. - max_source_positions (
int, opcional, valor predeterminado 5000) — si se usan embeddings de posición"relative", define las posiciones de entrada de origen máximas. - use_masking (
bool, opcional, valor predeterminadoTrue) — Especifica si se debe usar enmascaramiento en el modelo. - use_weighted_masking (
bool, opcional, valor predeterminadoFalse) — Especifica si se debe usar enmascarado ponderado en el modelo. - num_speakers (
int, opcional) — Número de hablantes. Si se establece en > 1, se asume que los ids de hablante se proporcionarán como entrada y se usará la capa de embedding de id de hablante. - num_languages (
int, opcional) — Número de idiomas. Si se establece en > 1, se asume que los ids de idioma se proporcionarán como entrada y se usará la capa de embedding de id de idioma. - speaker_embed_dim (
int, opcional) — Dimensión de la incrustación del hablante. Si se establece en > 0, se asume que speaker_embedding se proporcionará como entrada. - convolution_bias (
bool, opcional, valor predeterminadoTrue) — Especifica si se debe usar sesgo en las convoluciones del módulo de convolución del conformer.
Esta es la clase de configuración para almacenar la configuración de un FastSpeech2ConformerModel. Se utiliza para instanciar un modelo Fastspeech2 Conformer según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de espnet/fastspeech2_conformer
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
clase transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Parámetros
- model_in_dim (
int, opcional, valor predeterminado 80) — El número de bandas de frecuencia en el espectrograma log-mel de entrada. - upsample_initial_channel (
int, opcional, valor predeterminado 512) — El número de canales de entrada de la red de remuestreo ascendente. - upsample_rates (
tuple[int]olist[int], opcional, valor predeterminado[8, 8, 2, 2]) — Una tupla de enteros que define el paso de cada capa convolucional 1D en la red de remuestreo ascendente. La longitud de upsample_rates define el número de capas convolucionales y debe coincidir con la longitud de upsample_kernel_sizes. - upsample_kernel_sizes (
tuple[int]olist[int], opcional, valor predeterminado[16, 16, 4, 4]) — Una tupla de enteros que define el tamaño del kernel de cada capa convolucional 1D en la red de remuestreo ascendente. La longitud de upsample_kernel_sizes define el número de capas convolucionales y debe coincidir con la longitud de upsample_rates. - resblock_kernel_sizes (
tuple[int]olist[int], opcional, valor predeterminado[3, 7, 11]) — Una tupla de enteros que define los tamaños de los núcleos de las capas convolucionales 1D en el módulo de fusión de campos receptivos múltiples (MRF). - resblock_dilation_sizes (
tuple[tuple[int]]olist[list[int]], opcional, valor predeterminado[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Una tupla anidada de enteros que define las tasas de dilatación de las capas de convolución 1D dilatada en el módulo de fusión de campos receptivos múltiples (MRF). - initializer_range (
float, opcional, valor predeterminado0.01) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - leaky_relu_slope (
float, opcional, valor predeterminado 0.1) — El ángulo de la pendiente negativa utilizada por la activación leaky ReLU. - normalize_before (
bool, opcional, valor predeterminadoTrue) — Indica si se debe normalizar el espectrograma antes de la vocodificación, utilizando la media y la varianza aprendidas por el vocoder.
Esta es la clase de configuración para almacenar la configuración de un FastSpeech2ConformerModel. Se utiliza para instanciar un modelo Fastspeech2 Conformer según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de espnet/fastspeech2_conformer_with_hifigan
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
clase transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Esta es la clase de configuración para almacenar la configuración de un FastSpeech2ConformerModel. Se utiliza para instanciar un modelo Fastspeech2 Conformer según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de espnet/fastspeech2_conformer_with_hifigan
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
clase transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Parámetros
- vocab_file (
str) — Ruta al archivo de vocabulario. - bos_token (
str, opcional, valor predeterminado"<sos/eos>") — El token de inicio de secuencia. Tenga en cuenta que, en FastSpeech2, es el mismo que eleos_token. - eos_token (
str, opcional, valor predeterminado"<sos/eos>") — El token de fin de secuencia. Tenga en cuenta que, para FastSpeech2, es el mismo que elbos_token. - pad_token (
str, opcional, valor predeterminado"<blank>") — El token utilizado para el relleno, por ejemplo, al agrupar secuencias de diferentes longitudes. - unk_token (
str, opcional, valor predeterminado"<unk>") — El token desconocido. Un token que no está en el vocabulario no se puede convertir en un ID y se establece como este token en su lugar. - should_strip_spaces (
bool, opcional, valor predeterminadoFalse) — Indica si se deben eliminar los espacios de la lista de tokens.
Construya un tokenizador FastSpeech2Conformer.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Parámetros
- text (
str,list[str],list[list[str]], opcional) — La secuencia o lote de secuencias que se codificarán. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadenas pre-tokenizadas). Si las secuencias se proporcionan como lista de cadenas de caracteres (pre-tokenizadas), debe estableceris_split_into_words=True(para eliminar la ambigüedad con un lote de secuencias). - text_pair (
str,list[str],list[list[str]], opcional) — La secuencia o lote de secuencias que se codificarán. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadena pre-tokenizada). Si las secuencias se proporcionan como lista de cadenas de caracteres (pre-tokenizadas), debe estableceris_split_into_words=True(para eliminar la ambigüedad con un lote de secuencias). - text_target (
str,list[str],list[list[str]], opcional) — La secuencia o lote de secuencias que se codificarán como textos objetivo. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadena pretokenizada). Si las secuencias se proporcionan como lista de cadenas de caracteres (pretokenizadas), debe estableceris_split_into_words=True(para eliminar la ambigüedad con un lote de secuencias). - text_pair_target (
str,list[str],list[list[str]], opcional) — La secuencia o lote de secuencias que se codificarán como textos objetivo. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadena pretokenizada). Si las secuencias se proporcionan como lista de cadenas de caracteres (pretokenizadas), debe estableceris_split_into_words=True(para eliminar la ambigüedad con un lote de secuencias). - tokenizer_kwargs (
dict[str, Any], opcional) — Kwargs adicionales para pasar al tokenizer. Se fusionarán con los parámetros explícitos y otros kwargs, dando prioridad a los parámetros explícitos. - add_special_tokens (
bool, opcional, valor predeterminadoTrue) — Indica si se deben o no añadir tokens especiales al codificar las secuencias. Esto utilizará la función subyacentePretrainedTokenizerBase.build_inputs_with_special_tokens, que define qué tokens se añaden automáticamente a los ids de entrada. Esto es útil si deseas añadir tokensbosoeosautomáticamente. - padding (
bool,stro PaddingStrategy, opcional, el valor predeterminado esFalse) — Activa y controla el relleno. Acepta los siguientes valores:Trueo'longest': Rellena hasta la secuencia más larga del lote (o no aplica relleno si solo se proporciona una secuencia).'max_length': Rellena hasta una longitud máxima especificada con el argumentomax_lengtho hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento.Falseo'do_not_pad'(predeterminado): Sin relleno (es decir, puede generar un lote con secuencias de diferentes longitudes).
- truncation (
bool,stro TruncationStrategy, opcional, por defectoFalse) — Activa y controla la truncación. Acepta los siguientes valores:Trueo'longest_first': Trunca hasta una longitud máxima especificada con el argumentomax_lengtho hasta la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto truncará token a token, eliminando un token de la secuencia más larga de la pareja si se proporciona una pareja de secuencias (o un lote de parejas).'only_first': Trunca a una longitud máxima especificada con el argumentomax_lengtho a la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la primera secuencia de un par si se proporciona un par de secuencias (o un lote de pares).'only_second': Trunca a una longitud máxima especificada con el argumentomax_lengtho a la longitud de entrada máxima aceptable para el modelo si no se proporciona dicho argumento. Esto solo truncará la segunda secuencia de un par si se proporciona un par de secuencias (o un lote de pares).Falseo'do_not_truncate'(predeterminado): sin truncamiento (es decir, se puede generar un lote con longitudes de secuencia mayores que el tamaño máximo de entrada admisible por el modelo).
- max_length (
int, opcional) — Controla la longitud máxima que se utilizará mediante uno de los parámetros de truncamiento/relleno.Si se deja sin definir o se establece en
None, se utilizará la longitud máxima predefinida del modelo si uno de los parámetros de truncamiento/relleno lo requiere. Si el modelo no tiene una longitud máxima de entrada específica (como XLNet), el truncamiento/relleno a una longitud máxima se desactivará. - stride (
int, opcional, valor predeterminado 0) — Si se establece en un número junto conmax_length, los tokens de desbordamiento devueltos cuandoreturn_overflowing_tokens=Truecontendrán algunos tokens del final de la secuencia truncada devuelta para proporcionar cierta superposición entre las secuencias truncadas y las de desbordamiento. El valor de este argumento define el número de tokens superpuestos. - is_split_into_words (
bool, opcional, valor predeterminadoFalse) — Indica si la entrada ya está pretokenizada (por ejemplo, dividida en palabras). Si se establece enTrue, el tokenizador asume que la entrada ya está dividida en palabras (por ejemplo, dividiéndola por espacios en blanco) y las tokenizará. Esto es útil para NER o clasificación de tokens. - pad_to_multiple_of (
int, opcional) — Si se establece, se rellenará la secuencia hasta un múltiplo del valor proporcionado. Requiere quepaddingesté activado. Esto es especialmente útil para habilitar el uso de Tensor Cores en hardware de NVIDIA con capacidad de cálculo>= 7.5(Volta). - padding_side (
str, opcional) — El lado en el que el modelo debe aplicar el relleno. Debe seleccionarse entre [‘right’, ‘left’]. El valor predeterminado se elige a partir del atributo de clase con el mismo nombre. - return_tensors (
stro TensorType, opcional) — Si se establece, devolverá tensores en lugar de una lista de enteros de Python. Los valores aceptables son:'pt': Devuelve objetostorch.Tensorde PyTorch.'np': Devuelve objetos Numpynp.ndarray.
- return_token_type_ids (
bool, opcional) — Si se deben devolver los IDs de tipo de token. Si se deja en el valor predeterminado, se devolverán los IDs de tipo de token según el valor predeterminado del tokenizador específico, definido por elreturn_outputsatributo. - return_attention_mask (
bool, opcional) — Si se debe devolver la máscara de atención. Si se deja en el valor predeterminado, se devolverá la máscara de atención según el valor predeterminado del tokenizador específico, definido por elreturn_outputsatributo. - return_overflowing_tokens (
bool, opcional, valor predeterminadoFalse) — Indica si se deben devolver las secuencias de tokens que exceden el límite. Si se proporciona un par de secuencias de ids de entrada (o un lote de pares) contruncation_strategy = longest_firstoTrue, se genera un error en lugar de devolver los tokens que exceden el límite. - return_special_tokens_mask (
bool, opcional, valor predeterminadoFalse) — Indica si se debe o no devolver información de la máscara de tokens especiales. - return_offsets_mapping (
bool, opcional, por defectoFalse) — Si se devuelve o no(char_start, char_end)para cada token.Esto solo está disponible en los tokenizadores rápidos que heredan de PreTrainedTokenizerFast; si se utiliza el tokenizador de Python, este método lanzará
NotImplementedError. - return_length (
bool, opcional, valor predeterminadoFalse) — Indica si se deben devolver las longitudes de las entradas codificadas. - verbose (
bool, opcional, valor predeterminadoTrue) — Si se imprime más información y advertencias. - **kwargs — se pasan al método
self.tokenize()
Devuelve
Un BatchEncoding con los siguientes campos:
-
input_ids — Lista de ids de tokens que se enviarán a un modelo.
-
token_type_ids — Lista de ids de tipo de token que se enviarán a un modelo (cuando
return_token_type_ids=Trueo si “token_type_ids” está enself.model_input_names). -
attention_mask — Lista de índices que especifica qué tokens deben ser atendidos por el modelo (cuando
return_attention_mask=Trueo si “attention_mask” está enself.model_input_names). -
overflowing_tokens — Lista de secuencias de tokens que exceden el límite (cuando se especifica un
max_lengthyreturn_overflowing_tokens=True). -
num_truncated_tokens — Número de tokens truncados (cuando se especifica un
max_lengthyreturn_overflowing_tokens=True). -
special_tokens_mask — Lista de 0 y 1, donde 1 especifica los tokens especiales añadidos y 0 especifica los tokens regulares de la secuencia (cuando
add_special_tokens=Trueyreturn_special_tokens_mask=True). -
length — La longitud de las entradas (cuando
return_length=True)
Método principal para tokenizar y preparar para el modelo una o varias secuencias o uno o varios pares de secuencias.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Guarde el archivo de vocabulario y tokens especiales en un directorio.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Parámetros
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Lista de ids de entrada tokenizados. Se puede obtener usando el método__call__. - skip_special_tokens (
bool, opcional, valor predeterminadoFalse) — Indica si se deben eliminar los tokens especiales durante la decodificación. - clean_up_tokenization_spaces (
bool, opcional) — Si se deben limpiar los espacios de tokenización. Si esNone, se usará por defectoself.clean_up_tokenization_spaces. - kwargs (argumentos de palabra clave adicionales, opcional) — Se pasará al método de decodificación específico del modelo subyacente.
Devuelve
list[str]
La lista de oraciones decodificadas.
Convierta una lista de listas de ids de tokens en una lista de cadenas de texto llamando a decode.
Este método se proporciona por compatibilidad con versiones anteriores. El método decode ahora maneja la entrada por lotes de forma nativa,
por lo que puede usar decode directamente en lugar de batch_decode.
FastSpeech2ConformerModel
clase transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Parámetros
- config (FastSpeech2ConformerConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
Modelo FastSpeech2Conformer.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parámetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length)) — Secuencia de entrada de vectores de texto. - attention_mask (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de máscara seleccionados en[0, 1]:- 1 para los tokens que no están enmascarados,
- 0 para los tokens que están enmascarados.
- spectrogram_labels (
torch.Tensorde forma(batch_size, max_spectrogram_length, num_mel_bins), opcional, valor predeterminadoNone) — Lote de características objetivo rellenas. - duration_labels (
torch.LongTensorde forma(batch_size, sequence_length + 1), opcional, valor predeterminadoNone) — Lote de duraciones rellenas. - pitch_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, valor predeterminadoNone) — Lote de tono promedio por token con relleno. - energy_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, valor predeterminadoNone) — Lote de energía promedio por token con relleno. - speaker_ids (
torch.LongTensorde forma(batch_size, 1), opcional, valor predeterminadoNone) — Identificadores de hablante utilizados para condicionar las características de la salida de voz del modelo. - lang_ids (
torch.LongTensorde forma(batch_size, 1), opcional, valor predeterminadoNone) — Identificadores de idioma utilizados para condicionar las características de la salida de voz del modelo. - speaker_embedding (
torch.Tensorde forma(batch_size, embedding_dim), opcional, valor predeterminadoNone) — Incrustado que contiene señales de condicionamiento para las características del habla. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple. - output_attentions (
bool, opcional) — Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulteattentionsen los tensores devueltos para obtener más detalles. - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles.
Devuelve
FastSpeech2ConformerModelOutput o tuple(torch.Tensor)
Un FastSpeech2ConformerModelOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (FastSpeech2ConformerConfig) y las entradas.
El método forward de FastSpeech2ConformerModel reemplaza el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, se devuelve cuando se proporcionalabels) — Pérdida de generación de espectrograma.espectrograma (
torch.Tensorde forma(batch_size, sequence_length, num_bins), opcional) — El espectrograma predicho.encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Secuencia de estados ocultos en la salida de la última capa del codificador del modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del codificador en la salida de cada capa más las salidas de la incrustación inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención del codificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
decoder_hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del decodificador en la salida de cada capa más las salidas de la incrustación inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
duration_outputs (
torch.LongTensorde forma(batch_size, max_text_length + 1), opcional) — Salidas del predictor de duración.pitch_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Salidas del predictor de tono.energy_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Salidas del predictor de energía.
Ejemplo:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
clase transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Parámetros
- config (FastSpeech2ConformerHifiGanConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
Vocoder HiFi-GAN.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Parámetros
- spectrogram (
torch.Tensor) — Tensor que contiene los espectrogramas log-mel. Puede estar agrupado y tener forma(batch_size, sequence_length, config.model_in_dim), o no estar agrupado y tener forma(sequence_length, config.model_in_dim).
Devuelve
torch.Tensor
Tensor que contiene la forma de onda del habla. Si el espectrograma de entrada está agrupado, tendrá la forma (batch_size, num_frames,). Si no está agrupado, tendrá la forma (num_frames,).
Convierte un espectrograma log-mel en una forma de onda de voz. Al pasar un lote de espectrogramas log-mel, devuelve un lote de formas de onda de voz. Al pasar un espectrograma log-mel individual, sin lote, devuelve una forma de onda de voz individual, sin lote.
FastSpeech2ConformerWithHifiGan
clase transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Parámetros
- config (FastSpeech2ConformerWithHifiGanConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El FastSpeech2ConformerModel con una cabeza de vocoder FastSpeech2ConformerHifiGan que realiza la conversión de texto a voz (forma de onda).
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parámetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length)) — Secuencia de entrada de vectores de texto. - attention_mask (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de máscara seleccionados en[0, 1]:- 1 para los tokens que no están enmascarados,
- 0 para los tokens que están enmascarados.
- spectrogram_labels (
torch.Tensorde forma(batch_size, max_spectrogram_length, num_mel_bins), opcional, valor predeterminadoNone) — Lote de características objetivo rellenas. - duration_labels (
torch.LongTensorde forma(batch_size, sequence_length + 1), opcional, valor predeterminadoNone) — Lote de duraciones rellenas. - pitch_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, valor predeterminadoNone) — Lote de tono promedio por token con relleno. - energy_labels (
torch.Tensorde forma(batch_size, sequence_length + 1, 1), opcional, valor predeterminadoNone) — Lote de energía promedio por token con relleno. - speaker_ids (
torch.LongTensorde forma(batch_size, 1), opcional, valor predeterminadoNone) — Identificadores de hablante utilizados para condicionar las características de la salida de voz del modelo. - lang_ids (
torch.LongTensorde forma(batch_size, 1), opcional, valor predeterminadoNone) — Identificadores de idioma utilizados para condicionar las características de la salida de voz del modelo. - speaker_embedding (
torch.Tensorde forma(batch_size, embedding_dim), opcional, valor predeterminadoNone) — Incrustado que contiene señales de condicionamiento para las características del habla. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple. - output_attentions (
bool, opcional) — Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulteattentionsen los tensores devueltos para obtener más detalles. - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles.
Devuelve
FastSpeech2ConformerModelOutput o tuple(torch.Tensor)
Un FastSpeech2ConformerModelOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (FastSpeech2ConformerConfig) y las entradas.
El método forward de FastSpeech2ConformerWithHifiGan sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, se devuelve cuando se proporcionalabels) — Pérdida de generación de espectrograma.espectrograma (
torch.Tensorde forma(batch_size, sequence_length, num_bins), opcional) — El espectrograma predicho.encoder_last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Secuencia de estados ocultos en la salida de la última capa del codificador del modelo.encoder_hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del codificador en la salida de cada capa más las salidas de la incrustación inicial.
encoder_attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención del codificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
decoder_hidden_states (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del decodificador en la salida de cada capa más las salidas de la incrustación inicial.
decoder_attentions (
tuple[torch.Tensor], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
duration_outputs (
torch.LongTensorde forma(batch_size, max_text_length + 1), opcional) — Salidas del predictor de duración.pitch_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Salidas del predictor de tono.energy_outputs (
torch.Tensorde forma(batch_size, max_text_length + 1, 1), opcional) — Salidas del predictor de energía.
Ejemplo:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])