
Transformers documentation
SAM
Este modelo se publicó en HF papers el 2023-04-05 y se contribuyó a Hugging Face Transformers el 2023-04-19.
SAM
Resumen
SAM (Segment Anything Model) fue propuesto en Segment Anything por Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick.
El modelo se puede utilizar para predecir máscaras de segmentación de cualquier objeto de interés a partir de una imagen de entrada.
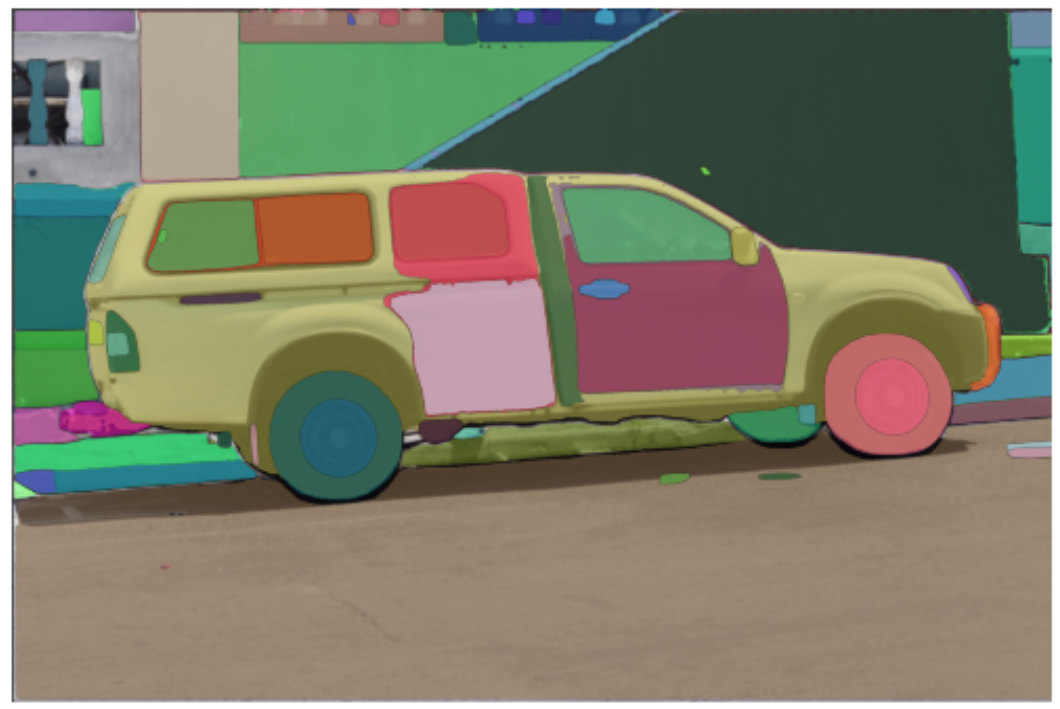
El resumen del artículo es el siguiente:
Presentamos el proyecto Segment Anything (SA): una nueva tarea, un modelo y un conjunto de datos para la segmentación de imágenes. Utilizando nuestro modelo eficiente en un bucle de recopilación de datos, construimos el mayor conjunto de datos de segmentación hasta la fecha (con diferencia), con más de 1.000 millones de máscaras en 11 millones de imágenes con licencia y que respetan la privacidad. El modelo está diseñado y entrenado para ser activable mediante prompts, por lo que puede transferirse de forma zero-shot a nuevas distribuciones de imágenes y tareas. Evaluamos sus capacidades en numerosas tareas y descubrimos que su rendimiento zero-shot es impresionante: a menudo es competitivo o incluso superior a los resultados totalmente supervisados anteriores. Publicamos el Segment Anything Model (SAM) y el conjunto de datos correspondiente (SA-1B) de 1.000 millones de máscaras y 11 millones de imágenes en https://segment-anything.com para fomentar la investigación en modelos de base para la visión por computadora.
Consejos:
- El modelo predice máscaras binarias que indican la presencia o ausencia del objeto de interés a partir de una imagen.
- El modelo predice resultados mucho mejores si se proporcionan puntos 2D de entrada y/o cajas delimitadoras de entrada
- Puedes indicar varios puntos para la misma imagen y predecir una sola máscara.
- El ajuste fino del modelo aún no está admitido
- Según el artículo, también debería admitirse la entrada de texto. Sin embargo, a la fecha de redacción de este texto, parece que no se admite, según el repositorio oficial.
Este modelo fue aportado por ybelkada y ArthurZ. El código original se puede encontrar aquí.
A continuación se muestra un ejemplo de cómo ejecutar la generación de máscaras a partir de una imagen y un punto 2D:
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
También puedes procesar tus propias máscaras junto con las imágenes de entrada en el procesador para pasarlas al modelo.
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con SAM.
- Cuaderno de demostración para usar el modelo.
- Cuaderno de demostración para usar el pipeline de generación automática de máscaras.
- Cuaderno de demostración para inferencia con MedSAM, una versión ajustada de SAM para el dominio médico. 🌎
- Cuaderno de demostración para el ajuste fino del modelo con datos personalizados. 🌎
SlimSAM
SlimSAM, una versión podada de SAM, fue propuesta en 0.1% Data Makes Segment Anything Slim por Zigeng Chen et al. SlimSAM reduce considerablemente el tamaño de los modelos de SAM manteniendo el mismo rendimiento.
Los puntos de control se pueden encontrar en el hub y se pueden usar como un reemplazo directo de SAM.
Grounded SAM
Se puede combinar Grounding DINO con SAM para la generación de máscaras basadas en texto, tal como se introduce en Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks. Puede consultar este cuaderno de demostración 🌍 para más detalles.
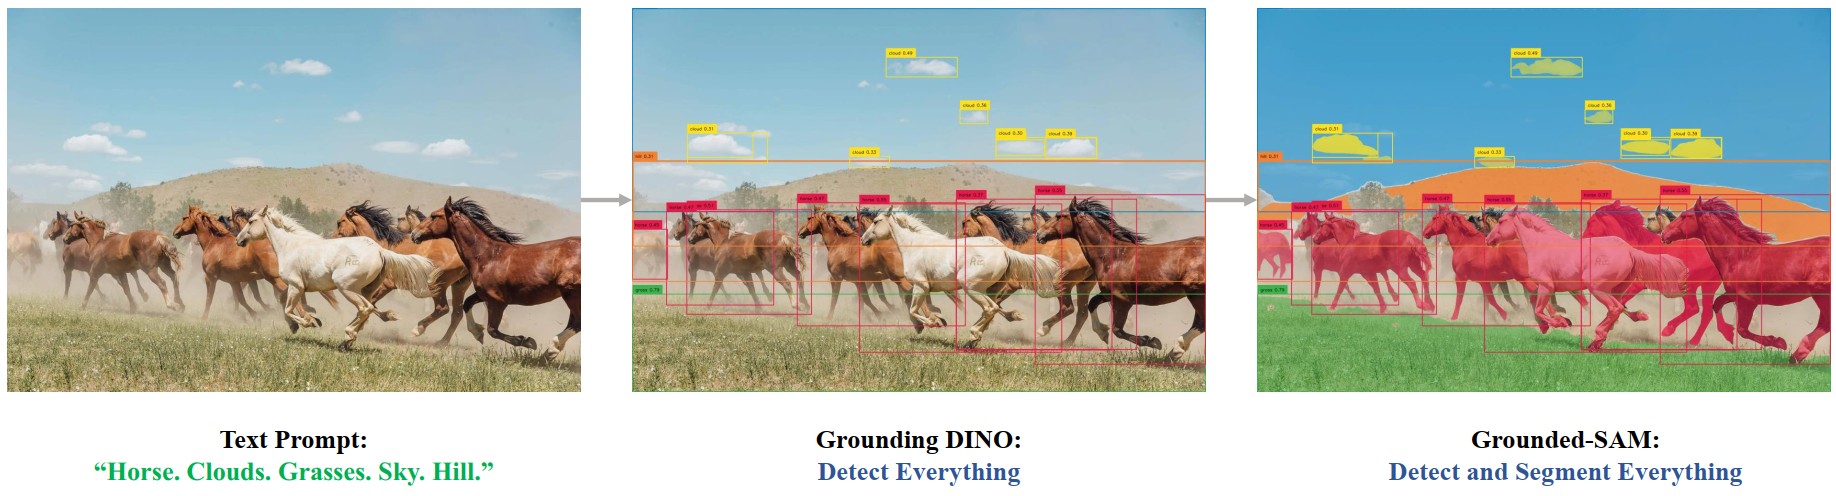 Grounded SAM overview. Taken from the original repository.
SamConfig
clase transformers.SamConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
Parámetros
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — El objeto de configuración o el diccionario del backbone de visión. - prompt_encoder_config (Union[
dict,SamPromptEncoderConfig], opcional) — Diccionario de opciones de configuración utilizado para inicializar SamPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamMaskDecoderConfig], opcional) — Diccionario de opciones de configuración utilizado para inicializar SamMaskDecoderConfig. - initializer_range (
float, opcional, valor predeterminado0.02) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - tie_word_embeddings (
bool, opcional, valor predeterminadoTrue) — Si se deben vincular las matrices de pesos de embeddings según el mapeotied_weights_keysdel modelo.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de facebook/sam-vit-huge
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import (
...     SamVisionConfig,
...     SamPromptEncoderConfig,
...     SamMaskDecoderConfig,
...     SamModel,
... )

>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()

>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig

>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()

>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
SamVisionConfig
clase transformers.SamVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
Parámetros
- hidden_size (
int, opcional, valor predeterminado768) — Dimensión de las representaciones ocultas. - output_channels (
int, opcional, valor predeterminado 256) — Dimensionalidad de los canales de salida en el Patch Encoder. - num_hidden_layers (
int, opcional, valor predeterminado12) — Número de capas ocultas en el decodificador del Transformer. - num_attention_heads (
int, opcional, valor predeterminado12) — Número de cabezas de atención para cada capa de atención en el decodificador Transformer. - num_channels (
int, opcional, valor predeterminado3) — El número de canales de entrada. - image_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado1024) — El tamaño (resolución) de cada imagen. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado16) — El tamaño (resolución) de cada parche. - hidden_act (
str, opcional, valor predeterminadogelu) — La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, valor predeterminado1e-06) — La epsilon utilizada por las capas de normalización de capa. - attention_dropout (
Union[float, int], opcional, valor predeterminado0.0) — La proporción de dropout para las probabilidades de atención. - initializer_range (
float, opcional, valor predeterminado1e-10) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - qkv_bias (
bool, opcional, valor predeterminadoTrue) — Si se debe añadir un sesgo a las consultas, claves y valores. - mlp_ratio (
float, opcional, valor predeterminado4.0) — Relación entre la dimensión oculta del MLP y la dimensión de la incrustación. - use_abs_pos (
bool, opcional, valor predeterminadoTrue) — Si se deben usar incrustaciones de posición absoluta. - use_rel_pos (
bool, opcional, valor predeterminadoTrue) — Si se debe usar la incrustación de posición relativa. - window_size (
int, opcional, valor predeterminado 14) — Tamaño de la ventana para la posición relativa. - global_attn_indexes (
list[int], opcional, por defecto[2, 5, 8, 11]) — Los índices de las capas de atención global. - num_pos_feats (
int, opcional, valor predeterminado 128) — La dimensionalidad del incrustado de posición. - mlp_dim (
int, opcional) — La dimensionalidad de la capa MLP en el codificador Transformer. Si esNone, el valor predeterminado esmlp_ratio * hidden_size.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de facebook/sam-vit-huge
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplo:
>>> from transformers import (
...     SamVisionConfig,
...     SamVisionModel,
... )

>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()

>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamMaskDecoderConfig
clase transformers.SamMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06 )
Parámetros
- hidden_size (
int, opcional, valor predeterminado256) — Dimensión de las representaciones ocultas. - hidden_act (
str, opcional, valor predeterminadorelu) — La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo,"gelu","relu","silu", etc. - mlp_dim (
int, opcional, valor predeterminado 2048) — Dimensionalidad de la capa “intermedia” (es decir, de retroalimentación) del codificador Transformer. - num_hidden_layers (
int, opcional, valor predeterminado2) — Número de capas ocultas en el decodificador del Transformer. - num_attention_heads (
int, opcional, valor predeterminado8) — Número de cabezas de atención para cada capa de atención en el decodificador Transformer. - attention_downsample_rate (
int, opcional, valor predeterminado 2) — La tasa de reducción de la capa de atención. - num_multimask_outputs (
int, opcional, valor predeterminado 3) — El número de salidas del móduloSamMaskDecoder. En el artículo de Segment Anything, este valor se establece en 3. - iou_head_depth (
int, opcional, valor predeterminado 3) — El número de capas en el módulo de cabeza de IoU. - iou_head_hidden_dim (
int, opcional, valor predeterminado 256) — La dimensionalidad de los estados ocultos en el módulo de cabeza IoU. - layer_norm_eps (
float, opcional, valor predeterminado1e-06) — La epsilon utilizada por las capas de normalización de capa.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de facebook/sam-vit-huge
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
SamPromptEncoderConfig
clase transformers.SamPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
Parámetros
- hidden_size (
int, opcional, valor predeterminado256) — Dimensión de las representaciones ocultas. - image_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado1024) — El tamaño (resolución) de cada imagen. - patch_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado16) — El tamaño (resolución) de cada parche. - mask_input_channels (
int, opcional, valor predeterminado 16) — El número de canales que se enviarán al móduloMaskDecoder. - num_point_embeddings (
int, opcional, valor predeterminado 4) — El número de embeddings de puntos que se utilizarán. - hidden_act (
str, opcional, valor predeterminadogelu) — La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo,"gelu","relu","silu", etc. - layer_norm_eps (
float, opcional, valor predeterminado1e-06) — La epsilon utilizada por las capas de normalización de capa.
Esta es la clase de configuración para almacenar la configuración de un SamModel. Se utiliza para instanciar un modelo Sam según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de facebook/sam-vit-huge
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
SamProcessor
clase transformers.SamProcessor
< source >( image_processor )
Construye un SamProcessor que envuelve un procesador de imágenes en un único procesador.
SamProcessor ofrece todas las funcionalidades de SamImageProcessor. Consulte ~SamImageProcessor para obtener más información.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = None**kwargs ) → ~tokenization_utils_base.BatchEncoding
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - text (
Union[str, list[str], list[list[str]]], opcional) — La secuencia o lote de secuencias que se codificarán. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadenas pre-tokenizadas). Si se pasa una entrada pre-tokenizada, establezcais_split_into_words=Truepara evitar ambigüedad con las entradas por lotes. - return_tensors (
stro TensorType, opcional) — Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son:'pt': Devuelve objetostorch.Tensorde PyTorch.'np': Devuelve objetosnp.ndarrayde NumPy.
Devuelve
~tokenization_utils_base.BatchEncoding
- data (
dict, opcional) — Diccionario de listas/arrays/tensores devueltos por los métodos__call__/encode_plus/batch_encode_plus(‘input_ids’, ‘attention_mask’, etc.). - encoding (
tokenizers.EncodingoSequence[tokenizers.Encoding], opcional) — Si el tokenizador es un tokenizador rápido que genera información adicional, como el mapeo del espacio de palabras/caracteres al espacio de tokens, la instancia detokenizers.Encodingo la lista de instancias (para lotes) contiene esta información. - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización. - prepend_batch_axis (
bool, opcional, valor predeterminadoFalse) — Indica si se debe añadir un eje de lote al convertir a tensores (consultetensor_typearriba). Tenga en cuenta que este parámetro tiene un efecto si el parámetrotensor_typeestá establecido, en caso contrario no tiene efecto. - n_sequences (
int, opcional) — El número de secuencias de entrada representadas por cada codificación (Nonepara desconocido,1para una secuencia única y2para un par de secuencias).
SamImageProcessor
clase transformers.SamImageProcessor
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'longest_edge' -- 1024}): Describe las dimensiones de entrada máximas para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto2) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional, valor predeterminadoTrue) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'height' -- 1024, 'width': 1024}): El tamaño en{"height": int, "width" int}al que rellenar las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - mask_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"longest_edge": int}al que se redimensionan los mapas de segmentación. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"height": int, "width": int}al que rellenar los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Construye un procesador de imágenes SamImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Los mapas de segmentación que se van a preprocesar. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - mask_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"longest_edge": int}al que se redimensionan los mapas de segmentación. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"height": int, "width": int}al que rellenar los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
SamImageProcessorPil
clase transformers.SamImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'longest_edge' -- 1024}): Describe las dimensiones de entrada máximas para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto2) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional, valor predeterminadoTrue) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'height' -- 1024, 'width': 1024}): El tamaño en{"height": int, "width" int}al que rellenar las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - mask_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"longest_edge": int}al que se redimensionan los mapas de segmentación. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"height": int, "width": int}al que rellenar los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Construye un procesador de imágenes SamImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - segmentation_maps (
ImageInput, opcional) — Los mapas de segmentación que se van a preprocesar. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - mask_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"longest_edge": int}al que se redimensionan los mapas de segmentación. - mask_pad_size (
dict[str, *kwargs*, int], opcional) — El tamaño{"height": int, "width": int}al que rellenar los mapas de segmentación. Debe ser mayor que el tamaño de cualquier mapa de segmentación proporcionado para el preprocesamiento.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
SamVisionModel
clase transformers.SamVisionModel
< source >( config: SamVisionConfig )
Parámetros
- config (SamVisionConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El modelo de visión de Sam sin ninguna cabeza ni proyección en la parte superior.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamVisionEncoderOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando SamImageProcessor. Consulte SamImageProcessor.call() para más detalles (SamProcessor utiliza SamImageProcessor para procesar las imágenes).
Devuelve
SamVisionEncoderOutput o tuple(torch.Tensor)
Un SamVisionEncoderOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (SamConfig) y las entradas.
El método forward de SamVisionModel sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
image_embeds (
torch.Tensorde forma(batch_size, output_dim)opcional devuelta cuando el modelo se inicializa conwith_projection=True) — Las incrustaciones de imagen obtenidas al aplicar la capa de proyección a pooler_output.last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Secuencia de estados ocultos en la salida de la última capa del modelo.hidden_states (
tuple[torch.Tensor, ...], opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
attentions (
tuple[torch.Tensor, ...], opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
SamModel
clase transformers.SamModel
< source >( config: SamConfig )
Parámetros
- config (SamConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
Segment Anything Model (SAM) para generar máscaras de segmentación, a partir de una imagen de entrada y puntos y etiquetas, cajas o máscaras de entrada.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Trueattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamImageSegmentationOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando SamImageProcessor. Consulte SamImageProcessor.call() para más detalles (SamProcessor utiliza SamImageProcessor para procesar las imágenes). - input_points (
torch.Tensorde forma(batch_size, num_points, 2)) — Puntos espaciales 2D de entrada, que se utilizan en el codificador de prompts para codificar el prompt. Generalmente produce resultados mucho mejores. Los puntos se pueden obtener pasando una lista de listas de listas al procesador, que creará los correspondientes tensorestorchde dimensión 4. La primera dimensión es el tamaño del lote de imágenes, la segunda dimensión es el tamaño del lote de puntos (es decir, cuántas máscaras de segmentación queremos que el modelo prediga por punto de entrada), la tercera dimensión es el número de puntos por máscara de segmentación (es posible pasar varios puntos para una sola máscara) y la última dimensión son las coordenadas x (vertical) y y (horizontal) del punto. Si se pasa un número diferente de puntos para cada imagen o para cada máscara, el procesador creará puntos “PAD” que corresponderán a la coordenada (0, 0) y el cálculo del embedding se omitirá para estos puntos usando las etiquetas. - input_labels (
torch.LongTensorde forma(batch_size, point_batch_size, num_points)) — Etiquetas de entrada para los puntos, que se utilizan en el codificador de prompts para codificar el prompt. Según la implementación oficial, hay 3 tipos de etiquetas1: el punto es un punto que contiene el objeto de interés0: el punto es un punto que no contiene el objeto de interés-1: el punto corresponde al fondo
Añadimos la etiqueta:
-10: el punto es un punto de relleno, por lo que debe ser ignorado por el codificador de prompts
Las etiquetas de relleno deberían ser asignadas automáticamente por el procesador.
- input_boxes (
torch.Tensorde forma(batch_size, num_boxes, 4)) — Cajas de entrada para los puntos, se utiliza en el codificador de prompts para codificar el prompt. Generalmente produce máscaras generadas mucho mejores. Las cajas se pueden obtener pasando una lista de listas de listas al procesador, que generará untorchtensor, donde cada dimensión corresponde respectivamente al tamaño del lote de imágenes, al número de cajas por imagen y a las coordenadas del punto superior izquierdo y del punto inferior derecho de la caja. En el orden (x1,y1,x2,y2):x1: la coordenada x del punto superior izquierdo del cuadro de entraday1: la coordenada y del punto superior izquierdo del cuadro de entradax2: la coordenada x del punto inferior derecho del cuadro de entraday2: la coordenada y del punto inferior derecho del cuadro de entrada
- input_masks (
torch.Tensorde forma(batch_size, image_size, image_size)) — El modelo SAM también acepta máscaras de segmentación como entrada. La máscara se incrustará mediante el codificador de prompts para generar una incrustación correspondiente, que se enviará posteriormente al decodificador de máscaras. Estas máscaras deben ser proporcionadas manualmente por el usuario y deben tener la forma (batch_size,image_size,image_size). - image_embeddings (
torch.Tensorde forma(batch_size, output_channels, window_size, window_size)) — Incrustaciones de imagen, se utilizan en el decodificador de máscaras para generar máscaras y puntuaciones iou. Para un cálculo más eficiente en memoria, los usuarios pueden obtener primero las incrustaciones de imagen mediante el métodoget_image_embeddingsy luego pasarlas al métodoforwarden lugar de pasarpixel_values. - multimask_output (
bool, opcional) — En la implementación y el artículo originales, el modelo siempre genera 3 máscaras por imagen (o por punto / por bounding box, si corresponde). Sin embargo, es posible generar una sola máscara, que corresponde a la máscara “mejor”, especificandomultimask_output=False. - attention_similarity (
torch.Tensor, opcional) — Tensor de similitud de atención, que debe proporcionarse al decodificador de máscaras para la atención guiada por objetivos en caso de que el modelo se utilice para personalización, tal como se introduce en PerSAM. - target_embedding (
torch.Tensor, opcional) — Incrustación del concepto objetivo, que debe proporcionarse al decodificador de máscaras para el prompting semántico del objetivo en caso de que el modelo se utilice para personalización, tal como se introduce en PerSAM.
Devuelve
SamImageSegmentationOutput o tuple(torch.Tensor)
Un SamImageSegmentationOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (SamConfig) y las entradas.
El método forward de SamModel sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
iou_scores (
torch.Tensorde forma(batch_size, num_masks)) — Las puntuaciones iou de las máscaras predichas.pred_masks (
torch.Tensorde forma(batch_size, num_masks, height, width)) — Las máscaras de baja resolución predichas. Deben ser procesadas posteriormente por el procesadorvision_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size).Estados ocultos del modelo de visión en la salida de cada capa, más las salidas opcionales de la incrustación inicial.
vision_attentions (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
mask_decoder_attentions (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detorch.Tensor(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")

>>> # Get segmentation mask
>>> outputs = model(**inputs)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )