
Transformers documentation
SAM
Ce modèle a été publié dans HF papers le 2023-04-05 et contribué à Hugging Face Transformers le 2023-04-19.
SAM
Aperçu
SAM (Segment Anything Model) a été proposé dans Segment Anything par Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick.
Le modèle peut être utilisé pour prédire les masques de segmentation de tout objet d'intérêt à partir d'une image en entrée.
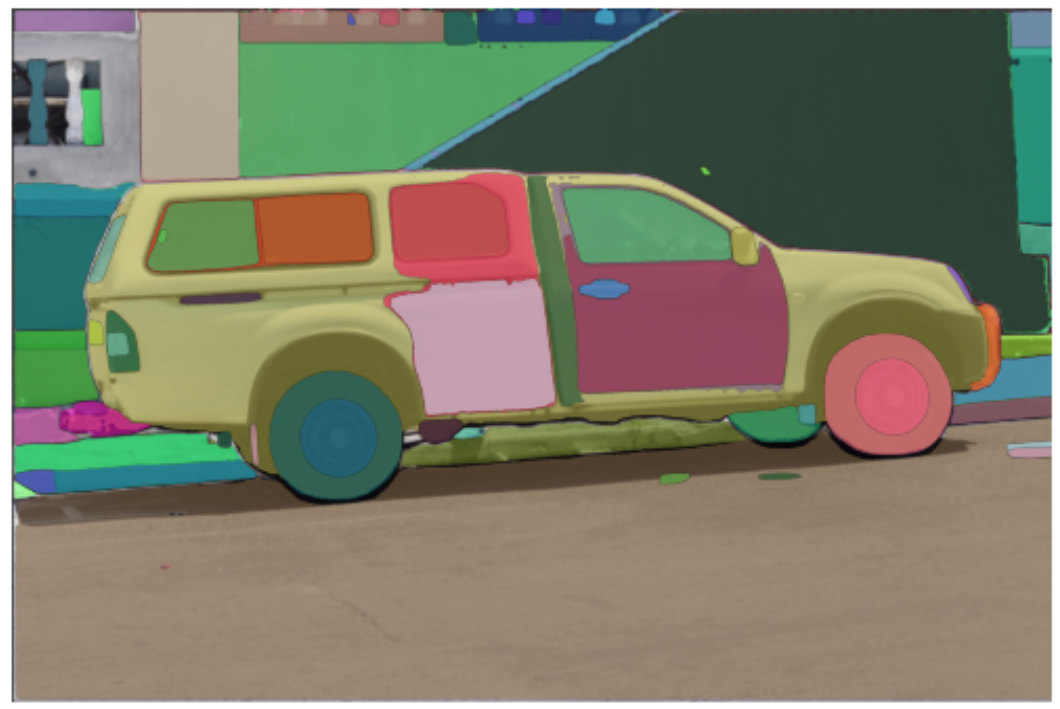
L'abstract de l'article est le suivant :
Nous présentons le projet Segment Anything (SA) : une nouvelle tâche, un nouveau modèle et un nouveau jeu de données pour la segmentation d’images. En utilisant notre modèle efficace dans une boucle de collecte de données, nous avons constitué le plus grand jeu de données de segmentation à ce jour (de loin), avec plus d’un milliard de masques sur 11 millions d’images sous licence et respectant la vie privée. Le modèle est conçu et entraîné pour être pilotable par des prompts, ce qui lui permet de se transférer en zéro-shot à de nouvelles distributions d’images et à de nouvelles tâches. Nous évaluons ses capacités sur de nombreuses tâches et constatons que ses performances en zéro-shot sont impressionnantes — souvent compétitives, voire supérieures, aux résultats entièrement supervisés antérieurs. Nous publions le modèle Segment Anything (SAM) et le jeu de données correspondant (SA-1B) de 1 milliard de masques et 11 millions d’images sur https://segment-anything.com afin de favoriser la recherche sur les modèles de fondation pour la vision par ordinateur.
Astuces :
- Le modèle prédit des masques binaires qui indiquent la présence ou l'absence de l'objet d'intérêt à partir d'une image.
- Le modèle prédit des résultats bien meilleurs si des points 2D en entrée et/ou des boîtes englobantes en entrée sont fournis
- Vous pouvez indiquer plusieurs points pour la même image et prédire un seul masque.
- Le fine-tuning du modèle n'est pas encore pris en charge
- Selon l’article, l’entrée textuelle devrait également être prise en charge. Toutefois, à ce jour, cela ne semble pas être le cas, d’après le dépôt officiel.
Ce modèle a été contribué par ybelkada et ArthurZ. Le code d'origine peut être trouvé ici.
Voici un exemple montrant comment exécuter la génération de masques à partir d'une image et d'un point 2D :
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Vous pouvez également traiter vos propres masques en parallèle des images d’entrée dans le processeur, afin qu’ils soient transmis au modèle.
import requests
import torch
from PIL import Image

from transformers import SamModel, SamProcessor


model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec SAM.
- Cahier d'exemples pour l'utilisation du modèle.
- Cahier de démonstration pour l'utilisation du pipeline de génération automatique de masques.
- Cahier de démonstration pour l'inférence avec MedSAM, une version affinée de SAM sur le domaine médical. 🌎
- Cahier de démonstration pour l'ajustement fin du modèle sur des données personnalisées. 🌎
SlimSAM
SlimSAM, une version élaguée de SAM, a été proposée dans 0.1% Data Makes Segment Anything Slim par Zigeng Chen et al. SlimSAM réduit considérablement la taille des modèles SAM tout en maintenant les mêmes performances.
Les points de contrôle sont disponibles sur le hub et peuvent être utilisés comme substitut direct de SAM.
Grounded SAM
Il est possible de combiner Grounding DINO avec SAM pour la génération de masques basée sur le texte, comme présenté dans Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks. Vous pouvez consulter ce carnet de démonstration 🌍 pour plus de détails.
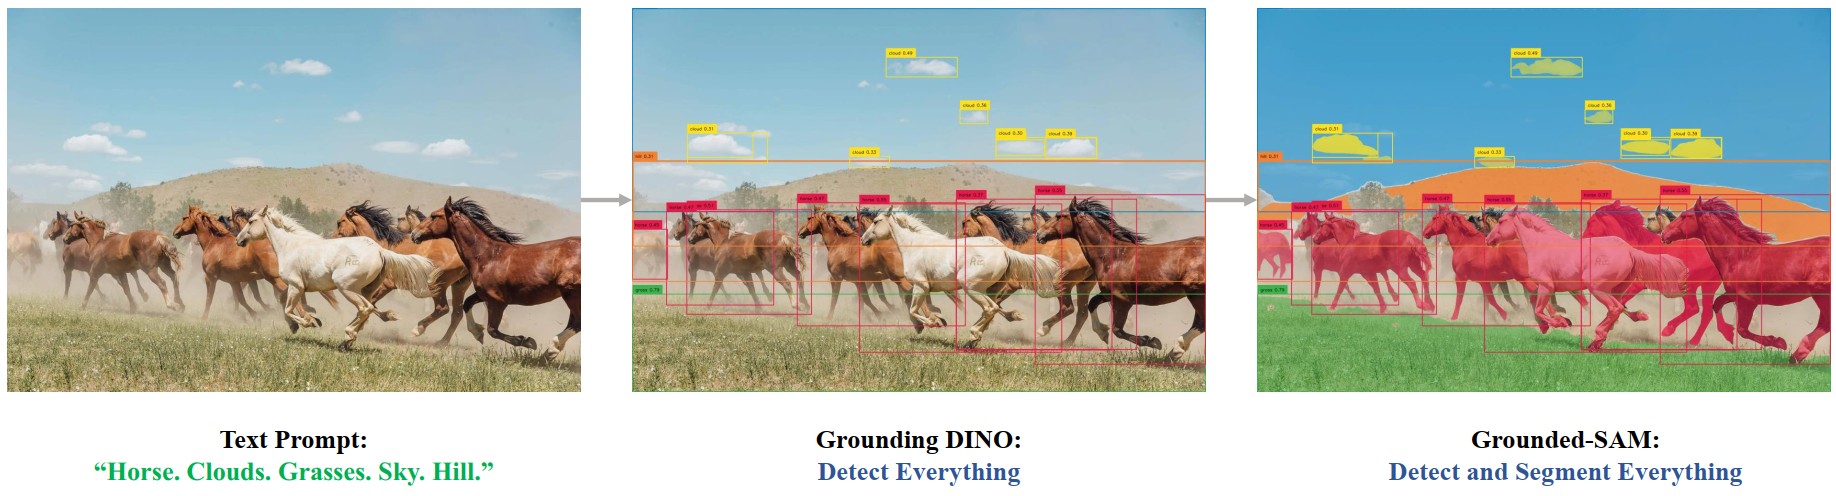 Grounded SAM overview. Taken from the original repository.
SamConfig
classe transformers.SamConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
Paramètres
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], facultatif) — L'objet de configuration ou le dictionnaire du backbone visuel. - prompt_encoder_config (Union[
dict,SamPromptEncoderConfig], facultatif) — Dictionnaire des options de configuration utilisées pour initialiser SamPromptEncoderConfig. - mask_decoder_config (Union[
dict,SamMaskDecoderConfig], facultatif) — Dictionnaire des options de configuration utilisées pour initialiser SamMaskDecoderConfig. - initializer_range (
float, facultatif, par défaut0.02) — L'écart-type de la truncated_normal_initializer utilisé pour initialiser toutes les matrices de poids. - tie_word_embeddings (
bool, facultatif, par défautTrue) — Indique s'il faut lier les embeddings de poids selon la correspondancetied_weights_keysdu modèle.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de facebook/sam-vit-huge
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import (
...     SamVisionConfig,
...     SamPromptEncoderConfig,
...     SamMaskDecoderConfig,
...     SamModel,
... )

>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()

>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig

>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()

>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
SamVisionConfig
classe transformers.SamVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
Paramètres
- hidden_size (
int, facultatif, par défaut768) — Dimension des représentations cachées. - output_channels (
int, facultatif, par défaut 256) — Dimensionnalité des canaux de sortie dans le Patch Encoder. - num_hidden_layers (
int, facultatif, par défaut12) — Nombre de couches cachées dans le décodeur Transformer. - num_attention_heads (
int, facultatif, valeur par défaut12) — Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer. - num_channels (
int, facultatif, par défaut3) — Le nombre de canaux d'entrée. - image_size (
Union[int, list[int], tuple[int, int]], facultatif, par défaut1024) — La taille (résolution) de chaque image. - patch_size (
Union[int, list[int], tuple[int, int]], facultatif, par défaut16) — La taille (résolution) de chaque patch. - hidden_act (
str, facultatif, par défautgelu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple,"gelu","relu","silu", etc. - layer_norm_eps (
float, facultatif, valeur par défaut1e-06) — L'épsilon utilisé par les couches de normalisation de couche. - attention_dropout (
Union[float, int], facultatif, valeur par défaut0.0) — Le taux de dropout appliqué aux probabilités d'attention. - initializer_range (
float, facultatif, par défaut1e-10) — L'écart-type de la truncated_normal_initializer utilisé pour initialiser toutes les matrices de poids. - qkv_bias (
bool, facultatif, par défautTrue) — Indique s'il faut ajouter un biais aux requêtes, clés et valeurs. - mlp_ratio (
float, facultatif, par défaut4.0) — Ratio de la dimension cachée du MLP par rapport à la dimension d'embedding. - use_abs_pos (
bool, facultatif, par défautTrue) — Indique s'il faut utiliser des embeddings de position absolue. - use_rel_pos (
bool, facultatif, par défautTrue) — Indique s'il faut utiliser l'incorporation de position relative. - window_size (
int, facultatif, valeur par défaut 14) — Taille de la fenêtre pour la position relative. - global_attn_indexes (
list[int], facultatif, par défaut[2, 5, 8, 11]) — Les index des couches d'attention globale. - num_pos_feats (
int, facultatif, valeur par défaut : 128) — La dimension de l’incorporation de position. - mlp_dim (
int, facultatif) — La dimension de la couche MLP dans l'encodeur Transformer. SiNone, la valeur par défaut estmlp_ratio * hidden_size.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de facebook/sam-vit-huge
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import (
...     SamVisionConfig,
...     SamVisionModel,
... )

>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()

>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamMaskDecoderConfig
classe transformers.SamMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06 )
Paramètres
- hidden_size (
int, facultatif, par défaut256) — Dimension des représentations cachées. - hidden_act (
str, facultatif, par défautrelu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple,"gelu","relu","silu", etc. - mlp_dim (
int, facultatif, valeur par défaut 2048) — Dimension de la couche « intermédiaire » (c.-à-d. à propagation avant) de l’encodeur Transformer. - num_hidden_layers (
int, facultatif, par défaut2) — Nombre de couches cachées dans le décodeur Transformer. - num_attention_heads (
int, facultatif, valeur par défaut8) — Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer. - attention_downsample_rate (
int, facultatif, valeur par défaut : 2) — Taux de sous-échantillonnage de la couche d'attention. - num_multimask_outputs (
int, facultatif, valeur par défaut 3) — Le nombre de sorties du moduleSamMaskDecoder. Dans l’article Segment Anything, cette valeur est fixée à 3. - iou_head_depth (
int, facultatif, valeur par défaut : 3) — Le nombre de couches du module de tête IoU. - iou_head_hidden_dim (
int, facultatif, valeur par défaut 256) — La dimension des états cachés dans le module de tête IoU. - layer_norm_eps (
float, facultatif, valeur par défaut1e-06) — L'épsilon utilisé par les couches de normalisation de couche.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de facebook/sam-vit-huge
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
SamPromptEncoderConfig
classe transformers.SamPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
Paramètres
- hidden_size (
int, facultatif, par défaut256) — Dimension des représentations cachées. - image_size (
Union[int, list[int], tuple[int, int]], facultatif, par défaut1024) — La taille (résolution) de chaque image. - patch_size (
Union[int, list[int], tuple[int, int]], facultatif, par défaut16) — La taille (résolution) de chaque patch. - mask_input_channels (
int, facultatif, valeur par défaut 16) — Le nombre de canaux à transmettre au moduleMaskDecoder. - num_point_embeddings (
int, facultatif, par défaut 4) — Le nombre d'embeddings de points à utiliser. - hidden_act (
str, facultatif, par défautgelu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple,"gelu","relu","silu", etc. - layer_norm_eps (
float, facultatif, valeur par défaut1e-06) — L'épsilon utilisé par les couches de normalisation de couche.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de facebook/sam-vit-huge
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
SamProcessor
classe transformers.SamProcessor
< source >( image_processor )
Construit un SamProcessor qui encapsule un processeur d'image dans un processeur unique.
SamProcessor propose toutes les fonctionnalités de SamImageProcessor. Consultez ~SamImageProcessor pour plus d'informations.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = None**kwargs ) → ~tokenization_utils_base.BatchEncoding
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], facultatif) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - text (
Union[str, list[str], list[list[str]]], facultatif) — La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaînes pré-tokenisées). Si vous passez une entrée pré-tokenisée, définissezis_split_into_words=Truepour éviter toute ambiguïté avec les entrées en lot. - return_tensors (
strou TensorType, facultatif) — Si défini, renvoie des tenseurs d'un framework particulier. Les valeurs acceptées sont :'pt': Renvoie des objetstorch.Tensorde PyTorch.'np': Renvoie des objets NumPynp.ndarray.
Retourne
~tokenization_utils_base.BatchEncoding
- data (
dict, facultatif) — Dictionnaire de listes/tableaux/tenseurs renvoyé par les méthodes__call__/encode_plus/batch_encode_plus(‘input_ids’, ‘attention_mask’, etc.). - encoding (
tokenizers.EncodingouSequence[tokenizers.Encoding], facultatif) — Si le tokenizer est un fast tokenizer qui fournit des informations supplémentaires, comme la correspondance entre l’espace des mots/caractères et l’espace des jetons, l’instancetokenizers.Encodingou la liste d’instances (pour les lots) contient ces informations. - tensor_type (
Union[None, str, TensorType], facultatif) — Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation. - prepend_batch_axis (
bool, facultatif, par défautFalse) — Indique s'il faut ou non ajouter un axe de lot lors de la conversion en tenseurs (voirtensor_typeci-dessus). Notez que ce paramètre a un effet si le paramètretensor_typeest défini, sinon il n'a aucun effet. - n_sequences (
int, facultatif) — Le nombre de séquences d'entrée représentées par chaque encodage (Nonepour inconnu,1pour une seule séquence et2pour une paire de séquences).
SamImageProcessor
classe transformers.SamImageProcessor
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> )
Paramètres
- do_convert_rgb (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'longest_edge' -- 1024}) : Définit les dimensions d'entrée maximales pour le modèle. - default_to_square (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut utiliser une image carrée par défaut lors du redimensionnement, si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, par défaut2) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif, valeur par défaut0.00392156862745098) — Facteur de remise à l'échelle appliqué à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.485, 0.456, 0.406]) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.229, 0.224, 0.225]) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut appliquer un bourrage (padding) à l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'height' -- 1024, 'width': 1024}) : La taille au format{"height": int, "width" int}à laquelle rembourrer les images. Elle doit être supérieure à la taille de n’importe quelle image fournie pour le prétraitement. Sipad_sizen’est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - mask_size (
dict[str, *kwargs*, int], facultatif) — La taille{"longest_edge": int}à laquelle redimensionner les cartes de segmentation. - mask_pad_size (
dict[str, *kwargs*, int], facultatif) — La taille{"height": int, "width": int}à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Construit un processeur d’images SamImageProcessor.
prétraiter
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - segmentation_maps (
ImageInput, facultatif) — Les cartes de segmentation à prétraiter. - do_convert_rgb (
bool, kwargs, facultatif) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Définit les dimensions maximales des entrées du modèle. - default_to_square (
bool, kwargs, facultatif) — Indique s'il faut par défaut redimensionner l'image en carré si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif) — Facteur de remise à l'échelle à appliquer à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - mask_size (
dict[str, *kwargs*, int], facultatif) — La taille{"longest_edge": int}à laquelle redimensionner les cartes de segmentation. - mask_pad_size (
dict[str, *kwargs*, int], facultatif) — La taille{"height": int, "width": int}à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Retourne
~image_processing_base.BatchFeature
- data (
dict) — Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode call (« pixel_values », etc.). - tensor_type (
Union[None, str, TensorType], facultatif) — Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
SamImageProcessorPil
classe transformers.SamImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> )
Paramètres
- do_convert_rgb (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'longest_edge' -- 1024}) : Définit les dimensions d'entrée maximales pour le modèle. - default_to_square (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut utiliser une image carrée par défaut lors du redimensionnement, si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, par défaut2) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif, valeur par défaut0.00392156862745098) — Facteur de remise à l'échelle appliqué à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.485, 0.456, 0.406]) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.229, 0.224, 0.225]) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut appliquer un bourrage (padding) à l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'height' -- 1024, 'width': 1024}) : La taille au format{"height": int, "width" int}à laquelle rembourrer les images. Elle doit être supérieure à la taille de n’importe quelle image fournie pour le prétraitement. Sipad_sizen’est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - mask_size (
dict[str, *kwargs*, int], facultatif) — La taille{"longest_edge": int}à laquelle redimensionner les cartes de segmentation. - mask_pad_size (
dict[str, *kwargs*, int], facultatif) — La taille{"height": int, "width": int}à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Construit un processeur d’images SamImageProcessor.
prétraiter
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam.image_processing_pil_sam.SamImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - segmentation_maps (
ImageInput, facultatif) — Les cartes de segmentation à prétraiter. - do_convert_rgb (
bool, kwargs, facultatif) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Définit les dimensions maximales des entrées du modèle. - default_to_square (
bool, kwargs, facultatif) — Indique s'il faut par défaut redimensionner l'image en carré si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif) — Facteur de remise à l'échelle à appliquer à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - mask_size (
dict[str, *kwargs*, int], facultatif) — La taille{"longest_edge": int}à laquelle redimensionner les cartes de segmentation. - mask_pad_size (
dict[str, *kwargs*, int], facultatif) — La taille{"height": int, "width": int}à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Retourne
~image_processing_base.BatchFeature
- data (
dict) — Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode call (« pixel_values », etc.). - tensor_type (
Union[None, str, TensorType], facultatif) — Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
SamVisionModel
classe transformers.SamVisionModel
< source >( config: SamVisionConfig )
Paramètres
- config (SamVisionConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle de vision de Sam, sans aucune tête ni projection au sommet.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamVisionEncoderOutput or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de SamImageProcessor. Voir SamImageProcessor.call() pour plus de détails (SamProcessor utilise SamImageProcessor pour le traitement des images).
Retourne
SamVisionEncoderOutput ou tuple(torch.Tensor)
Un SamVisionEncoderOutput ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (SamConfig) et des entrées.
La méthode forward de SamVisionModel redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
image_embeds (
torch.Tensorde forme(batch_size, output_dim)facultatif renvoyé lorsque le modèle est initialisé avecwith_projection=True) — Les embeddings d’image obtenus en appliquant la couche de projection au pooler_output.last_hidden_state (
torch.Tensorde forme(batch_size, sequence_length, hidden_size), facultatif) — Séquence d'états cachés à la sortie de la dernière couche du modèle.hidden_states (
tuple[torch.Tensor, ...], facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
attentions (
tuple[torch.Tensor, ...], facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
SamModel
classe transformers.SamModel
< source >( config: SamConfig )
Paramètres
- config (SamConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Segment Anything Model (SAM) pour générer des masques de segmentation, à partir d'une image d'entrée et de points, étiquettes, boîtes ou masques d'entrée.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Trueattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamImageSegmentationOutput or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de SamImageProcessor. Voir SamImageProcessor.call() pour plus de détails (SamProcessor utilise SamImageProcessor pour le traitement des images). - input_points (
torch.Tensorde forme(batch_size, num_points, 2)) — Points spatiaux 2D en entrée, utilisés par l’encodeur de prompt pour encoder le prompt. Produit généralement des résultats nettement meilleurs. Les points peuvent être obtenus en transmettant une liste de listes de listes au processeur, qui créera les tenseurstorchcorrespondants de dimension 4. La première dimension correspond à la taille du lot d’images, la deuxième à la taille du lot de points (c’est-à-dire le nombre de masques de segmentation que le modèle doit prédire par point d’entrée), la troisième au nombre de points par masque de segmentation (il est possible de transmettre plusieurs points pour un seul masque), et la dernière aux coordonnées x (verticale) et y (horizontale) du point. Si un nombre différent de points est transmis pour chaque image ou pour chaque masque, le processeur créera des points « PAD » correspondant à la coordonnée (0, 0), et le calcul de l’embedding sera ignoré pour ces points à l’aide des étiquettes. - input_labels (
torch.LongTensorde forme(batch_size, point_batch_size, num_points)) — Étiquettes d'entrée pour les points, utilisées par l'encodeur de prompt pour encoder le prompt. Selon l'implémentation officielle, il existe 3 types d'étiquettes1: le point est un point qui contient l'objet d'intérêt0: le point est un point qui ne contient pas l'objet d'intérêt-1: le point correspond à l'arrière-plan
Nous avons ajouté l'étiquette :
-10: le point est un point de bourrage, il doit donc être ignoré par l'encodeur de prompt
Les étiquettes de bourrage doivent être effectuées automatiquement par le processeur.
- input_boxes (
torch.Tensorde forme(batch_size, num_boxes, 4)) — Boîtes d'entrée pour les points, utilisées par l'encodeur de prompt pour encoder le prompt. Elles produisent généralement des masques générés bien meilleurs. Les boîtes peuvent être obtenues en passant une liste de listes de listes au processeur, qui génère untorchtenseur, où chaque dimension correspond respectivement à la taille du lot d'images, au nombre de boîtes par image et aux coordonnées du point en haut à gauche et du point en bas à droite de la boîte. Dans l'ordre (x1,y1,x2,y2):x1: la coordonnée x du point en haut à gauche de la boîte d'entréey1: la coordonnée y du point en haut à gauche de la boîte d'entréex2: la coordonnée x du point en bas à droite de la boîte d'entréey2: la coordonnée y du point en bas à droite de la boîte d'entrée
- input_masks (
torch.Tensorde forme(batch_size, image_size, image_size)) — Le modèle SAM accepte également des masques de segmentation en entrée. Le masque sera intégré par l’encodeur de prompt pour générer un embedding correspondant, qui sera ensuite transmis au décodeur de masque. Ces masques doivent être fournis manuellement par l’utilisateur et doivent être de forme (batch_size,image_size,image_size). - image_embeddings (
torch.Tensorde forme(batch_size, output_channels, window_size, window_size)) — Embeddings d’image, utilisés par le décodeur de masque pour générer les masques et les scores iou. Pour un calcul plus efficace en mémoire, les utilisateurs peuvent d’abord récupérer les embeddings d’image à l’aide de la méthodeget_image_embeddings, puis les transmettre à la méthodeforwardau lieu de transmettre lespixel_values. - multimask_output (
bool, facultatif) — Dans l’implémentation et l’article originaux, le modèle produit toujours 3 masques par image (ou par point / par boîte englobante le cas échéant). Il est toutefois possible de n’afficher qu’un seul masque, correspondant au meilleur masque, en spécifiantmultimask_output=False. - attention_similarity (
torch.Tensor, facultatif) — Tenseur de similarité d’attention, à fournir au décodeur de masque pour une attention guidée par la cible lorsque le modèle est utilisé pour la personnalisation, comme introduit dans PerSAM. - target_embedding (
torch.Tensor, facultatif) — Embedding du concept cible, à fournir au décodeur de masque pour le prompting sémantique de la cible dans le cas où le modèle est utilisé pour la personnalisation, comme introduit dans PerSAM.
Retourne
SamImageSegmentationOutput ou tuple(torch.Tensor)
Un SamImageSegmentationOutput ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (SamConfig) et des entrées.
La méthode forward de SamModel redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
iou_scores (
torch.Tensorde forme(batch_size, num_masks)) — Les scores iou des masques prédits.pred_masks (
torch.Tensorde forme(batch_size, num_masks, height, width)) — Les masques de basse résolution prédits. Doivent être post-traités par le processeurvision_hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, sequence_length, hidden_size).États cachés du modèle de vision à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
vision_attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
mask_decoder_attentions (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_attentions=Trueest passé ou lorsqueconfig.output_attentions=True) — Tuple detorch.Tensor(un par couche) de forme(batch_size, num_heads, sequence_length, sequence_length).Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")

>>> # Get segmentation mask
>>> outputs = model(**inputs)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )