
Transformers documentation
CLIPSeg
このモデルは2021年12月18日にHF papersで公開され、2022年11月8日にHugging Face Transformersに貢献されました。
CLIPSeg
概要
CLIPSegモデルは、Timo LüddeckeとAlexander Eckerによる論文Image Segmentation Using Text and Image Promptsで提案されました。CLIPSegは、凍結されたCLIPモデルの上に最小限のデコーダーを追加することで、ゼロショットおよびワンショットの画像セグメンテーションを実現します。
論文の抄録は以下の通りです。
画像セグメンテーションは、通常、固定されたオブジェクトクラスセットに対してモデルを訓練することで対処されます。後から追加のクラスやより複雑なクエリを取り込むには、それらの表現を含むデータセットでモデルを再訓練する必要があり、コストが高くなります。本稿では、テスト時に任意のプロンプトに基づいて画像セグメンテーションを生成できるシステムを提案します。プロンプトはテキストまたは画像のいずれかです。このアプローチにより、それぞれが固有の課題を持つ3つの一般的なセグメンテーションタスク、すなわち参照表現セグメンテーション、ゼロショットセグメンテーション、ワンショットセグメンテーションに対して、統一されたモデル(一度だけ訓練)を構築できます。私たちは、CLIPモデルをバックボーンとして使用し、それを拡張して、密な予測を可能にするトランスフォーマーベースのデコーダーを追加しました。PhraseCutデータセットの拡張版で訓練した後、私たちのシステムは、フリーテキストのプロンプトまたはクエリを表す追加の画像に基づいて、画像のバイナリセグメンテーションマップを生成します。後者の画像ベースのプロンプトの異なるバリアントを詳細に分析します。この新しいハイブリッド入力により、上記の3つのセグメンテーションタスクだけでなく、テキストまたは画像のクエリを定式化できるあらゆるバイナリセグメンテーションタスクへの動的な適応が可能になります。最後に、私たちのシステムは、アフォーダンスやプロパティを含む汎用的なクエリにもよく適応することがわかりました。
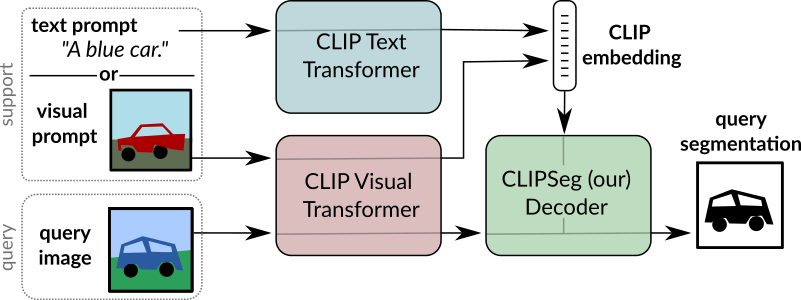 CLIPSeg overview. Taken from the original paper.
このモデルはnielsrによって提供されました。 元のコードはこちらで確認できます。
使用のコツ
- CLIPSegForImageSegmentation は CLIPSegModel の上にデコーダーを追加します。後者は CLIPModel と同一です。
- CLIPSegForImageSegmentation は、テスト時に任意のプロンプトに基づいて画像セグメンテーションを生成できます。プロンプトはテキスト(モデルに
input_idsとして提供)または画像(モデルにconditional_pixel_valuesとして提供)のいずれかです。また、カスタムの条件付き埋め込み(モデルにconditional_embeddingsとして提供)を指定することもできます。
リソース
CLIPSegの入門を支援するための、Hugging Face公式およびコミュニティ(🌎で示されます)のリソース一覧です。ここにリソースを掲載していただくことを希望される場合は、Pull Requestをオープンしてください。レビューいたします。リソースは、既存のリソースと重複するのではなく、新しい内容をデモンストレーションするものが望ましいです。
- CLIPSegによるゼロショット画像セグメンテーションを説明するノートブック。
CLIPSegConfig
クラス transformers.CLIPSegConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = Nonevision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = Noneprojection_dim: int | None = 512logit_scale_init_value: float | int | None = 2.6592initializer_factor: float | None = 1.0extract_layers: list[int] | tuple[int, ...] = (3, 6, 9)reduce_dim: int = 64decoder_num_attention_heads: int = 4decoder_attention_dropout: float | int = 0.0decoder_hidden_act: str = 'quick_gelu'decoder_intermediate_size: int = 2048conditional_layer: int = 0use_complex_transposed_convolution: bool = False )
パラメータ
- text_config (
Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]、省略可) — テキストバックボーンの設定オブジェクトまたは辞書です。 - vision_config (
Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig], 任意) — ビジョンバックボーンの設定オブジェクトまたは辞書です。 - projection_dim (
int、任意、デフォルトは512) — テキストおよびビジョンの投影層の次元数。 - logit_scale_init_value (
Union[float, int]、任意、デフォルトは2.6592) — logit_scale パラメータの初期値です。 - initializer_factor (
float、任意、デフォルトは1.0) — すべての重み行列を初期化する際に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。 - extract_layers (
list[int]、任意、デフォルトは[3, 6, 9]) — CLIP の凍結されたビジュアルバックボーンにクエリ画像をフォワードする際に抽出するレイヤー。 - reduce_dim (
int、任意、デフォルトは 64) — CLIP のビジョン埋め込みを削減する次元数。 - decoder_num_attention_heads (
int、任意、デフォルトは4) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - decoder_attention_dropout (
Union[float, int]、省略可、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - decoder_hidden_act (
str、任意、デフォルトはquick_gelu) — デコーダーで使用する非線形活性化関数(関数または文字列)です。例えば、"gelu"、"relu"、"silu"などです。 - decoder_intermediate_size (
int、任意、デフォルトは2048) — MLP 表現の次元数。 - conditional_layer (
int、任意、デフォルトは 0) — Transformer エンコーダーの活性化を FiLM (Feature-wise Linear Modulation) を用いて条件埋め込みと結合するために使用するレイヤーです。0 の場合、最後のレイヤーが使用されます。 - use_complex_transposed_convolution (
bool、任意、デフォルトはFalse) — デコーダーでより複雑な転置畳み込みを使用するかどうか。より細粒度のセグメンテーションを可能にします。
これはCLIPSegModelの設定を保存するための設定クラスです。指定された引数に基づいてClipsegモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、CIDAS/clipseg-rd64と類似した設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import CLIPSegConfig, CLIPSegModel

>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()

>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config

>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig

>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()

>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
CLIPSegTextConfig
class transformers.CLIPSegTextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 49408hidden_size: int = 512intermediate_size: int = 2048num_hidden_layers: int = 12num_attention_heads: int = 8max_position_embeddings: int = 77hidden_act: str = 'quick_gelu'layer_norm_eps: float | None = 1e-05attention_dropout: int | float | None = 0.0initializer_range: float = 0.02initializer_factor: float | None = 1.0pad_token_id: int | None = 1bos_token_id: int | None = 49406eos_token_id: int | list[int] | None = 49407 )
パラメータ
- vocab_size (
int、任意、デフォルトは49408) — モデルの語彙サイズ。input_idsで表現できるトークンの種類数を定義します。 - hidden_size (
int、任意、デフォルトは512) — 隠れ表現の次元数。 - intermediate_size (
int、任意、デフォルトは2048) — MLP 表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは8) — Transformer デコーダーの各アテンション層におけるアテンションヘッドの数。 - max_position_embeddings (
int、任意、デフォルトは77) — このモデルが使用される可能性のある最大シーケンス長です。 - hidden_act (
str、任意、デフォルトはquick_gelu) — デコーダーで使用する非線形活性化関数(関数または文字列)です。例えば、"gelu"、"relu"、"silu"などです。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - attention_dropout (
Union[int, float]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - initializer_factor (
float、任意、デフォルトは1.0) — すべての重み行列を初期化する際に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。 - pad_token_id (
int、任意、デフォルトは1) — 語彙内でパディングに使用されるトークン ID。 - bos_token_id (
int、任意、デフォルトは49406) — 語彙におけるストリーム開始に使用されるトークン ID。 - eos_token_id (
Union[int, list[int]]、任意、デフォルトは49407) — 語彙内でストリーム終了に使用されるトークン ID。
これはCLIPSegModelの設定を保存するための設定クラスです。指定された引数に基づいてClipsegモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、CIDAS/clipseg-rd64と類似した設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel

>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()

>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
CLIPSegVisionConfig
クラス transformers.CLIPSegVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768intermediate_size: int = 3072num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] | None = 224patch_size: int | list[int] | tuple[int, int] | None = 32hidden_act: str = 'quick_gelu'layer_norm_eps: float = 1e-05attention_dropout: int | float | None = 0.0initializer_range: float = 0.02initializer_factor: float = 1.0 )
パラメータ
- hidden_size (
int、任意、デフォルトは768) — 隠れ表現の次元数。 - intermediate_size (
int、任意、デフォルトは3072) — MLP 表現の次元数。 - num_hidden_layers (
int、任意、デフォルトは12) — Transformer デコーダーの隠れ層の数。 - num_attention_heads (
int、任意、デフォルトは12) — Transformerデコーダーの各アテンション層におけるアテンションヘッドの数。 - num_channels (
int、任意、デフォルトは3) — 入力チャネル数。 - image_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは224) — 各画像のサイズ(解像度)。 - patch_size (
Union[int, list[int], tuple[int, int]]、任意、デフォルトは32) — 各パッチのサイズ(解像度)です。 - hidden_act (
str、任意、デフォルトはquick_gelu) — デコーダーで使用する非線形活性化関数(関数または文字列)です。例えば、"gelu"、"relu"、"silu"などです。 - layer_norm_eps (
float、任意、デフォルトは1e-05) — レイヤーノーマル層で使用する epsilon です。 - attention_dropout (
Union[int, float]、任意、デフォルトは0.0) — アテンション確率のドロップアウト率です。 - initializer_range (
float、任意、デフォルトは0.02) — すべての重み行列を初期化するための truncated_normal_initializer の標準偏差です。 - initializer_factor (
float、任意、デフォルトは1.0) — すべての重み行列を初期化する際に用いる係数です(1 に保つ必要があります。初期化のテスト用に内部で使用されます)。
これはCLIPSegModelの設定を保存するための設定クラスです。指定された引数に基づいてClipsegモデルをインスタンス化し、モデルのアーキテクチャを定義するために使用されます。デフォルト値で設定をインスタンス化すると、CIDAS/clipseg-rd64と類似した設定が得られます。
設定オブジェクトはPreTrainedConfigを継承し、モデルの出力を制御するために使用できます。詳細については、PreTrainedConfigのドキュメントを参照してください。
例:
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel

>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()

>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
CLIPSegProcessor
class transformers.CLIPSegProcessor
< source >( image_processor = Nonetokenizer = None**kwargs )
画像プロセッサとトークナイザーを単一のプロセッサにラップするCLIPSegProcessorを構築します。
CLIPSegProcessor は、ViTImageProcessor と CLIPTokenizer のすべての機能を提供します。詳細については、~ViTImageProcessor および ~CLIPTokenizer を参照してください。
__call__
< source >( text = Noneimages = Nonevisual_prompt = None**kwargs ) → BatchEncoding
パラメータ
- text (`
) -- The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, setis_split_into_words=True` to avoid ambiguity with batched inputs. - images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - visual_prompt (
PIL.Image.Image、np.ndarray、torch.Tensor、list[PIL.Image.Image]、list[np.ndarray]、list[torch.Tensor]) — 準備対象となるビジュアルプロンプトの画像または画像のバッチです。各ビジュアルプロンプト画像は、PIL 画像、NumPy 配列、または PyTorch テンソルのいずれかです。NumPy 配列または PyTorch テンソルの場合、各画像の形状は (C, H, W) である必要があります。ここで、C はチャネル数、H と W は画像の高さと幅を表します。 - return_tensors (
strまたは TensorType, 省略可) — 設定すると、特定のフレームワークのテンソルを返します。使用可能な値は以下の通りです:'pt': PyTorchのtorch.Tensorオブジェクトを返します。'np': NumPyのnp.ndarrayオブジェクトを返します。
戻り値
以下のフィールドを持つBatchEncoding:
- input_ids — モデルに与えるトークン ID のリスト。
textがNoneでない場合に返されます。 - attention_mask — モデルがどのトークンに注意を払うべきかを指定するインデックスのリスト(
return_attention_mask=Trueの場合、またはself.model_input_namesに“attention_mask”が含まれておりtextがNoneでない場合)。 - pixel_values — モデルに渡すピクセル値。
imagesがNoneでない場合に返されます。
CLIPSegModel
クラス transformers.CLIPSegModel
< source >( config: CLIPSegConfig )
パラメータ
- config (CLIPSegConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
特定のヘッドを付加せず、生のhidden-statesを出力する素のClipseg Model。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonereturn_loss: bool | None = Noneinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CLIPSegOutput or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、省略可) — 語彙における入力シーケンスのトークンインデックスです。デフォルトではパディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は ViTImageProcessor を使用して取得できます。詳細は ViTImageProcessor.call() を参照してください(CLIPSegProcessor は画像の処理に ViTImageProcessor を使用します)。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - return_loss (
bool、任意) — 対比損失を返すかどうかを指定します。 - interpolate_pos_encoding (
bool、任意、デフォルトはTrue) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
CLIPSegOutput または tuple(torch.Tensor)
CLIPSegOutput、またはtorch.Tensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
CLIPSegModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.Tensor、shape(1,)、optional、return_lossがTrueの場合のみ返されます) — 画像とテキストの類似度に対する対比損失。 - logits_per_image (
torch.Tensor、形状(image_batch_size, text_batch_size)) —image_embedsとtext_embeds間のスケーリング済みドット積スコアです。これは画像とテキストの類似度スコアを表します。 - logits_per_text (
torch.Tensor、形状(text_batch_size, image_batch_size)) —text_embedsとimage_embeds間のスケーリングされたドット積スコアです。これはテキストと画像の類似度スコアを表します。 - text_embeds (
torch.Tensor、形状(batch_size, output_dim) — CLIPSegTextModel のプーリング済み出力に投影層を適用して得られたテキスト埋め込み。 - image_embeds (
torch.Tensor、形状(batch_size, output_dim) — CLIPSegVisionModelのプーリング済み出力に投影層を適用して得られた画像埋め込み。 - text_model_output (
~modeling_outputs.BaseModelOutputWithPooling、任意) — CLIPSegTextModel の出力です。 - vision_model_output (
~modeling_outputs.BaseModelOutputWithPooling、任意) — CLIPSegVisionModel の出力です。
例:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(
...     text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )

>>> with torch.inference_mode():
...     outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image  # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1)  # we can take the softmax to get the label probabilities
get_text_features
< source >( input_ids: Tensorattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length)) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1].
戻り値
BaseModelOutputWithPooling または tuple(torch.Tensor)
torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または BaseModelOutputWithPooling。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.Tensor、shape(batch_size, hidden_size)) — シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態を、補助的な事前学習タスクに使用される層でさらに処理した後の出力。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel

>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
...     text_features = model.get_text_features(**inputs)
get_image_features
< source >( pixel_values: Tensorinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)) — 入力画像に対応するテンソルです。ピクセル値は ViTImageProcessor を使用して取得できます。詳細は ViTImageProcessor.call() を参照してください(CLIPSegProcessor は画像の処理に ViTImageProcessor を使用しています)。 - interpolate_pos_encoding (
bool、任意、デフォルトはTrue) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
BaseModelOutputWithPooling または tuple(torch.Tensor)
torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または BaseModelOutputWithPooling。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.Tensor、shape(batch_size, hidden_size)) — シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態を、補助的な事前学習タスクに使用される層でさらに処理した後の出力。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> inputs = processor(images=image, return_tensors="pt")

>>> with torch.inference_mode():
...     image_features = model.get_image_features(**inputs)
CLIPSegTextModel
クラス transformers.CLIPSegTextModel
< source >( config: CLIPSegTextConfig )
パラメータ
- config (CLIPSegTextConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ヘッドや投影が一切付加されていないCLIPSEGのテキストモデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.Tensorの形状(batch_size, sequence_length), 、省略可) — 位置埋め込みにおける各入力シーケンスのトークンの位置のインデックス。範囲[0, config.n_positions - 1].
戻り値
BaseModelOutputWithPooling または tuple(torch.Tensor)
torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または BaseModelOutputWithPooling。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
CLIPSegTextModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.Tensor、shape(batch_size, hidden_size)) — シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態を、補助的な事前学習タスクに使用される層でさらに処理した後の出力。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from transformers import AutoTokenizer, CLIPSegTextModel

>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")

>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output  # pooled (EOS token) states
CLIPSegVisionModel
class transformers.CLIPSegVisionModel
< source >( config: CLIPSegVisionConfig )
パラメータ
- config (CLIPSegVisionConfig) — モデルのパラメータをすべて含むモデル設定クラス。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
CLIPSEGのビジョンモデルで、上部にヘッドや投影が一切付いていないものです。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( pixel_values: typing.Optional[torch.Tensor]interpolate_pos_encoding: bool | None = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
パラメータ
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は ViTImageProcessor を使用して取得できます。詳細は ViTImageProcessor.call() を参照してください(CLIPSegProcessor は画像の処理に ViTImageProcessor を使用します)。 - interpolate_pos_encoding (
bool、任意、デフォルトはTrue) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
BaseModelOutputWithPooling または tuple(torch.Tensor)
torch.Tensor のタプル(return_dict=False が渡された場合、または config.return_dict=False の場合)または BaseModelOutputWithPooling。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
CLIPSegVisionModelのforwardメソッドは、__call__特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
last_hidden_state (
torch.Tensor、形状(batch_size, sequence_length, hidden_size)) — モデルの最終層の出力における隠れ状態のシーケンス。pooler_output (
torch.Tensor、shape(batch_size, hidden_size)) — シーケンスの最初のトークン(分類トークン)の最終層の隠れ状態を、補助的な事前学習タスクに使用される層でさらに処理した後の出力。例えば、BERT系のモデルでは、線形層とtanh活性化関数を経て処理された分類トークンを返します。この線形層の重みは、事前学習中の次の文予測(分類)目的から学習されます。hidden_states (
tuple(torch.Tensor)、optional、output_hidden_states=Trueが渡された場合またはconfig.output_hidden_states=Trueの場合に返されます) —torch.Tensorのタプル(埋め込み層を持つモデルの場合、埋め込みの出力が 1 つ、各層の出力がそれぞれ 1 つずつ)で、形状は(batch_size, sequence_length, hidden_size)です。各層の出力におけるモデルのHidden-states、および任意の初期埋め込み出力。
attentions (
tuple(torch.Tensor)、optional、output_attentions=Trueが渡された場合またはconfig.output_attentions=Trueの場合に返されます) —torch.Tensorのタプル(各レイヤーごとに1つ)、形状は(batch_size, num_heads, sequence_length, sequence_length)。アテンションのsoftmax後のアテンション重み。自己アテンションヘッド内で加重平均を計算するために使用されます。
例:
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> inputs = processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output  # pooled CLS states
CLIPSegForImageSegmentation
クラス transformers.CLIPSegForImageSegmentation
< source >( config: CLIPSegConfig )
パラメータ
- config (CLIPSegConfig) — モデルのパラメータをすべて含むモデル設定クラスです。設定ファイルで初期化しても、モデルに関連する重みは読み込まれず、設定のみが読み込まれます。モデルの重みをロードするには、from_pretrained() メソッドを参照してください。
ゼロショットおよびワンショットの画像セグメンテーションに対応し、上部にTransformerベースのデコーダーを備えたCLIPSegモデル。
このモデルは PreTrainedModel を継承しています。すべてのモデルに実装されている汎用的なメソッド(ダウンロードや保存、入力埋め込みのリサイズ、ヘッドのプルーニングなど)については、スーパークラスのドキュメントを参照してください。
このモデルは、PyTorchのtorch.nn.Moduleのサブクラスでもあります。 通常のPyTorch Moduleとして使用し、一般的な使用方法や動作に関する詳細については、PyTorchのドキュメントを参照してください。
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneconditional_pixel_values: typing.Optional[torch.Tensor] = Noneconditional_embeddings: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneinterpolate_pos_encoding: bool = True**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CLIPSegOutput or tuple(torch.Tensor)
パラメータ
- input_ids (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — 語彙における入力シーケンスのトークンインデックスです。デフォルトでは、パディングは無視されます。インデックスはAutoTokenizerを使用して取得できます。詳細については、PreTrainedTokenizer.encode()およびPreTrainedTokenizer.call()を参照してください。
- pixel_values (
torch.Tensor、形状(batch_size, num_channels, image_size, image_size)、任意) — 入力画像に対応するテンソルです。ピクセル値は ViTImageProcessor を使用して取得できます。詳細は ViTImageProcessor.call() を参照してください(CLIPSegProcessor は画像の処理に ViTImageProcessor を使用します)。 - conditional_pixel_values (
torch.Tensor, 任意) — 条件付き画像のピクセル値です。 - conditional_embeddings (
torch.Tensor、形状(batch_size, config.projection_dim)、任意) — クエリ画像の条件付き埋め込みです。指定された場合、モデルは conditional_pixel_values から埋め込みを計算する代わりに、これを 사용합니다。 - attention_mask (
torch.Tensorの形状(batch_size, sequence_length), 、任意) — パディングトークンのインデックスに対するアテンションを回避するためのマスク。[0, 1]:- マスクされていないトークンに対して1
- マスクされたトークンに対しては 0 です。
- position_ids (
torch.LongTensorの形状(batch_size, sequence_length), 、任意) — 各入力シーケンスのトークンが位置埋め込み内で占める位置のインデックス。範囲[0, config.n_positions - 1]. - labels (
torch.Tensor、形状(batch_size, height, width)、任意) — 正解のセグメンテーションマスクです。値は[0, 1]の範囲にあり、logitsと同じ空間サイズを持ちます。予測された logits とこれらのマスクの間に、バイナリ交差エントロピー損失が計算されます。 - interpolate_pos_encoding (
bool、任意、デフォルトはTrue) — 事前学習済みの位置エンコーディングを補間するかどうかを指定します。
戻り値
CLIPSegOutput または tuple(torch.Tensor)
CLIPSegOutput、またはtorch.Tensorのタプル(return_dict=Falseが渡された場合、またはconfig.return_dict=Falseの場合)。設定(CLIPSegConfig)と入力に応じて、さまざまな要素で構成されます。
CLIPSegForImageSegmentation の forward メソッドは、__call__ という特殊メソッドをオーバーライドします。
この関数内でフォワードパスの手順を定義する必要がありますが、その後、この関数ではなく
Moduleインスタンスを呼び出すべきです。前者は前処理と後処理の実行を適切に処理するのに対し、後者はそれらを黙って無視するためです。
- loss (
torch.Tensor、shape(1,)、optional、return_lossがTrueの場合のみ返されます) — 画像とテキストの類似度に対する対比損失。 - logits_per_image (
torch.Tensor、形状(image_batch_size, text_batch_size)) —image_embedsとtext_embeds間のスケーリング済みドット積スコアです。これは画像とテキストの類似度スコアを表します。 - logits_per_text (
torch.Tensor、形状(text_batch_size, image_batch_size)) —text_embedsとimage_embeds間のスケーリングされたドット積スコアです。これはテキストと画像の類似度スコアを表します。 - text_embeds (
torch.Tensor、形状(batch_size, output_dim) — CLIPSegTextModel のプーリング済み出力に投影層を適用して得られたテキスト埋め込み。 - image_embeds (
torch.Tensor、形状(batch_size, output_dim) — CLIPSegVisionModelのプーリング済み出力に投影層を適用して得られた画像埋め込み。 - text_model_output (
~modeling_outputs.BaseModelOutputWithPooling、任意) — CLIPSegTextModel の出力です。 - vision_model_output (
~modeling_outputs.BaseModelOutputWithPooling、任意) — CLIPSegVisionModel の出力です。
例:
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image

>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)

>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")

>>> with torch.inference_mode():
...     outputs = model(**inputs)

>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])