
Transformers documentation
TVP
이 모델은 2023-03-09에 HF papers에 게시되었으며, 2023-11-22에 Hugging Face Transformers에 기여되었습니다.
TVP
개요
Yimeng Zhang, Xin Chen, Jinghan Jia, Sijia Liu, Ke Ding의 논문 Text-Visual Prompting for Efficient 2D Temporal Video Grounding에서 text-visual prompting(TVP) 프레임워크가 제안되었습니다.
해당 논문의 초록은 다음과 같습니다:
본 논문에서는 긴 트리밍되지 않은 비디오 내에서 텍스트 문장이 설명하는 순간의 시작/종료 시점을 예측하는 것을 목표로 하는 시간적 비디오 그라운딩(TVG) 문제를 연구합니다. 세밀한 3D 시각 특징 덕분에 TVG 기술은 최근 몇 년간 주목할 만한 진전을 이루었습니다. 그러나 3D 합성곱 신경망(CNN)의 높은 복잡성으로 인해 밀집된 3D 시각 특징 추출에 시간이 많이 소요되며, 이는 상당한 메모리와 컴퓨팅 리소스를 요구합니다. 효율적인 TVG를 위해, 우리는 TVG 모델의 시각 입력과 텍스트 특징 모두에 최적화된 교란 패턴(‘프롬프트’라고 부름)을 통합하는 새로운 텍스트-시각 프롬프팅(TVP) 프레임워크를 제안합니다. 3D CNN과 뚜렷하게 대비되게, TVP를 사용하면 2D TVG 모델에서 2D 시각 특징의 낮은 복잡성 희소 특징만을 사용하여 비전 인코더와 언어 인코더를 효과적으로 공동 학습하고, 크로스모달 특징 융합의 성능을 향상시킬 수 있음을 보여줍니다. 또한, TVG의 효율적인 학습을 위해 시간-거리 IoU(TDIoU) 손실을 제안합니다. Charades-STA와 ActivityNet Captions 데이터셋이라는 두 개의 벤치마크 데이터셋에 대한 실험은, 제안된 TVP가 2D TVG의 성능을 크게 향상시킨다는 것을 실증적으로 보여줍니다(예: Charades-STA에서 9.79% 향상, ActivityNet Captions에서 30.77% 향상) 그리고 3D 시각 특징을 사용하는 TVG에 비해 5배의 추론 가속을 달성합니다.
이 연구는 텍스트 문장으로 설명된 특정 이벤트의 시작 및 종료 시간을 긴 영상에서 정확히 파악하는 과정인 시간적 영상 기반화(Temporal Video Grounding, TVG)를 다룹니다. TVG를 향상시키기 위해 텍스트-시각 프롬프팅(TVP)을 제안합니다. TVP는 TVG 모델의 시각적(이미지 기반) 및 텍스트적(단어 기반) 입력 구성 요소에 특별히 설계된 패턴인 ‘프롬프트’를 통합하는 것을 포함합니다. 이러한 프롬프트는 추가적인 공간-시간적 맥락을 제공하여 모델이 영상 내 이벤트의 시간을 정확하게 결정하는 능력을 향상시킵니다. 이 접근법은 3D 입력 대신 2D 시각 입력을 사용합니다. 3D 입력은 더 많은 공간-시간적 세부 정보를 제공하지만 처리에 더 많은 시간이 소요됩니다. 프롬프팅 방법과 함께 2D 입력을 사용하는 것은 더 효율적으로 유사한 수준의 맥락과 정확도를 제공하는 것을 목표로 합니다.
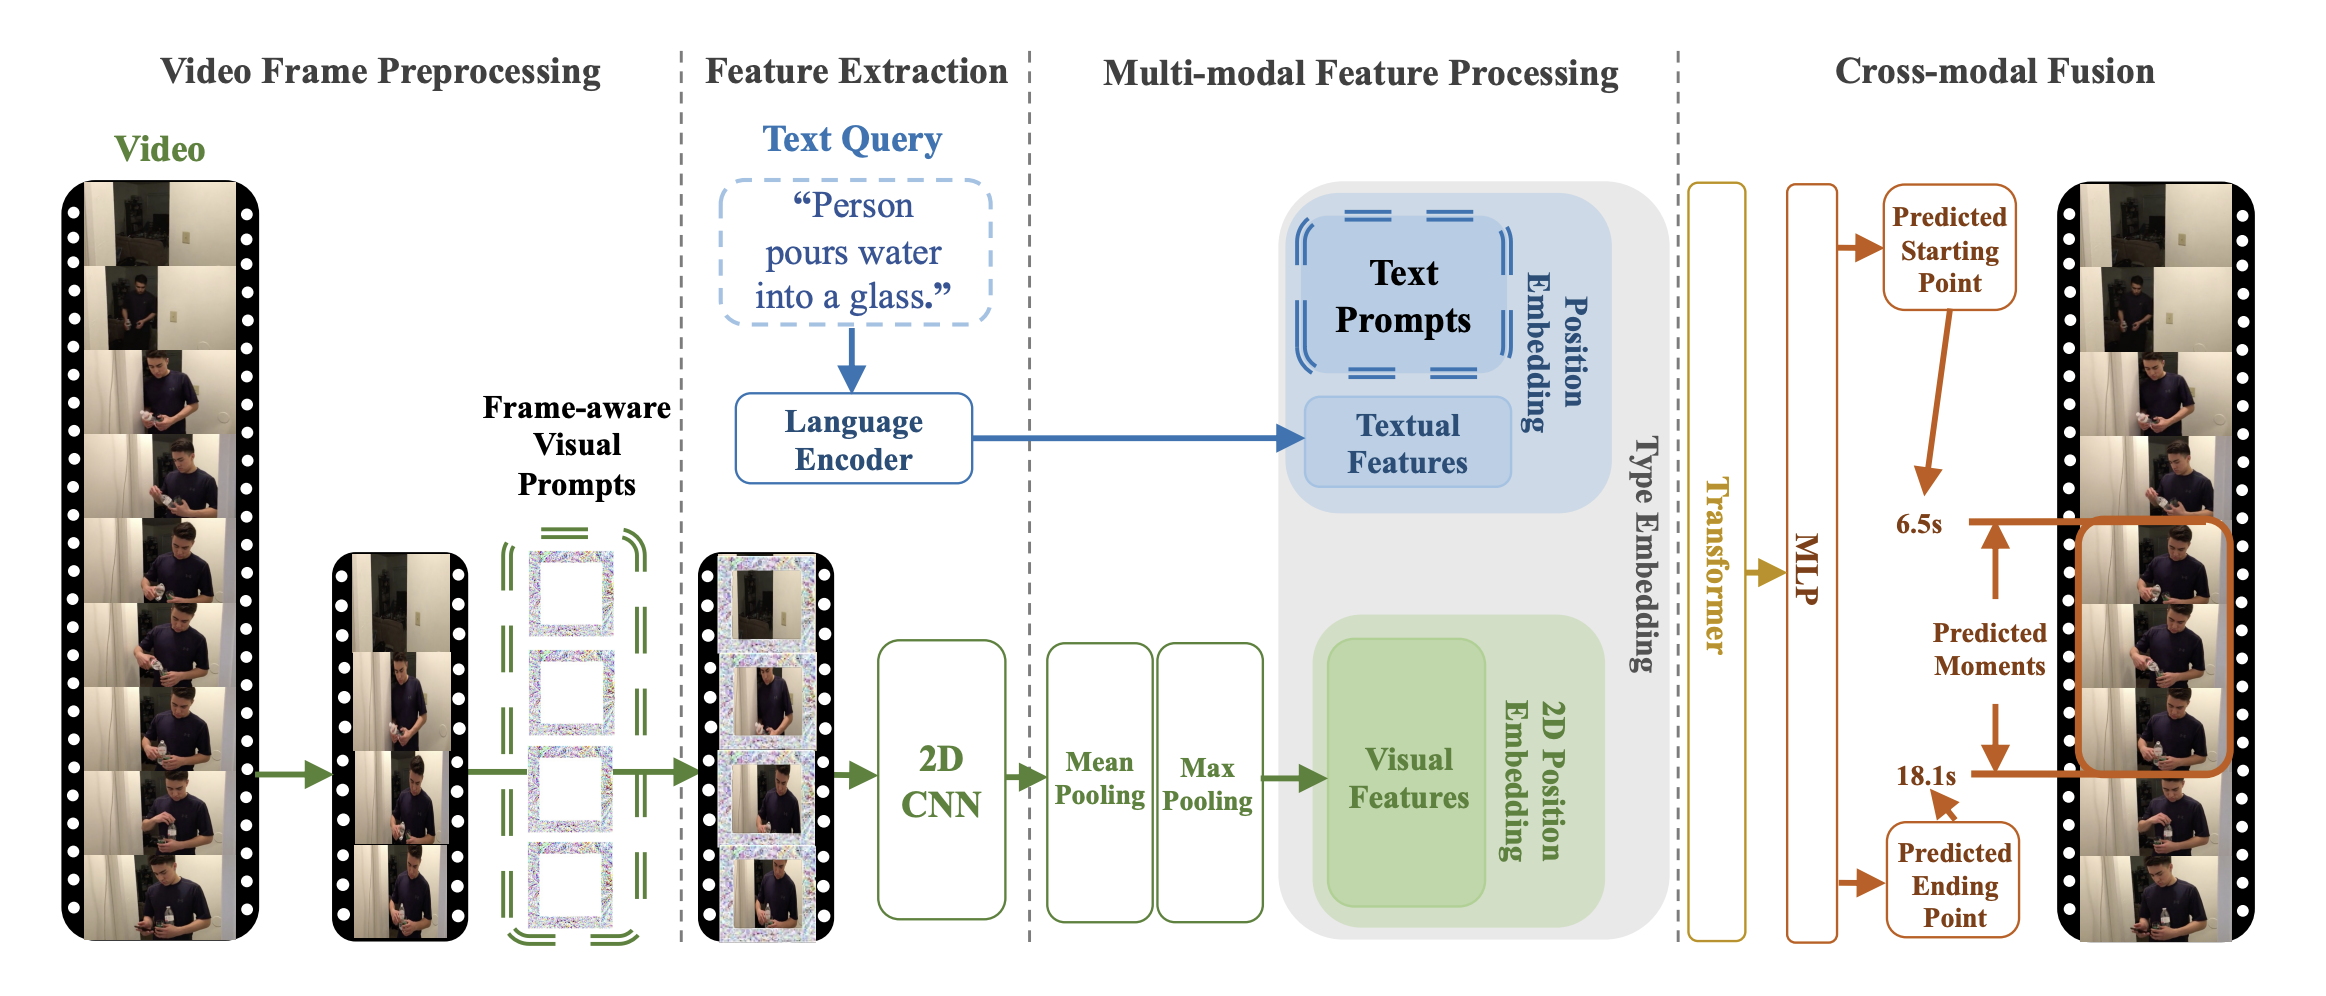 TVP architecture. Taken from the original paper.
이 모델은 Jiqing Feng님이 기여했습니다. 원본 코드는 여기에서 찾을 수 있습니다.
사용 팁 및 예제
Prompts는 입력 비디오 프레임이나 텍스트 특징에 추가되는 최적화된 교란 패턴입니다. Universal set은 모든 입력에 대해 동일한 prompts 세트를 사용하는 것을 의미하며, 이는 입력의 내용과 관계없이 모든 비디오 프레임과 텍스트 특징에 일관되게 prompts가 추가됨을 뜻합니다.
TVP은 시각 인코더와 크로스모달 인코더로 구성됩니다. 각각 샘플링된 비디오 프레임과 텍스트 특징에 통합될 보편적인 시각 프롬프트 세트와 텍스트 프롬프트 세트를 사용합니다. 특히, 하나의 트리밍되지 않은 비디오에서 균일하게 샘플링된 프레임에 서로 다른 시각 프롬프트 세트를 순서대로 적용합니다.
이 모델의 목표는 학습 가능한 프롬프트를 시각 입력과 텍스트 특징 모두에 통합하여 temporal video grounding(TVG) 문제를 해결하는 것입니다. 원칙적으로, 제안된 아키텍처에는 어떤 시각 및 크로스모달 인코더든 적용할 수 있습니다.
TvpProcessor는 BertTokenizer와 TvpImageProcessor를 단일 인스턴스로 묶어 텍스트 인코딩과 이미지 전처리 작업을 수행합니다.
다음 예제는 TvpProcessor와 TvpForVideoGrounding를 사용하여 시간적 비디오 그라운딩을 실행하는 방법을 보여줍니다.
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download

from transformers import AutoProcessor, TvpForVideoGrounding


def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
    '''
    Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
    Args:
        container (container): pyav container.
        sampling_rate (int): frame sampling rate (interval between two sampled frames).
        num_frames (int): number of frames to sample.
        clip_idx (int): if clip_idx is -1, perform random temporal sampling.
            If clip_idx is larger than -1, uniformly split the video to num_clips
            clips, and select the clip_idx-th video clip.
        num_clips (int): overall number of clips to uniformly sample from the given video.
        target_fps (int): the input video may have different fps, convert it to
            the target video fps before frame sampling.
    Returns:
        frames (tensor): decoded frames from the video. Return None if the no
            video stream was found.
        fps (float): the number of frames per second of the video.
    '''
    video = container.streams.video[0]
    fps = float(video.average_rate)
    clip_size = sampling_rate * num_frames / target_fps * fps
    delta = max(num_frames - clip_size, 0)
    start_idx = delta * clip_idx / num_clips
    end_idx = start_idx + clip_size - 1
    timebase = video.duration / num_frames
    video_start_pts = int(start_idx * timebase)
    video_end_pts = int(end_idx * timebase)
    seek_offset = max(video_start_pts - 1024, 0)
    container.seek(seek_offset, any_frame=False, backward=True, stream=video)
    frames = {}
    for frame in container.decode(video=0):
        if frame.pts < video_start_pts:
            continue
        frames[frame.pts] = frame
        if frame.pts > video_end_pts:
            break
    frames = [frames[pts] for pts in sorted(frames)]
    return frames, fps


def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
    '''
    Decode the video and perform temporal sampling.
    Args:
        container (container): pyav container.
        sampling_rate (int): frame sampling rate (interval between two sampled frames).
        num_frames (int): number of frames to sample.
        clip_idx (int): if clip_idx is -1, perform random temporal sampling.
            If clip_idx is larger than -1, uniformly split the video to num_clips
            clips, and select the clip_idx-th video clip.
        num_clips (int): overall number of clips to uniformly sample from the given video.
        target_fps (int): the input video may have different fps, convert it to
            the target video fps before frame sampling.
    Returns:
        frames (tensor): decoded frames from the video.
    '''
    assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
    frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
    clip_size = sampling_rate * num_frames / target_fps * fps
    index = np.linspace(0, clip_size - 1, num_frames)
    index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
    frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
    frames = frames.transpose(0, 3, 1, 2)
    return frames


file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")

decoder_kwargs = dict(
    container=av.open(file, metadata_errors="ignore"),
    sampling_rate=1,
    num_frames=model.config.num_frames,
    clip_idx=0,
    num_clips=1,
    target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)

text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
    text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)

model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)

def get_video_duration(filename):
    cap = cv2.VideoCapture(filename)
    if cap.isOpened():
        rate = cap.get(5)
        frame_num = cap.get(7)
        duration = frame_num/rate
        return duration
    return -1

duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)

print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
팁:
- 이 TVP 구현에서는 BertTokenizer를 사용하여 텍스트 임베딩을 생성하고 Resnet-50 모델을 사용하여 시각 임베딩을 계산합니다.
- 사전 학습된 tvp-base의 체크포인트가 공개되었습니다.
- TVP의 Temporal Video Grounding 작업 성능에 대해서는 표 2를 참조하세요.
TvpConfig
클래스 transformers.TvpConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonedistance_loss_weight: float = 1.0duration_loss_weight: float = 0.1visual_prompter_type: str = 'framepad'visual_prompter_apply: str = 'replace'visual_prompt_size: int = 96max_img_size: int = 448num_frames: int = 48vocab_size: int = 30522type_vocab_size: int = 2hidden_size: int = 768intermediate_size: int = 3072num_hidden_layers: int = 12num_attention_heads: int = 12max_position_embeddings: int = 512max_grid_col_position_embeddings: int = 100max_grid_row_position_embeddings: int = 100hidden_dropout_prob: float | int = 0.1hidden_act: str = 'gelu'layer_norm_eps: float = 1e-12initializer_range: float = 0.02attention_probs_dropout_prob: float | int = 0.1pad_token_id: int | None = None )
매개변수
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], 선택) — backbone 모델의 설정입니다. - distance_loss_weight (
float, 선택 사항, 기본값 1.0) — 거리 손실의 가중치입니다. - duration_loss_weight (
float, 선택 사항, 기본값 0.1) — duration loss의 가중치입니다. - visual_prompter_type (
str, 선택 사항, 기본값"framepad") — 시각 프롬프트 유형입니다. 패딩의 유형을 지정합니다. Framepad는 각 프레임에 패딩을 적용하는 것을 의미합니다. “framepad” 또는 “framedownpad” 중 하나여야 합니다. - visual_prompter_apply (
str, optional, 기본값"replace") — 시각 프롬프트를 적용하는 방식입니다. replace는 시각 입력의 원래 값을 프롬프트의 값으로 변경하는 것을 의미합니다. “replace”, “add”, “remove” 중 하나여야 합니다. - visual_prompt_size (
int, 선택 사항, 기본값 96) — 시각 프롬프트의 크기입니다. - max_img_size (
int, 선택 사항, 기본값 448) — 프레임의 최대 크기입니다. - num_frames (
int, 선택 사항, 기본값 48) — 비디오에서 추출할 프레임 수입니다. - vocab_size (
int, 선택 사항, 기본값30522) — 모델의 어휘 크기입니다.input_ids로 표현할 수 있는 서로 다른 토큰의 수를 정의합니다. - type_vocab_size (
int, 선택 사항, 기본값2) —token_type_ids의 어휘 크기입니다. - hidden_size (
int, 선택 사항, 기본값768) — 숨겨진 표현의 차원입니다. - intermediate_size (
int, 선택 사항, 기본값3072) — MLP 표현의 차원입니다. - num_hidden_layers (
int, 선택 사항, 기본값12) — Transformer 디코더의 숨겨진 레이어 수. - num_attention_heads (
int, 선택 사항, 기본값12) — Transformer decoder의 각 attention layer에 사용할 attention head의 수입니다. - max_position_embeddings (
int, 선택 사항, 기본값 512) — 이 모델이 사용될 수 있는 최대 시퀀스 길이입니다. 혹시 모를 상황에 대비하여 일반적으로 큰 값(예: 512, 1024, 2048)으로 설정합니다. - max_grid_col_position_embeddings (
int, 선택 사항, 기본값 100) — 비디오 프레임의 가로 패치 최대 개수입니다. - max_grid_row_position_embeddings (
int, 선택 사항, 기본값 100) — 비디오 프레임의 세로 패치 최대 개수입니다. - hidden_dropout_prob (
Union[float, int], 선택 사항, 기본값0.1) — 임베딩, 인코더, 풀러의 모든 완전 연결 계층에 적용되는 드롭아웃 확률입니다. - hidden_act (
str, 선택 사항, 기본값gelu) — 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열)입니다. 예를 들어,"gelu","relu","silu"등이 있습니다. - layer_norm_eps (
float, 선택 사항, 기본값1e-12) — 레이어 정규화 레이어에서 사용되는 epsilon 값입니다. - initializer_range (
float, 선택 사항, 기본값0.02) — 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다. - attention_probs_dropout_prob (
Union[float, int], 선택 사항, 기본값0.1) — Attention 확률에 적용할 dropout 비율입니다. - pad_token_id (
int, 선택 사항) — 어휘에서 패딩에 사용되는 토큰 ID입니다.
이것은 TvpModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Tvp 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 Intel/tvp-base와 유사한 구성이 생성됩니다.
Configuration 객체는 PreTrainedConfig를 상속하며 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 PreTrainedConfig의 문서를 참고하세요.
TvpImageProcessor
class transformers.TvpImageProcessor
< source >( **kwargs: *<class 'transformers.models.tvp.image_processing_tvp.TvpImageProcessorKwargs'> )
매개변수
- do_convert_rgb (
bool, kwargs, 선택 사항) — 이미지를 RGB로 변환할지 여부입니다. - do_resize (
bool, kwargs, 선택 사항, 기본값True) — 이미지를 리사이즈할지 여부. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'longest_edge' -- 448}): 모델에 입력되는 최대 입력 차원을 설명합니다. - default_to_square (
bool, kwargs, 선택 사항, 기본값False) — size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'height' -- 448, 'width': 448}):center_crop을 적용한 후의 출력 이미지 크기입니다. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, 기본값2) — 이미지 크기를 조정할 때 사용할 리샘플링 필터입니다.PILImageResamplingenum 중 하나를 사용할 수 있습니다.do_resize가True로 설정된 경우에만 효과가 있습니다. - do_rescale (
bool, kwargs, 선택, 기본값True) — 이미지를 다시 스케일링할지 여부. - rescale_factor (
float, kwargs, 선택 사항, 기본값0.00392156862745098) —do_rescale이True로 설정된 경우 이미지를 재조정(rescale)하는 데 사용할 재조정 계수입니다. - do_normalize (
bool, kwargs, 선택, 기본값True) — 이미지를 정규화할지 여부. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, 선택, 기본값[0.5, 0.5, 0.5]) — 정규화에 사용할 이미지 평균입니다.do_normalize가True로 설정된 경우에만 효과가 있습니다. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, 선택, 기본값[0.5, 0.5, 0.5]) — 정규화에 사용할 이미지 표준 편차.do_normalize가True로 설정된 경우에만 효과가 있습니다. - do_pad (
bool, kwargs, 선택, 기본값True) — 이미지에 패딩을 적용할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'height' -- 448, 'width': 448}): 이미지를 패딩할{"height": int, "width" int}크기를 지정합니다. 전처리를 위해 제공된 모든 이미지 크기보다 커야 합니다.pad_size가 제공되지 않으면 배치 내 가장 큰 높이와 너비로 패딩됩니다.do_pad=True.일 때만 적용됩니다. - do_center_crop (
bool, kwargs, 선택, 기본값True) — 이미지를 중앙으로 크롭할지 여부. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) —ChannelDimension.FIRST만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) — 입력 이미지의 채널 차원 형식입니다. 설정되지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다:"channels_first"또는ChannelDimension.FIRST: (num_channels, height, width) 형식의 이미지."channels_last"또는ChannelDimension.LAST: (height, width, num_channels) 형식의 이미지."none"또는ChannelDimension.NONE: (height, width) 형식의 이미지.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 동영상을 처리할 장치입니다. 설정되지 않은 경우, 입력 동영상에서 장치를 추론합니다. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다. - disable_grouping (
bool, kwargs, 선택 사항) — 이미지를 크기에 따라 그룹화하는 것을 비활성화하여 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다. - image_seq_length (
int, kwargs, 선택 사항) — 입력에서 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다. - do_flip_channel_order (
bool, kwargs, 선택 사항, 기본값self.do_flip_channel_order) — 이미지의 채널 순서를 RGB에서 BGR으로 변경할지 여부입니다. - constant_values (
float, kwargs 또는List[float], 선택, 기본값self.constant_values) —pad_mode가'constant'일 때 패딩 영역을 채우는 데 사용되는 값. - pad_mode (
str, kwargs, 선택 사항, 기본값self.pad_mode) — 사용할 패딩 모드 —'constant','edge','reflect'또는'symmetric'.
TvpImageProcessor 이미지 프로세서를 생성합니다.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]]**kwargs: *<class 'transformers.models.tvp.image_processing_tvp.TvpImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
매개변수
- videos (
ImageInput또는list[ImageInput]또는list[list[ImageInput]]) — 전처리할 프레임. - do_convert_rgb (
bool, kwargs, 선택 사항) — 이미지를 RGB로 변환할지 여부입니다. - do_resize (
bool, kwargs, 선택) — 이미지를 리사이즈할지 여부. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 모델의 최대 입력 차원을 설명합니다. - default_to_square (
bool, kwargs, 선택 사항) — size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_crop을 적용한 후 출력 이미지의 크기. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 이미지를 리사이즈할 경우 사용할 리샘플링 필터입니다. 이는PILImageResamplingenum 중 하나일 수 있습니다.do_resize가True로 설정된 경우에만 효과가 있습니다. - do_rescale (
bool, kwargs, 선택 사항) — 이미지를 다시 스케일링할지 여부입니다. - rescale_factor (
float, kwargs, optional) —do_rescale이True로 설정된 경우 이미지를 리스케일하기 위한 리스케일 팩터입니다. - do_normalize (
bool, kwargs, optional) — 이미지를 정규화할지 여부. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, 선택) — 정규화에 사용할 이미지 평균입니다.do_normalize가True로 설정된 경우에만 효과가 있습니다. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, 선택) — 정규화에 사용할 이미지 표준 편차.do_normalize가True로 설정된 경우에만 효과가 있습니다. - do_pad (
bool, kwargs, optional) — 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 이미지를 패딩할{"height": int, "width" int}크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다.pad_size가 제공되지 않으면, 배치 내 가장 큰 높이와 너비로 패딩됩니다.do_pad=True.일 때만 적용됩니다. - do_center_crop (
bool, kwargs, 선택) — 이미지를 중앙으로 크롭할지 여부. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) —ChannelDimension.FIRST만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) — 입력 이미지의 채널 차원 형식입니다. 설정되지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다:"channels_first"또는ChannelDimension.FIRST: (num_channels, height, width) 형식의 이미지."channels_last"또는ChannelDimension.LAST: (height, width, num_channels) 형식의 이미지."none"또는ChannelDimension.NONE: (height, width) 형식의 이미지.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 동영상을 처리할 장치입니다. 설정되지 않은 경우, 입력 동영상에서 장치를 추론합니다. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다. - disable_grouping (
bool, kwargs, 선택 사항) — 이미지를 크기에 따라 그룹화하는 것을 비활성화하여 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다. - image_seq_length (
int, kwargs, 선택 사항) — 입력에서 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다. - do_flip_channel_order (
bool, kwargs, 선택 사항, 기본값self.do_flip_channel_order) — 이미지의 채널 순서를 RGB에서 BGR으로 변경할지 여부입니다. - constant_values (
float, kwargs 또는List[float], 선택, 기본값self.constant_values) —pad_mode가'constant'일 때 패딩 영역을 채우는 데 사용되는 값. - pad_mode (
str, kwargs, 선택 사항, 기본값self.pad_mode) — 사용할 패딩 모드 —'constant','edge','reflect'또는'symmetric'.
반환값
~image_processing_base.BatchFeature
- data (
dict) — call 메서드가 반환하는 리스트/배열/텐서 딕셔너리(‘pixel_values’ 등). - tensor_type (
Union[None, str, TensorType], 선택 사항) — 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type를 지정할 수 있습니다.
TvpImageProcessorPil
class transformers.TvpImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.tvp.image_processing_pil_tvp.TvpImageProcessorKwargs'> )
매개변수
- do_convert_rgb (
bool, kwargs, 선택 사항) — 이미지를 RGB로 변환할지 여부입니다. - do_resize (
bool, kwargs, 선택 사항, 기본값True) — 이미지를 리사이즈할지 여부. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'longest_edge' -- 448}): 모델에 입력되는 최대 입력 차원을 설명합니다. - default_to_square (
bool, kwargs, 선택 사항, 기본값False) — size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'height' -- 448, 'width': 448}):center_crop을 적용한 후의 출력 이미지 크기입니다. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, 기본값2) — 이미지 크기를 조정할 때 사용할 리샘플링 필터입니다.PILImageResamplingenum 중 하나를 사용할 수 있습니다.do_resize가True로 설정된 경우에만 효과가 있습니다. - do_rescale (
bool, kwargs, 선택, 기본값True) — 이미지를 다시 스케일링할지 여부. - rescale_factor (
float, kwargs, 선택 사항, 기본값0.00392156862745098) —do_rescale이True로 설정된 경우 이미지를 재조정(rescale)하는 데 사용할 재조정 계수입니다. - do_normalize (
bool, kwargs, 선택, 기본값True) — 이미지를 정규화할지 여부. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, 선택, 기본값[0.5, 0.5, 0.5]) — 정규화에 사용할 이미지 평균입니다.do_normalize가True로 설정된 경우에만 효과가 있습니다. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, 선택, 기본값[0.5, 0.5, 0.5]) — 정규화에 사용할 이미지 표준 편차.do_normalize가True로 설정된 경우에만 효과가 있습니다. - do_pad (
bool, kwargs, 선택, 기본값True) — 이미지에 패딩을 적용할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, 기본값{'height' -- 448, 'width': 448}): 이미지를 패딩할{"height": int, "width" int}크기를 지정합니다. 전처리를 위해 제공된 모든 이미지 크기보다 커야 합니다.pad_size가 제공되지 않으면 배치 내 가장 큰 높이와 너비로 패딩됩니다.do_pad=True.일 때만 적용됩니다. - do_center_crop (
bool, kwargs, 선택, 기본값True) — 이미지를 중앙으로 크롭할지 여부. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) —ChannelDimension.FIRST만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) — 입력 이미지의 채널 차원 형식입니다. 설정되지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다:"channels_first"또는ChannelDimension.FIRST: (num_channels, height, width) 형식의 이미지."channels_last"또는ChannelDimension.LAST: (height, width, num_channels) 형식의 이미지."none"또는ChannelDimension.NONE: (height, width) 형식의 이미지.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 동영상을 처리할 장치입니다. 설정되지 않은 경우, 입력 동영상에서 장치를 추론합니다. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다. - disable_grouping (
bool, kwargs, 선택 사항) — 이미지를 크기에 따라 그룹화하는 것을 비활성화하여 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다. - image_seq_length (
int, kwargs, 선택 사항) — 입력에서 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다. - do_flip_channel_order (
bool, kwargs, 선택 사항, 기본값self.do_flip_channel_order) — 이미지의 채널 순서를 RGB에서 BGR으로 변경할지 여부입니다. - constant_values (
float, kwargs 또는List[float], 선택, 기본값self.constant_values) —pad_mode가'constant'일 때 패딩 영역을 채우는 데 사용되는 값. - pad_mode (
str, kwargs, 선택 사항, 기본값self.pad_mode) — 사용할 패딩 모드 —'constant','edge','reflect'또는'symmetric'.
TvpImageProcessor 이미지 프로세서를 생성합니다.
preprocess
< source >( videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]]**kwargs: *<class 'transformers.models.tvp.image_processing_pil_tvp.TvpImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
매개변수
- videos (
ImageInput또는list[ImageInput]또는list[list[ImageInput]]) — 전처리할 프레임. - do_convert_rgb (
bool, kwargs, 선택 사항) — 이미지를 RGB로 변환할지 여부입니다. - do_resize (
bool, kwargs, 선택) — 이미지를 리사이즈할지 여부. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 모델의 최대 입력 차원을 설명합니다. - default_to_square (
bool, kwargs, 선택 사항) — size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_crop을 적용한 후 출력 이미지의 크기. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — 이미지를 리사이즈할 경우 사용할 리샘플링 필터입니다. 이는PILImageResamplingenum 중 하나일 수 있습니다.do_resize가True로 설정된 경우에만 효과가 있습니다. - do_rescale (
bool, kwargs, 선택 사항) — 이미지를 다시 스케일링할지 여부입니다. - rescale_factor (
float, kwargs, optional) —do_rescale이True로 설정된 경우 이미지를 리스케일하기 위한 리스케일 팩터입니다. - do_normalize (
bool, kwargs, optional) — 이미지를 정규화할지 여부. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, 선택) — 정규화에 사용할 이미지 평균입니다.do_normalize가True로 설정된 경우에만 효과가 있습니다. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, 선택) — 정규화에 사용할 이미지 표준 편차.do_normalize가True로 설정된 경우에만 효과가 있습니다. - do_pad (
bool, kwargs, optional) — 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — 이미지를 패딩할{"height": int, "width" int}크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다.pad_size가 제공되지 않으면, 배치 내 가장 큰 높이와 너비로 패딩됩니다.do_pad=True.일 때만 적용됩니다. - do_center_crop (
bool, kwargs, 선택) — 이미지를 중앙으로 크롭할지 여부. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) —ChannelDimension.FIRST만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, 선택 사항) — 입력 이미지의 채널 차원 형식입니다. 설정되지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다:"channels_first"또는ChannelDimension.FIRST: (num_channels, height, width) 형식의 이미지."channels_last"또는ChannelDimension.LAST: (height, width, num_channels) 형식의 이미지."none"또는ChannelDimension.NONE: (height, width) 형식의 이미지.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — 동영상을 처리할 장치입니다. 설정되지 않은 경우, 입력 동영상에서 장치를 추론합니다. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다. - disable_grouping (
bool, kwargs, 선택 사항) — 이미지를 크기에 따라 그룹화하는 것을 비활성화하여 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다. - image_seq_length (
int, kwargs, 선택 사항) — 입력에서 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다. - do_flip_channel_order (
bool, kwargs, 선택 사항, 기본값self.do_flip_channel_order) — 이미지의 채널 순서를 RGB에서 BGR으로 변경할지 여부입니다. - constant_values (
float, kwargs 또는List[float], 선택, 기본값self.constant_values) —pad_mode가'constant'일 때 패딩 영역을 채우는 데 사용되는 값. - pad_mode (
str, kwargs, 선택 사항, 기본값self.pad_mode) — 사용할 패딩 모드 —'constant','edge','reflect'또는'symmetric'.
반환값
~image_processing_base.BatchFeature
- data (
dict) — call 메서드가 반환하는 리스트/배열/텐서 딕셔너리(‘pixel_values’ 등). - tensor_type (
Union[None, str, TensorType], 선택 사항) — 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type를 지정할 수 있습니다.
TvpProcessor
클래스 transformers.TvpProcessor
< source >( image_processor = Nonetokenizer = None**kwargs )
이미지 프로세서와 토크나이저를 단일 프로세서로 감싸는 TvpProcessor를 생성합니다.
TvpProcessor는 TvpImageProcessor와 BertTokenizer의 모든 기능을 제공합니다. 자세한 내용은 ~TvpImageProcessor와 ~BertTokenizer를 참고하세요.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | list[list[str]] | None = Nonevideos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = Noneaudio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.processing_utils.ProcessingKwargs'> )
매개변수
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], 선택) — 전처리할 이미지입니다. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 사이인 이미지를 전달하는 경우do_rescale=False로 설정하세요. - text (
Union[str, list[str], list[list[str]]], 선택 사항) — 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 사전 토큰화된 입력을 전달하는 경우, 배치 입력과의 혼동을 피하기 위해is_split_into_words=True를 설정하세요. - videos (
Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]], 선택) — 전처리할 비디오입니다. 픽셀 값이 0에서 255 범위를 가지는 단일 비디오 또는 비디오 배치(batch)를 기대합니다. 픽셀 값이 0에서 1 범위를 가지는 비디오를 전달하는 경우do_rescale=False로 설정하십시오. - audio (
Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]], 선택 사항) — 준비할 오디오 또는 오디오 배치입니다. 각 오디오는 NumPy 배열 또는 PyTorch 텐서일 수 있습니다. NumPy 배열/PyTorch 텐서의 경우, 각 오디오의 shape은 (C, T)여야 하며, 여기서 C는 채널 수, T는 오디오의 샘플 길이입니다. - return_tensors (
str또는 TensorType, 선택 사항) — 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다:'pt': PyTorchtorch.Tensor객체를 반환합니다.'np': NumPynp.ndarray객체를 반환합니다.
- **kwargs (ProcessingKwargs, 선택) — 각 모달리티(텍스트, 이미지, 비디오, 오디오)에 대한 추가 처리 옵션입니다. 모델별 매개변수는 위에 나열되어 있으며, 지원되는 인수의 전체 목록은 TypedDict 클래스를 참조하세요.
TvpModel
class transformers.TvpModel
< source >( config: TvpConfig )
매개변수
- config (TvpConfig) — 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 from_pretrained() 메서드를 확인하세요.
Model은 특정 헤드가 없는 BaseModelOutputWithPooling 객체를 출력하는 기본 Transformer입니다.
이 모델은 PreTrainedModel에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대한 세부 사항은 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch torch.nn.Module의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법 및 동작과 관련된 모든 사항은 PyTorch 문서를 참조하세요.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs ) → BaseModelOutputWithPooling or tuple(torch.Tensor)
매개변수
- input_ids (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 어휘(input vocabulary)에서 입력 시퀀스 토큰의 인덱스입니다. 기본적으로 패딩은 무시됩니다.AutoTokenizer를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 PreTrainedTokenizer.encode() 및 PreTrainedTokenizer.call()를 참조하세요.
- pixel_values (
torch.Tensor, shape(batch_size, num_channels, image_size, image_size), 선택 사항) — 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 TvpImageProcessor를 사용하여 얻을 수 있습니다. 자세한 내용은 TvpImageProcessor.call()를 참조하세요 (TvpProcessor는 이미지 처리에 TvpImageProcessor를 사용합니다). - attention_mask (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 하는 마스크. [0, 1]에서 선택된 마스크 값: 마스크되지 않은 토큰은 1, 마스크된 토큰은 0. attention mask란 무엇인가요?[0, 1]:- 마스크되지 않은 토큰에 대해 1
- 마스크된 토큰에 대해 0
- output_attentions (
bool, 선택 사항) — 모든 attention 레이어의 attentions 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의attentions항목을 참조하세요. - output_hidden_states (
bool, 선택 사항) — 모든 레이어의 hidden states를 반환할지 여부입니다. 자세한 내용은 반환되는 텐서 중hidden_states항목을 참고하세요. - return_dict (
bool, 선택) — 일반 튜플 대신 ModelOutput를 반환할지 여부. - interpolate_pos_encoding (
bool, 선택 사항, 기본값False) — 사전 학습된 위치 인코딩을 보간할지 여부입니다.
반환값
BaseModelOutputWithPooling 또는 tuple(torch.Tensor)
torch.Tensor의 튜플 또는 BaseModelOutputWithPooling입니다. 구성(TvpConfig)과 입력에 따라 다양한 요소를 포함하며, return_dict=False가 전달되었거나 config.return_dict=False인 경우에도 동일합니다.
TvpModel의 forward 메서드는 __call__ 특수 메서드를 오버라이드합니다.
이 함수 내에서 forward pass의 레시피를 정의해야 하지만, 이후에는 이 함수 대신
Module인스턴스를 호출해야 합니다. 전자는 전처리 및 후처리 단계를 실행하는 것을 처리하는 반면, 후자는 이를 조용히 무시하기 때문입니다.
last_hidden_state (
torch.Tensor, shape(batch_size, sequence_length, hidden_size)) — 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.pooler_output (
torch.Tensor, shape(batch_size, hidden_size)) — 보조 사전 학습 작업을 위해 사용되는 레이어들을 통해 추가 처리된 시퀀스의 첫 번째 토큰(분류 토큰)의 마지막 레이어 hidden-state입니다. 예를 들어 BERT 계열 모델의 경우, 선형 레이어와 tanh 활성화 함수를 통해 처리된 후의 분류 토큰을 반환합니다. 선형 레이어의 가중치는 사전 학습 동안 다음 문장 예측(분류) 목적 함수를 통해 학습됩니다.hidden_states (
tuple(torch.Tensor), 선택 사항,output_hidden_states=True가 전달되거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
attentions (
tuple(torch.Tensor), 선택 사항,output_attentions=True가 전달되었거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치.
예:
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel

>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")

>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")

>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
TvpForVideoGrounding
class transformers.TvpForVideoGrounding
< source >( config: TvpConfig )
매개변수
- config (TvpConfig) — 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 from_pretrained() 메서드를 확인하세요.
IoU, 거리, 지속 시간 손실을 계산하는 비디오 그라운딩 헤드가 위에 있는 Tvp 모델.
이 모델은 PreTrainedModel에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대한 세부 사항은 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch torch.nn.Module의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법 및 동작과 관련된 모든 사항은 PyTorch 문서를 참조하세요.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Nonepixel_values: typing.Optional[torch.Tensor] = Noneattention_mask: typing.Optional[torch.LongTensor] = Nonelabels: tuple[torch.Tensor] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = Noneinterpolate_pos_encoding: bool = False**kwargs ) → TvpVideoGroundingOutput or tuple(torch.Tensor)
매개변수
- input_ids (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 어휘(input vocabulary)에서 입력 시퀀스 토큰의 인덱스입니다. 기본적으로 패딩은 무시됩니다.AutoTokenizer를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 PreTrainedTokenizer.encode() 및 PreTrainedTokenizer.call()를 참조하세요.
- pixel_values (
torch.Tensor, shape(batch_size, num_channels, image_size, image_size), 선택 사항) — 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 TvpImageProcessor를 사용하여 얻을 수 있습니다. 자세한 내용은 TvpImageProcessor.call()를 참조하세요 (TvpProcessor는 이미지 처리에 TvpImageProcessor를 사용합니다). - attention_mask (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 하는 마스크. [0, 1]에서 선택된 마스크 값: 마스크되지 않은 토큰은 1, 마스크된 토큰은 0. attention mask란 무엇인가요?[0, 1]:- 마스크되지 않은 토큰에 대해 1
- 마스크된 토큰에 대해 0
- labels (
torch.Tensor, shape(batch_size, 3), 선택 사항) — 텍스트에 해당하는 비디오의 길이, 시작 시간, 종료 시간을 포함하는 라벨입니다. - output_attentions (
bool, 선택 사항) — 모든 attention 레이어의 attentions 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의attentions항목을 참조하세요. - output_hidden_states (
bool, 선택 사항) — 모든 레이어의 hidden states를 반환할지 여부입니다. 자세한 내용은 반환되는 텐서 중hidden_states항목을 참고하세요. - return_dict (
bool, 선택) — 일반 튜플 대신 ModelOutput를 반환할지 여부. - interpolate_pos_encoding (
bool, 선택 사항, 기본값False) — 사전 학습된 위치 인코딩을 보간할지 여부입니다.
반환값
TvpVideoGroundingOutput 또는 tuple(torch.Tensor)
TvpVideoGroundingOutput 또는 torch.Tensor의 튜플(return_dict=False가 전달되었거나 config.return_dict=False인 경우)로, 구성(TvpConfig)과 입력에 따라 다양한 요소를 포함합니다.
TvpForVideoGrounding의 forward 메서드는 __call__ 특수 메서드를 오버라이드합니다.
이 함수 내에서 forward pass의 레시피를 정의해야 하지만, 이후에는 이 함수 대신
Module인스턴스를 호출해야 합니다. 전자는 전처리 및 후처리 단계를 실행하는 것을 처리하는 반면, 후자는 이를 조용히 무시하기 때문입니다.
loss (
torch.Tensor, shape(1,), optional,return_loss이True일 때 반환됨) — 비디오 grounding을 위한 Temporal-Distance IoU loss.logits (
torch.Tensor, shape(batch_size, 2)) — start_time/duration과 end_time/duration을 포함합니다. 입력 텍스트에 해당하는 비디오의 시간 슬롯입니다.hidden_states (
tuple[torch.Tensor, ...], 선택 사항,output_hidden_states=True가 전달되거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
attentions (
tuple(torch.Tensor), 선택 사항,output_attentions=True가 전달되었거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.
예:
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding

>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")

>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")

>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)