
Transformers documentation
OneFormer
Este modelo foi publicado no HF papers em 2022-11-10 e contribuído para o Hugging Face Transformers em 2023-01-19.
OneFormer
Visão geral
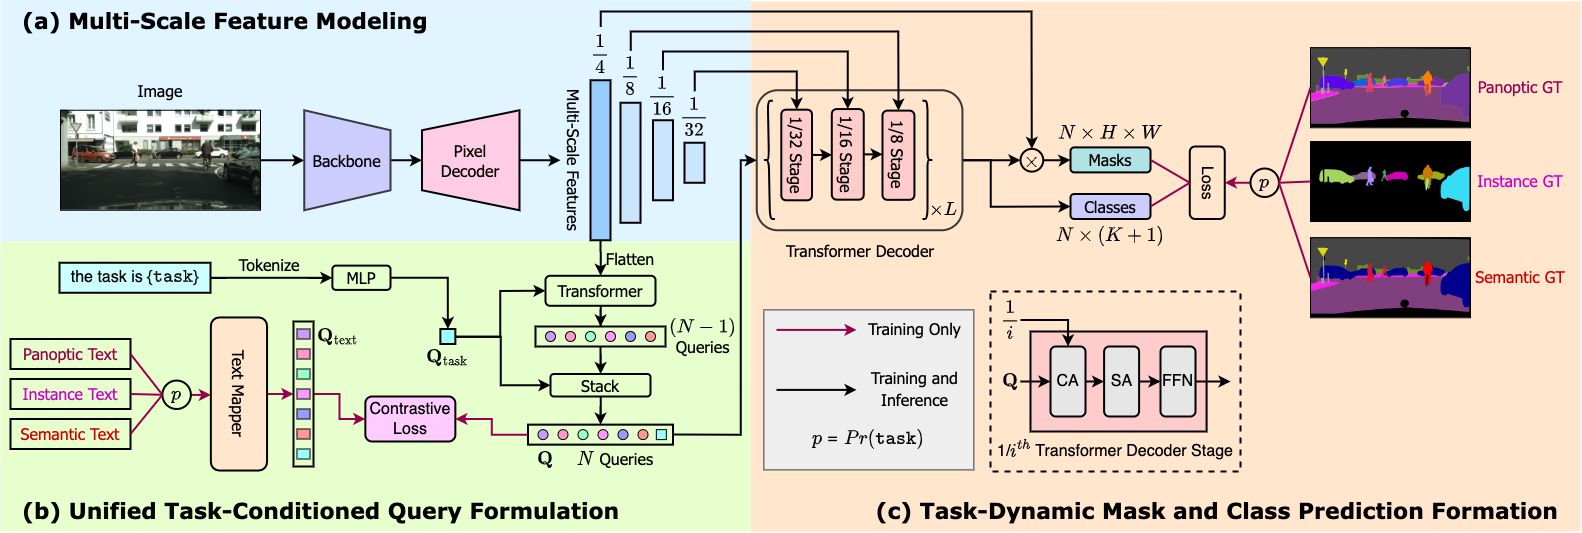
O modelo OneFormer foi proposto em OneFormer: One Transformer to Rule Universal Image Segmentation por Jitesh Jain, Jiachen Li, MangTik Chiu, Ali Hassani, Nikita Orlov, Humphrey Shi. O OneFormer é um framework universal de segmentação de imagens que pode ser treinado em um único dataset panótico para executar tarefas de segmentação semântica, de instância e panótica. O OneFormer usa um task token para condicionar o modelo na tarefa em foco, tornando a arquitetura orientada por tarefa para o treinamento e dinâmica por tarefa para a inferência.
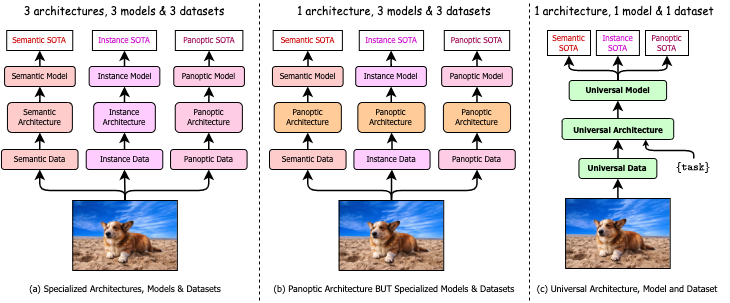
O resumo do artigo é o seguinte:
Universal Image Segmentation não é um conceito novo. Tentativas passadas de unificar a segmentação de imagem nas últimas décadas incluem scene parsing, segmentação panótica e, mais recentemente, novas arquiteturas panóticas. No entanto, essas arquiteturas panóticas não unificam de fato a segmentação de imagem, pois precisam ser treinadas individualmente para a segmentação semântica, de instâncias ou panótica para alcançar o melhor desempenho. Idealmente, um framework verdadeiramente universal deveria ser treinado apenas uma vez e alcançar desempenho SOTA em todas as três tarefas de segmentação de imagem. Para isso, propomos o OneFormer, um framework universal de segmentação de imagem que unifica a segmentação com um design multi-tarefa de treinamento único. Primeiro, propomos uma estratégia de treinamento conjunto condicionada por tarefa que permite o treinamento com ground truths de cada domínio (segmentação semântica, de instâncias e panótica) dentro de um único processo de treinamento multi-tarefa. Em segundo lugar, introduzimos um task token para condicionar nosso modelo à tarefa em questão, tornando nosso modelo dinâmico em relação à tarefa para suportar treinamento e inferência multi-tarefa. Em terceiro lugar, propomos o uso de uma perda contrastiva query-text durante o treinamento para estabelecer melhores distinções entre tarefas e entre classes. Notavelmente, nosso único modelo OneFormer supera os modelos especializados Mask2Former em todas as três tarefas de segmentação em ADE20k, CityScapes e COCO, apesar de estes últimos serem treinados individualmente em cada uma das três tarefas com três vezes mais recursos. Com novos backbones ConvNeXt e DiNAT, observamos ainda mais melhoria no desempenho. Acreditamos que o OneFormer é um passo significativo para tornar a segmentação de imagem mais universal e acessível.
A figura abaixo ilustra a arquitetura do OneFormer. Retirada do artigo original.
Este modelo foi contribuído por Jitesh Jain. O código original pode ser encontrado aqui.
Dicas de uso
- O OneFormer requer duas entradas durante a inferência: image e task token.
- Durante o treinamento, o OneFormer utiliza apenas anotações panóticas.
- Se você deseja treinar o modelo em um ambiente distribuído em vários nós, é necessário atualizar a função
get_num_masksdentro da classeOneFormerLossemmodeling_oneformer.py. Ao treinar em vários nós, esse valor deve ser definido como o número médio de máscaras de destino em todos os nós, conforme pode ser visto na implementação original aqui. - É possível usar OneFormerProcessor para preparar as imagens de entrada e as entradas de tarefa para o modelo, bem como alvos opcionais para o modelo. OneFormerProcessor encapsula OneFormerImageProcessor e CLIPTokenizer em uma única instância para preparar as imagens e codificar as entradas de tarefa.
- Para obter a segmentação final, dependendo da tarefa, você pode chamar
post_process_semantic_segmentation()ou post_process_instance_segmentation() ou post_process_panoptic_segmentation(). As três tarefas podem ser resolvidas usando a saída de OneFormerForUniversalSegmentation; a segmentação panóptica aceita um argumento opcionallabel_ids_to_fusepara fundir as instâncias do(s) objeto(s) alvo (por exemplo, céu).
Recursos
Uma lista de recursos oficiais da Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o OneFormer.
- Notebooks de demonstração sobre inferência + ajuste fino em dados personalizados podem ser encontrados aqui.
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão. O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
Saídas específicas do OneFormer
classe transformers.models.oneformer.modeling_oneformer.OneFormerModelOutput
< source >( encoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.Tensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_auxiliary_predictions: tuple[dict[str, torch.Tensor]] | None = Nonetext_queries: typing.Optional[torch.Tensor] = Nonetask_token: typing.Optional[torch.Tensor] = Noneattentions: tuple[torch.Tensor] | None = None )
Parâmetros
- encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de saída da última camada no decodificador do transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas do decodificador do transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Previsões de máscara da última camada no decodificador do transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Previsões de classe da última camada no decodificador do transformer. - transformer_decoder_auxiliary_predictions (
Tuplede Dict destr, torch.Tensor, opcional) — Tupla de previsões de classe e máscara de cada camada do decodificador do transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas da lista de texto de entrada, usadas para calcular a perda contrastiva durante o treinamento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarefa 1D para condicionar as consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(uma para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self e Cross Attentions do decodificador do transformer.
Classe para as saídas de OneFormerModel. Esta classe retorna todos os estados ocultos necessários para calcular os logits.
classe transformers.models.oneformer.modeling_oneformer.OneFormerForUniversalSegmentationOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneclass_queries_logits: typing.Optional[torch.Tensor] = Nonemasks_queries_logits: typing.Optional[torch.Tensor] = Noneauxiliary_predictions: list = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: list[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.Tensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_auxiliary_predictions: list[dict[str, torch.Tensor]] | None = Nonetext_queries: typing.Optional[torch.Tensor] = Nonetask_token: typing.Optional[torch.Tensor] = Noneattentions: tuple[tuple[torch.Tensor]] | None = None )
Parâmetros
- loss (
torch.Tensor, opcional) — A perda calculada, retornada quando os rótulos estão presentes. - class_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, num_labels + 1)que representa as classes propostas para cada query. Observe que o+ 1é necessário porque incorporamos a classe nula. - masks_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, height, width)representando as máscaras propostas para cada query. - auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista das previsões de classe e máscara de cada camada do decodificador do transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de saída da última camada no decodificador do transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas do decodificador do transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Previsões de máscara da última camada no decodificador do transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Previsões de classe da última camada no decodificador do transformer. - transformer_decoder_auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista de previsões de classe e máscara de cada camada do decodificador do transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas da lista de texto de entrada, usadas para calcular a perda contrastiva durante o treinamento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarefa 1D para condicionar as consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(uma para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self e Cross Attentions do decodificador do transformer.
Classe para as saídas de OneFormerForUniversalSegmentationOutput.
Esta saída pode ser passada diretamente para post_process_semantic_segmentation() ou post_process_instance_segmentation() ou post_process_panoptic_segmentation(), dependendo da tarefa. Consulte [`~OneFormerImageProcessor] para obter detalhes sobre o uso.
OneFormerConfig
classe transformers.OneFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneignore_value: int = 255num_queries: int = 150no_object_weight: float = 0.1class_weight: float = 2.0mask_weight: float = 5.0dice_weight: float = 5.0contrastive_weight: float = 0.5contrastive_temperature: float = 0.07train_num_points: int = 12544oversample_ratio: float = 3.0importance_sample_ratio: float = 0.75init_std: float = 0.02init_xavier_std: float = 1.0layer_norm_eps: float = 1e-05is_training: bool = Falseuse_auxiliary_loss: bool = Trueoutput_auxiliary_logits: bool = Truestrides: list[int] | tuple[int, ...] = (4, 8, 16, 32)task_seq_len: int = 77text_encoder_width: int = 256text_encoder_context_length: int = 77text_encoder_num_layers: int = 6text_encoder_vocab_size: int = 49408text_encoder_proj_layers: int = 2text_encoder_n_ctx: int = 16conv_dim: int = 256mask_dim: int = 256hidden_dim: int = 256encoder_feedforward_dim: int = 1024norm: str = 'GN'encoder_layers: int = 6decoder_layers: int = 10use_task_norm: bool = Truenum_attention_heads: int = 8dropout: float | int = 0.1dim_feedforward: int = 2048pre_norm: bool = Falseenforce_input_proj: bool = Falsequery_dec_layers: int = 2common_stride: int = 4 )
Parâmetros
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — A configuração do modelo backbone. - ignore_value (
int, opcional, padrão 255) — Valores a serem ignorados no rótulo de GT ao calcular a perda. - num_queries (
int, opcional, padrão 150) — Número de consultas de objeto. - no_object_weight (
float, opcional, padrão0.1) — Peso de classificação relativo da classe sem objeto na perda de detecção de objetos. - class_weight (
float, opcional, padrão2.0) — Peso relativo do erro de classificação no custo de correspondência húngara. - mask_weight (
float, opcional, padrão5.0) — Peso relativo da focal loss na perda de segmentação panótica. - dice_weight (
float, opcional, padrão5.0) — Peso relativo da perda dice na perda de segmentação panótica. - contrastive_weight (
float, opcional, padrão 0.5) — Peso para a perda contrastiva. - contrastive_temperature (
float, opcional, padrão 0.07) — Valor inicial para a escala dos logits contrastivos. - train_num_points (
int, opcional, padrão 12544) — Número de pontos a amostrar ao calcular as perdas nas previsões de máscara. - oversample_ratio (
float, opcional, padrão 3.0) — Proporção para determinar quantos pontos devem ser amostrados de forma excessiva. - importance_sample_ratio (
float, opcional, padrão 0.75) — Proporção de pontos amostrados por amostragem de importância. - init_std (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - init_xavier_std (
float, opcional, padrão1.0) — Fator de escala usado na inicialização Xavier dos pesos de atenção cruzada. - layer_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização de camada. - is_training (
bool, opcional, padrãoFalse) — Se deve executar no modo de treinamento ou de inferência. - use_auxiliary_loss (
bool, opcional, padrãoTrue) — Se deve calcular a perda usando as previsões intermediárias do decodificador do transformer. - output_auxiliary_logits (
bool, opcional, padrãoTrue) — Se deve retornar as previsões intermediárias do decodificador do transformer. - strides (
list, opcional, padrão[4, 8, 16, 32]) — Lista contendo os strides para os feature maps no encoder. - task_seq_len (
int, opcional, padrão 77) — Comprimento da sequência para a tokenização da lista de texto de entrada. - text_encoder_width (
int, opcional, padrão 256) — Tamanho oculto do codificador de texto. - text_encoder_context_length (
int, opcional, padrão 77) — Comprimento da sequência de entrada para o codificador de texto. - text_encoder_num_layers (
int, opcional, padrão 6) — Número de camadas do transformer no codificador de texto. - text_encoder_vocab_size (
int, opcional, padrão 49408) — Tamanho do vocabulário para o tokenizador. - text_encoder_proj_layers (
int, opcional, padrão 2) — Número de camadas no MLP para projetar as consultas de texto. - text_encoder_n_ctx (
int, opcional, padrão 16) — Número de consultas de contexto de texto aprendíveis. - conv_dim (
int, opcional, padrão 256) — Dimensão do mapa de características para mapear as saídas do backbone. - mask_dim (
int, opcional, padrão 256) — Dimensão para os mapas de características no decodificador de pixels. - hidden_dim (
int, opcional, padrão 256) — Dimensão dos estados ocultos no decodificador do transformer. - encoder_feedforward_dim (
int, opcional, padrão 1024) — Dimensão da camada FFN no decodificador de pixels. - norm (
str, opcional, padrão"GN") — Tipo de normalização. - encoder_layers (
int, opcional, padrão6) — Número de camadas ocultas no codificador do Transformer. Usará o mesmo valor denum_layersse não for definido. - decoder_layers (
int, opcional, padrão10) — Número de camadas ocultas no decodificador do Transformer. Se não for definido, usará o mesmo valor denum_layers. - use_task_norm (
bool, opcional, padrãoTrue) — Se deve normalizar o token de tarefa. - num_attention_heads (
int, opcional, padrão8) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - dropout (
Union[float, int], opcional, padrão0.1) — A proporção para todas as camadas de dropout. - dim_feedforward (
int, opcional, padrão 2048) — Dimensão da camada FFN no decodificador do transformer. - pre_norm (
bool, opcional, padrãoFalse) — Indica se os estados ocultos devem ser normalizados antes das camadas de atenção no decodificador do transformer. - enforce_input_proj (
bool, opcional, padrãoFalse) — Se deve projetar os estados ocultos no decodificador do transformer. - query_dec_layers (
int, opcional, padrão 2) — Número de camadas no transformador de consulta. - common_stride (
int, opcional, padrão 4) — Passo comum usado para os recursos no decodificador de pixels.
Esta é a classe de configuração para armazenar a configuração de um OneFormerModel. Ela é usada para instanciar um modelo Oneformer de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do shi-labs/oneformer_ade20k_swin_tiny
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplos:
>>> from transformers import OneFormerConfig, OneFormerModel

>>> # Initializing a OneFormer shi-labs/oneformer_ade20k_swin_tiny configuration
>>> configuration = OneFormerConfig()
>>> # Initializing a model (with random weights) from the shi-labs/oneformer_ade20k_swin_tiny style configuration
>>> model = OneFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
OneFormerImageProcessor
classe transformers.OneFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - repo_path (
str, kwargs, opcional, padrãoshi-labs/oneformer_demo) — Caminho para um diretório local ou repositório do HuggingFace Hub contendo metadados do modelo. - class_info_file (
str, kwargs, opcional) — Caminho para o arquivo JSON no repositório que contém os metadados da classe. - num_text (
int, kwargs, opcional) — Número de consultas de texto para o codificador de texto, usadas como prompts de orientação da tarefa. - num_labels (
int, kwargs, opcional) — Número de classes semânticas para segmentação, que determina o tamanho da camada de saída. - ignore_index (
int, kwargs, opcional) — Rótulo a ser ignorado em mapas de segmentação, frequentemente usado para preenchimento (padding). - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Se deve decrementar todos os valores de rótulo em 1, mapeando a classe de fundo paraignore_index.
Constrói um processador de imagem OneFormerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - task_inputs (
list[str], opcional) — Lista de tarefas ("panoptic","instance","semantic") para cada imagem no lote. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Um mapeamento de IDs de instância para IDs semânticos. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - repo_path (
str, kwargs, opcional, padrãoshi-labs/oneformer_demo) — Caminho para um diretório local ou repositório do HuggingFace Hub contendo metadados do modelo. - class_info_file (
str, kwargs, opcional) — Caminho para o arquivo JSON no repositório que contém os metadados da classe. - num_text (
int, kwargs, opcional) — Número de consultas de texto para o codificador de texto, usadas como prompts de orientação da tarefa. - num_labels (
int, kwargs, opcional) — Número de classes semânticas para segmentação, que determina o tamanho da camada de saída. - ignore_index (
int, kwargs, opcional) — Rótulo a ser ignorado em mapas de segmentação, frequentemente usado para preenchimento (padding). - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Se deve decrementar todos os valores de rótulo em 1, mapeando a classe de fundo paraignore_index.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (OneFormerForUniversalSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de comprimento (batch_size), em que cada item da lista (Tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de OneFormerForUniversalSegmentation em mapas de segmentação semântica. Suporta apenas PyTorch.
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
Parâmetros
- outputs (
OneFormerForUniversalSegmentationOutput) — As saídas deOneFormerForUniversalSegmentationOutput. - task_type (
str, opcional, padrão “instance”) — O pós-processamento depende do token de tarefa de entrada. Se otask_typefor “panoptic”, precisamos ignorar as previsões de stuff. - is_demo (
bool, opcional, padrãoTrue) — Indica se o modelo está em modo de demonstração. Se for verdadeiro, usa o threshold para prever as máscaras finais. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - target_sizes (
List[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (Tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas. - return_coco_annotation (
bool, opcional, padrãoFalse) — Se as previsões devem ser retornadas no formato COCO.
Retorna
List[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de OneFormerForUniversalSegmentationOutput em previsões de segmentação de instâncias de imagem. Suporta apenas PyTorch.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parâmetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — As saídas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - label_ids_to_fuse (
Set[int], opcional) — Os rótulos neste estado terão todas as suas instâncias fundidas em uma única. Por exemplo, podemos afirmar que pode haver apenas um céu em uma imagem, mas várias pessoas, de modo que o ID do rótulo para céu estaria nesse conjunto, mas não o de pessoa. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação panótica de imagem. Suporta apenas PyTorch.
OneFormerImageProcessorPil
classe transformers.OneFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> )
Parâmetros
- do_convert_rgb (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional, padrãoTrue) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, padrão{'shortest_edge' -- 800, 'longest_edge': 1333}): Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional, padrãoFalse) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, padrão2) — Filtro de reamostragem a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional, padrãoTrue) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional, padrão0.00392156862745098) — Fator de reescala para reescalar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional, padrãoTrue) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.485, 0.456, 0.406]) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, padrão[0.229, 0.224, 0.225]) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - repo_path (
str, kwargs, opcional, padrãoshi-labs/oneformer_demo) — Caminho para um diretório local ou repositório do HuggingFace Hub contendo metadados do modelo. - class_info_file (
str, kwargs, opcional) — Caminho para o arquivo JSON no repositório que contém os metadados da classe. - num_text (
int, kwargs, opcional) — Número de consultas de texto para o codificador de texto, usadas como prompts de orientação da tarefa. - num_labels (
int, kwargs, opcional) — Número de classes semânticas para segmentação, que determina o tamanho da camada de saída. - ignore_index (
int, kwargs, opcional) — Rótulo a ser ignorado em mapas de segmentação, frequentemente usado para preenchimento (padding). - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Se deve decrementar todos os valores de rótulo em 1, mapeando a classe de fundo paraignore_index.
Constrói um processador de imagem OneFormerImageProcessor.
pré-processamento
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parâmetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagem a ser pré-processada. Espera uma única imagem ou um lote de imagens com valores de pixel variando de 0 a 255. Se passar imagens com valores de pixel entre 0 e 1, definado_rescale=False. - task_inputs (
list[str], opcional) — Lista de tarefas ("panoptic","instance","semantic") para cada imagem no lote. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Um mapeamento de IDs de instância para IDs semânticos. - do_convert_rgb (
bool, kwargs, opcional) — Se a imagem deve ser convertida para RGB. - do_resize (
bool, kwargs, opcional) — Se deve redimensionar a imagem. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Descreve as dimensões máximas de entrada para o modelo. - default_to_square (
bool, kwargs, opcional) — Se deve usar uma imagem quadrada por padrão ao redimensionar, caso o tamanho seja um inteiro. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamanho da imagem de saída após a aplicação decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de redimensionamento a ser usado ao redimensionar a imagem. Pode ser um dos valores da enumeraçãoPILImageResampling. Tem efeito apenas sedo_resizeestiver definido comoTrue. - do_rescale (
bool, kwargs, opcional) — Se deve reescalar a imagem. - rescale_factor (
float, kwargs, opcional) — Fator de redimensionamento para redimensionar a imagem, casodo_rescaleesteja definido comoTrue. - do_normalize (
bool, kwargs, opcional) — Se a imagem deve ser normalizada. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Média da imagem a ser usada para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desvio padrão da imagem a ser usado para normalização. Tem efeito apenas sedo_normalizeestiver definido comoTrue. - do_pad (
bool, kwargs, opcional) — Indica se a imagem deve ser preenchida (padding). O preenchimento é feito até o maior tamanho do lote ou até um tamanho quadrado fixo por imagem. A estratégia exata de preenchimento depende do modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — O tamanho em{"height": int, "width" int}para o preenchimento das imagens. Deve ser maior que qualquer tamanho de imagem fornecido para o pré-processamento. Sepad_sizenão for fornecido, as imagens serão preenchidas até a maior altura e largura do lote. Aplicado apenas quandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Se deve recortar a imagem centralmente. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — ApenasChannelDimension.FIRSTé suportado. Adicionado para compatibilidade com processadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — O formato da dimensão de canal para a imagem de entrada. Se não definido, o formato da dimensão de canal é inferido a partir da imagem de entrada. Pode ser um dos seguintes:"channels_first"ouChannelDimension.FIRST: imagem no formato (num_channels, height, width)."channels_last"ouChannelDimension.LAST: imagem no formato (altura, largura, num_canais)."none"ouChannelDimension.NONE: imagem no formato (altura, largura).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — O dispositivo em que os vídeos serão processados. Se não for definido, o dispositivo é inferido a partir dos vídeos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retorna tensores empilhados se definido como'pt'; caso contrário, retorna uma lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Se deve desabilitar o agrupamento de imagens por tamanho para processá-las individualmente e não em lotes. Se for None, será definido como True se as imagens estiverem na CPU, e False caso contrário. Essa escolha é baseada em observações empíricas, conforme detalhado aqui: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — O número de tokens de imagem a serem usados para cada imagem na entrada. Adicionado para compatibilidade reversa, mas isso deve ser definido como um atributo do processador em modelos futuros. - repo_path (
str, kwargs, opcional, padrãoshi-labs/oneformer_demo) — Caminho para um diretório local ou repositório do HuggingFace Hub contendo metadados do modelo. - class_info_file (
str, kwargs, opcional) — Caminho para o arquivo JSON no repositório que contém os metadados da classe. - num_text (
int, kwargs, opcional) — Número de consultas de texto para o codificador de texto, usadas como prompts de orientação da tarefa. - num_labels (
int, kwargs, opcional) — Número de classes semânticas para segmentação, que determina o tamanho da camada de saída. - ignore_index (
int, kwargs, opcional) — Rótulo a ser ignorado em mapas de segmentação, frequentemente usado para preenchimento (padding). - do_reduce_labels (
bool, kwargs, opcional, padrãoFalse) — Se deve decrementar todos os valores de rótulo em 1, mapeando a classe de fundo paraignore_index.
Retorna
~image_processing_base.BatchFeature
- data (
dict) — Dicionário de listas/arrays/tensors retornados pelo método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Você pode fornecer um tensor_type aqui para converter as listas de inteiros em Tensors do PyTorch/Numpy na inicialização.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parâmetros
- outputs (OneFormerForUniversalSegmentation) — Saídas brutas do modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de comprimento (batch_size), em que cada item da lista (Tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão. Se deixado como None, as previsões não serão redimensionadas. - return_segmentation_scores (
bool, opcional, padrãoFalse) — Indica se as pontuações de segmentação devem ser retornadas junto com o mapa de segmentação. QuandoTrue, cada elemento da lista retornada é umSemanticSegmentationPostProcessorOutputcom os campossegmentation(IDs de classe, forma(height, width)) esegmentation_scores(forma(num_classes, height, width)).
Retorna
list[torch.Tensor] ou list[SemanticSegmentationPostProcessorOutput]
Quando
return_segmentation_scores=False (padrão), uma lista de comprimento batch_size em que cada item é um
mapa de segmentação de forma (height, width) com IDs de classe. Quando return_segmentation_scores=True,
uma lista de SemanticSegmentationPostProcessorOutput com os campos segmentation (IDs de classe, forma
(height, width)) e segmentation_scores (forma (num_classes, height, width)). Em ambos os casos,
(height, width) corresponde ao tamanho alvo (se target_sizes for especificado).
Converte a saída de OneFormerForUniversalSegmentation em mapas de segmentação semântica. Suporta apenas PyTorch.
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
Parâmetros
- outputs (
OneFormerForUniversalSegmentationOutput) — As saídas deOneFormerForUniversalSegmentationOutput. - task_type (
str, opcional, padrão “instance”) — O pós-processamento depende do token de tarefa de entrada. Se otask_typefor “panoptic”, precisamos ignorar as previsões de stuff. - is_demo (
bool, opcional, padrãoTrue) — Indica se o modelo está em modo de demonstração. Se for verdadeiro, usa o threshold para prever as máscaras finais. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - target_sizes (
List[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (Tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas. - return_coco_annotation (
bool, opcional, padrãoFalse) — Se as previsões devem ser retornadas no formato COCO.
Retorna
List[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de OneFormerForUniversalSegmentationOutput em previsões de segmentação de instâncias de imagem. Suporta apenas PyTorch.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parâmetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — As saídas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, padrão 0,5) — O limiar de pontuação de probabilidade para manter as máscaras de instâncias previstas. - mask_threshold (
float, opcional, padrão 0.5) — Limiar a ser utilizado ao converter as máscaras previstas em valores binários. - overlap_mask_area_threshold (
float, opcional, padrão 0.8) — O limiar de área da máscara de sobreposição para mesclar ou descartar pequenas partes desconectadas dentro de cada máscara binária de instância. - label_ids_to_fuse (
Set[int], opcional) — Os rótulos neste estado terão todas as suas instâncias fundidas em uma única. Por exemplo, podemos afirmar que pode haver apenas um céu em uma imagem, mas várias pessoas, de modo que o ID do rótulo para céu estaria nesse conjunto, mas não o de pessoa. - target_sizes (
list[Tuple], opcional) — Lista de comprimento (batch_size), em que cada item da lista (tuple[int, int]]) corresponde ao tamanho final solicitado (altura, largura) de cada previsão no lote. Se deixado como None, as previsões não serão redimensionadas.
Retorna
list[Dict]
Uma lista de dicionários, um por imagem, cada dicionário contendo duas chaves:
- segmentation — um tensor de forma
(height, width)em que cada pixel representa umsegment_id, definido comoNonese nenhuma máscara for encontrada acima dethreshold. Setarget_sizesfor especificado, a segmentation é redimensionada para a entrada correspondente detarget_sizes. - segments_info — Um dicionário que contém informações adicionais sobre cada segmento.
- id — um inteiro que representa o
segment_id. - label_id — Um inteiro que representa o id do rótulo/classe semântica correspondente a
segment_id. - was_fused — um booleano,
Trueselabel_idestava emlabel_ids_to_fuse,Falsecaso contrário. Múltiplas instâncias da mesma classe / rótulo foram fundidas e receberam um únicosegment_id. - score — Pontuação de previsão do segmento com
segment_id.
- id — um inteiro que representa o
Converte a saída de MaskFormerForInstanceSegmentationOutput em previsões de segmentação panótica de imagem. Suporta apenas PyTorch.
OneFormerProcessor
classe transformers.OneFormerProcessor
< source >( image_processor = Nonetokenizer = Nonemax_seq_length: int = 77task_seq_length: int = 77**kwargs )
Parâmetros
- image_processor (
OneFormerImageProcessor) — O processador de imagem é uma entrada obrigatória. - tokenizer (
CLIPTokenizer) — O tokenizer é uma entrada obrigatória. - max_seq_length (
int, opcional, padrão77) — Comprimento máximo da sequência para codificação de nomes de classes e entradas de texto. Este parâmetro controla o número máximo de tokens usados ao tokenizar nomes de classes e outras entradas de texto para o modelo. - task_seq_length (
int, opcional, padrão77) — Comprimento máximo da sequência especificamente para a codificação de descrições de tarefa. As descrições de tarefa (por exemplo, “the task is semantic”) são tokenizadas com esse limite de comprimento, que pode diferir do comprimento da sequência de texto geral.
Constrói um OneFormerProcessor que encapsula um processador de imagem e um tokenizador em um único processador.
OneFormerProcessor oferece todas as funcionalidades de OneFormerImageProcessor e CLIPTokenizer. Consulte ~OneFormerImageProcessor e ~CLIPTokenizer para mais informações.
__call__
< source >( images = Nonetask_inputs = Nonesegmentation_maps = None**kwargs ) → BatchFeature
Parâmetros
- images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - task_inputs (
stroulist[str], obrigatório) — O(s) tipo(s) de tarefa para segmentação. Deve ser um ou mais de"semantic","instance"ou"panoptic". Pode ser uma única string para uma única imagem, ou uma lista de strings (uma por imagem) para processamento em lote. O tipo de tarefa determina qual tipo de segmentação o modelo executará nas imagens de entrada. - segmentation_maps (
ImageInput, opcional) — Os mapas de segmentação semântica correspondentes, com as anotações por pixel.(
bool, opcional, padrãoTrue): Indica se as imagens devem ser preenchidas até o tamanho da maior imagem do lote e se uma máscara de pixels deve ser criada.Se mantido no padrão, retornará uma máscara de pixels que é:
- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- return_tensors (
strou TensorType, opcional) — Se definido, retornará tensors de um framework específico. Os valores aceitos são:'pt': Retorna objetostorch.Tensordo PyTorch.'np': Retorna objetosnp.ndarraydo NumPy.
Retorna
Um BatchFeature com os seguintes campos:
- task_inputs — Lista de ids de tokens a serem fornecidos a um modelo. Retornado quando
textnão éNone. - pixel_values — Valores de pixels a serem fornecidos a um modelo. Retornado quando
imagesnão éNone.
OneFormerModel
classe transformers.OneFormerModel
< source >( config: OneFormerConfig )
Parâmetros
- config (OneFormerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Oneformer puro, que produz estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerModelOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando OneFormerImageProcessor. Consulte OneFormerImageProcessor.call() para mais detalhes (OneFormerProcessor usa OneFormerImageProcessor para processar as imagens). - task_inputs (
torch.Tensorde forma(batch_size, sequence_length)) — Entradas da tarefa. As entradas da tarefa podem ser obtidas usando AutoImageProcessor. Consulte OneFormerProcessor.call() para mais detalhes. - text_inputs (
list[torch.Tensor], opcional) — Tensor de forma(num_queries, sequence_length)para ser fornecido a um modelo - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
OneFormerModelOutput ou tuple(torch.Tensor)
Um OneFormerModelOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (OneFormerConfig) e das entradas.
O método forward do OneFormerModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com formato(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de saída da última camada no decodificador do transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas do decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Previsões de máscara da última camada no decodificador do transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Previsões de classe da última camada no decodificador do transformer. - transformer_decoder_auxiliary_predictions (
Tuplede Dict destr, torch.Tensor, opcional) — Tupla de previsões de classe e máscara de cada camada do decodificador do transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas da lista de texto de entrada, usadas para calcular a perda contrastiva durante o treinamento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarefa 1D para condicionar as consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(uma para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self e Cross Attentions do decodificador do transformer.
Exemplo:
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import OneFormerProcessor, OneFormerModel

>>> # download test image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # load processor for preprocessing the inputs
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerModel.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> mask_predictions = outputs.transformer_decoder_mask_predictions
>>> class_predictions = outputs.transformer_decoder_class_predictions

>>> f"👉 Mask Predictions Shape: {list(mask_predictions.shape)}, Class Predictions Shape: {list(class_predictions.shape)}"
'👉 Mask Predictions Shape: [1, 150, 128, 171], Class Predictions Shape: [1, 150, 151]'
OneFormerForUniversalSegmentation
classe transformers.OneFormerForUniversalSegmentation
< source >( config: OneFormerConfig )
Parâmetros
- config (OneFormerConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo OneFormer para segmentação de imagem instância, semântica e panóptica.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonemask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerForUniversalSegmentationOutput or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando OneFormerImageProcessor. Consulte OneFormerImageProcessor.call() para mais detalhes (OneFormerProcessor usa OneFormerImageProcessor para processar as imagens). - task_inputs (
torch.Tensorde forma(batch_size, sequence_length)) — Entradas da tarefa. As entradas da tarefa podem ser obtidas usando AutoImageProcessor. Consulte OneFormerProcessor.call() para mais detalhes. - text_inputs (
list[torch.Tensor], opcional) — Tensor de forma(num_queries, sequence_length)para ser fornecido a um modelo - mask_labels (
list[torch.Tensor], opcional) — Lista de rótulos de máscara com forma(num_labels, height, width)para ser fornecida a um modelo - class_labels (
list[torch.LongTensor], opcional) — lista de rótulos de classe alvo com formato(num_labels, height, width)para ser fornecida a um modelo. Eles identificam os rótulos demask_labels, por exemplo, o rótulo demask_labels[i][j]seclass_labels[i][j]. - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar a execução de atenção em valores de pixels de preenchimento. Valores da máscara selecionados em[0, 1]:- 1 para pixels reais (ou seja, não mascarados),
- 0 para pixels que são padding (ou seja, mascarados).
- output_auxiliary_logits (
bool, opcional) — Indica se os logits auxiliares devem ser retornados. - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - output_attentions (
bool, opcional) — Indica se os tensores de atenção de todas as camadas de atenção devem ser retornados. Consulteattentionsnos tensores retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
OneFormerForUniversalSegmentationOutput ou tuple(torch.Tensor)
Um OneFormerForUniversalSegmentationOutput ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (OneFormerConfig) e das entradas.
O método forward de OneFormerForUniversalSegmentation sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- loss (
torch.Tensor, opcional) — A perda calculada, retornada quando os rótulos estão presentes. - class_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, num_labels + 1)representando as classes propostas para cada query. Observe que o+ 1é necessário porque incorporamos a classe nula. - masks_queries_logits (
torch.Tensor, opcional) — Um tensor de forma(batch_size, num_queries, height, width)representando as máscaras propostas para cada consulta. - auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista das previsões de classe e máscara de cada camada do decodificador do transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo encoder na saída de cada estágio. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com formato(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo pixel decoder na saída de cada estágio. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings + um para a saída de cada estágio) com forma(batch_size, sequence_length, hidden_size). Hidden-states (também chamados de feature maps) do transformer decoder na saída de cada estágio. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de saída da última camada no decodificador do transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas do decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Previsões de máscara da última camada no decodificador do transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Previsões de classe da última camada no decodificador do transformer. - transformer_decoder_auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista das previsões de classe e máscara de cada camada do decodificador do transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas da lista de texto de entrada, usadas para calcular a perda contrastiva durante o treinamento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarefa 1D para condicionar as consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(uma para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self e Cross Attentions do decodificador do transformer.
Exemplo:
Exemplo de segmentação universal:
>>> from transformers import OneFormerProcessor, OneFormerForUniversalSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch

>>> # load OneFormer fine-tuned on ADE20k for universal segmentation
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerForUniversalSegmentation.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # Semantic Segmentation
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for semantic postprocessing
>>> predicted_semantic_map = processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]
>>> f"👉 Semantic Predictions Shape: {list(predicted_semantic_map.shape)}"
'👉 Semantic Predictions Shape: [512, 683]'

>>> # Instance Segmentation
>>> inputs = processor(image, ["instance"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for instance postprocessing
>>> predicted_instance_map = processor.post_process_instance_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Instance Predictions Shape: {list(predicted_instance_map.shape)}"
'👉 Instance Predictions Shape: [512, 683]'

>>> # Panoptic Segmentation
>>> inputs = processor(image, ["panoptic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for panoptic postprocessing
>>> predicted_panoptic_map = processor.post_process_panoptic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Panoptic Predictions Shape: {list(predicted_panoptic_map.shape)}"
'👉 Panoptic Predictions Shape: [512, 683]'