
Transformers documentation
ResNet
Este modelo foi publicado em papers do HF em 2015-12-10 e contribuído para o Hugging Face Transformers em 2022-03-14.
ResNet
Visão geral
O modelo ResNet foi proposto em Deep Residual Learning for Image Recognition por Kaiming He, Xiangyu Zhang, Shaoqing Ren e Jian Sun. Nossa implementação segue as pequenas alterações feitas pela Nvidia: aplicamos stride=2 para o downsampling na convolução 3x3 do bottleneck, e não na primeira 1x1. Isso é geralmente conhecido como “ResNet v1.5”.
O ResNet introduziu conexões residuais, que permitem treinar redes com um número inédito de camadas (até 1000). O ResNet venceu a competição ILSVRC & COCO de 2015, um marco importante na visão computacional profunda.
O resumo do artigo é o seguinte:
Redes neurais mais profundas são mais difíceis de treinar. Apresentamos um framework de aprendizado residual para facilitar o treinamento de redes substancialmente mais profundas do que as usadas anteriormente. Reformulamos explicitamente as camadas para aprenderem funções residuais em relação às entradas da camada, em vez de aprender funções sem referência. Fornecemos evidência empírica abrangente mostrando que essas redes residuais são mais fáceis de otimizar e podem ganhar precisão a partir de um aumento considerável da profundidade. No conjunto de dados ImageNet, avaliamos redes residuais com profundidade de até 152 camadas — 8x mais profundas que as redes VGG, mas ainda com menor complexidade. Um ensemble dessas redes residuais atinge 3,57% de erro no conjunto de teste do ImageNet. Esse resultado conquistou o 1º lugar na tarefa de classificação do ILSVRC 2015. Também apresentamos análises no CIFAR-10 com 100 e 1000 camadas. A profundidade das representações é de importância central para muitas tarefas de reconhecimento visual. Devido exclusivamente às nossas representações extremamente profundas, obtemos uma melhoria relativa de 28% no conjunto de dados de detecção de objetos COCO. As redes residuais profundas são a base das nossas submissões nas competições ILSVRC & COCO 2015, onde também conquistamos o 1º lugar nas tarefas de detecção no ImageNet, localização no ImageNet, detecção no COCO e segmentação no COCO.
A figura abaixo ilustra a arquitetura do ResNet. Retirada do artigo original.
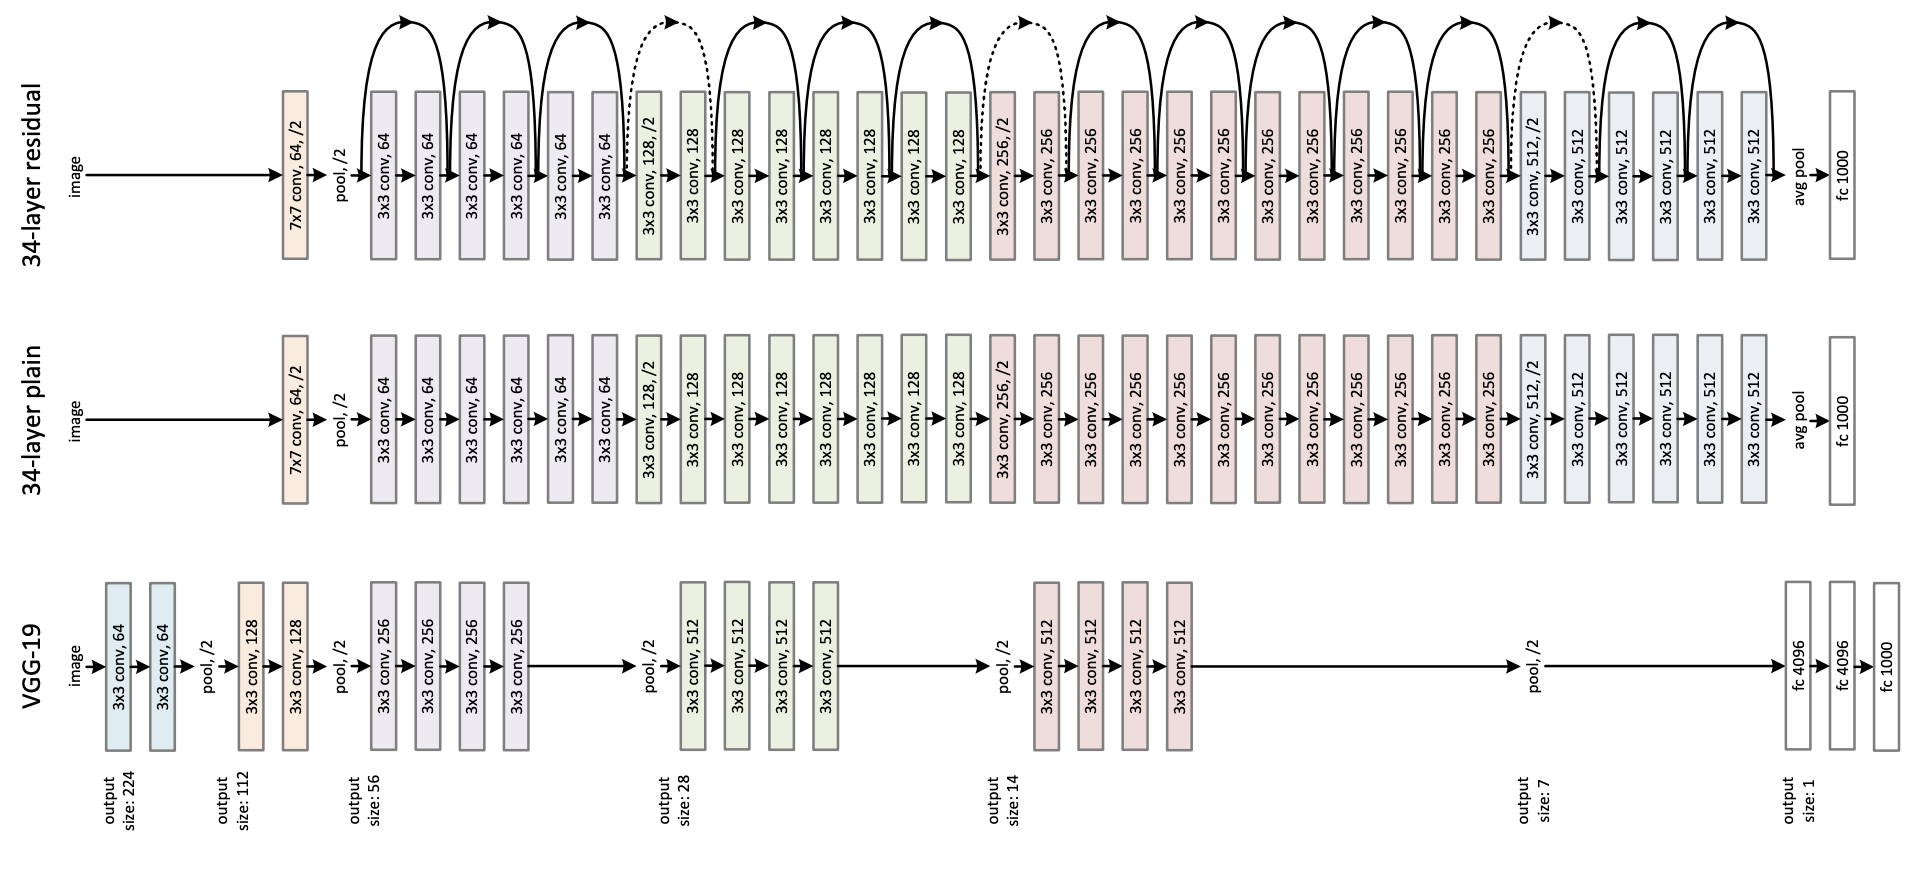
Este modelo foi contribuído por Francesco. O código original pode ser encontrado aqui.
Recursos
Uma lista de recursos oficiais do Hugging Face e da comunidade (indicados por 🌎) para ajudar você a começar com o ResNet.
- ResNetForImageClassification é suportado por este notebook.
- Veja também: Guia da tarefa de classificação de imagens
Se você tiver interesse em enviar um recurso para ser incluído aqui, sinta-se à vontade para abrir um Pull Request e faremos a revisão! O recurso deve, idealmente, demonstrar algo novo, em vez de duplicar um recurso existente.
ResNetConfig
classe transformers.ResNetConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3embedding_size: int = 64hidden_sizes: list[int] | tuple[int, ...] | None = (256, 512, 1024, 2048)depths: list[int] | tuple[int, ...] | None = (3, 4, 6, 3)layer_type: str = 'bottleneck'hidden_act: str = 'relu'downsample_in_first_stage: bool = Falsedownsample_in_bottleneck: bool = False )
Parâmetros
- num_channels (
int, opcional, padrão3) — O número de canais de entrada. - embedding_size (
int, opcional, padrão64) — Dimensão dos embeddings e dos estados ocultos. - hidden_sizes (
Union[list[int], tuple[int, ...]], opcional, padrão(256, 512, 1024, 2048)) — Dimensão (tamanho oculto) em cada etapa do modelo. - depths (
Union[list[int], tuple[int, ...]], opcional, padrão(3, 4, 6, 3)) — Profundidade de cada camada no Transformer. - layer_type (
str, opcional, padrão"bottleneck") — A camada a ser utilizada, que pode ser"basic"(usada para modelos menores, como resnet-18 ou resnet-34) ou"bottleneck"(usada para modelos maiores, como resnet-50 e superiores). - hidden_act (
str, opcional, padrãorelu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - downsample_in_first_stage (
bool, opcional, padrãoFalse) — SeTrue, a primeira etapa reduz a resolução das entradas usando umstridede 2. - downsample_in_bottleneck (
bool, opcional, padrãoFalse) — SeTrue, a primeira conv 1x1 em ResNetBottleNeckLayer reduz a resolução das entradas usando umstridede 2.
Esta é a classe de configuração para armazenar a configuração de um ResNetModel. Ela é usada para instanciar um modelo Resnet de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do microsoft/resnet-50
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import ResNetConfig, ResNetModel

>>> # Initializing a ResNet resnet-50 style configuration
>>> configuration = ResNetConfig()

>>> # Initializing a model (with random weights) from the resnet-50 style configuration
>>> model = ResNetModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.configVerifique se layer_types está definido corretamente.
ResNetModel
classe transformers.ResNetModel
< source >( config: ResNetConfig )
Parâmetros
- config (ResNetConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Resnet puro que produz estados ocultos brutos, sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: Tensoroutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithPoolingAndNoAttention or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ConvNextImageProcessor. Consulte ConvNextImageProcessor.call() para mais detalhes (processor_classusa ConvNextImageProcessor para processar as imagens). - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
BaseModelOutputWithPoolingAndNoAttention ou tuple(torch.Tensor)
Uma BaseModelOutputWithPoolingAndNoAttention ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (ResNetConfig) e das entradas.
O método forward do ResNetModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, num_channels, height, width)) — Sequência de estados ocultos na saída da última camada do modelo.pooler_output (
torch.Tensorde forma(batch_size, hidden_size)) — Estado oculto da última camada após uma operação de pooling nas dimensões espaciais.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, num_channels, height, width).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
ResNetForImageClassification
classe transformers.ResNetForImageClassification
< source >( config: ResNetConfig )
Parâmetros
- config (ResNetConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
Modelo ResNet com uma cabeça de classificação de imagem no topo (uma camada linear sobre os recursos agregados), por exemplo, para o ImageNet.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
Parâmetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size), opcional) — Os tensores correspondentes às imagens de entrada. Os valores de pixels podem ser obtidos usando ConvNextImageProcessor. Consulte ConvNextImageProcessor.call() para mais detalhes (processor_classusa ConvNextImageProcessor para processar imagens). - labels (
torch.LongTensorde forma(batch_size,), opcional) — Rótulos para o cálculo da perda de classificação/regressão de imagem. Os índices devem estar em[0, ..., config.num_labels - 1]. Seconfig.num_labels > 1, uma perda de classificação é calculada (Cross-Entropy). - output_hidden_states (
bool, opcional) — Indica se as hidden states de todas as camadas devem ser retornadas. Consultehidden_statesem tensors retornados para mais detalhes. - return_dict (
bool, opcional) — Indica se deve retornar um ModelOutput em vez de uma tupla simples.
Retorna
ImageClassifierOutputWithNoAttention ou tuple(torch.Tensor)
Um ImageClassifierOutputWithNoAttention ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (ResNetConfig) e das entradas.
O método forward de ResNetForImageClassification sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
- loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de classificação (ou regressão se config.num_labels==1). - logits (
torch.Tensorde forma(batch_size, config.num_labels)) — Pontuações de classificação (ou regressão, se config.num_labels==1) (antes do SoftMax). - hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada estágio) de forma(batch_size, num_channels, height, width). Hidden-states (também chamados de feature maps) do modelo na saída de cada estágio.
Exemplo:
>>> from transformers import AutoImageProcessor, ResNetForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/resnet-50")
>>> model = ResNetForImageClassification.from_pretrained("microsoft/resnet-50")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...