
Transformers documentation
CodeLlama
Bu model 2023-08-24 tarihinde HF papers'ta yayımlandı ve 2023-08-25 tarihinde Hugging Face Transformers'a katkıda bulunuldu.
CodeLlama
Code Llama, kodlama görevleri için Llama 2 tabanlı, özel bir büyük dil modeli ailesidir. Farklı çeşitlerde sunulur: genel kod, Python'a özel ve talimat takibi varyantı; tümü 7B, 13B, 34B ve 70B parametre seçenekleriyle mevcuttur. Code Llama modelleri kodunuzu üretebilir, açıklayabilir ve hatta eksik kısımlarını doldurabilir (buna “infilling” denir). 16K token uzunluğundaki diziler üzerinde eğitilmesine rağmen, 100k token'a kadar kararlı üretimle çok uzun bağlamları da işleyebilir.
Tüm orijinal Code Llama kontrol noktalarını Code Llama koleksiyonunda bulabilirsiniz.
Farklı kodlama görevlerine Code Llama uygulamanın daha fazla örneği için sağ kenar çubuğundaki Code Llama modellerine tıklayın.
Aşağıdaki örnek, Pipeline, AutoModel veya komut satırı üzerinden kod üretmenin nasıl yapılacağını göstermektedir.
from transformers import pipeline


pipe = pipeline(
    "text-generation",
    model="meta-llama/CodeLlama-7b-hf",
    device_map=0
)

# basic code generation
result = pipe("# Function to calculate the factorial of a number\ndef factorial(n):", max_new_tokens=256)
print(result[0]['generated_text'])

# infilling
infill_result = pipe("def remove_non_ascii(s: str) -> str:\n    \"\"\" <FILL_ME>\n    return result", max_new_tokens=200)
print(infill_result[0]['generated_text'])from transformers import AutoModelForCausalLM, AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("meta-llama/CodeLlama-7b-hf")
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/CodeLlama-7b-hf",
device_map="auto",
attn_implementation="sdpa"
)
# basic code generation
prompt = "# Function to calculate the factorial of a number\ndef factorial(n):"
input_ids = tokenizer(prompt, return_tensors="pt").to(model.device)
output = model.generate(
**input_ids,
max_new_tokens=256,
cache_implementation="static"
)
print(tokenizer.decode(output[0], skip_special_tokens=True))
# infilling
infill_prompt = "def remove_non_ascii(s: str) -> str:\n \"\"\" <FILL_ME>\n return result"
input_ids = tokenizer(infill_prompt, return_tensors="pt").to(model.device)
filled_output = model.generate(**input_ids, max_new_tokens=200)
filled_text = tokenizer.decode(filled_output[0], skip_special_tokens=True)
print(filled_text)Quantization, ağırlıkları daha düşük bir hassasiyetle temsil ederek büyük modellerin bellek yükünü azaltır. Daha fazla kullanılabilir quantization backend'i için Quantization genel bakışına başvurun.
Aşağıdaki örnek, ağırlıkları yalnızca 4-bite küçültmek için bitsandbytes kullanır.
# pip install bitsandbytes
import torch

from transformers import AutoModelForCausalLM, BitsAndBytesConfig, CodeLlamaTokenizer


bnb_config = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.bfloat16, bnb_4bit_quant_type="nf4", bnb_4bit_use_double_quant=True)
tokenizer = CodeLlamaTokenizer.from_pretrained("meta-llama/CodeLlama-34b-hf")
model = AutoModelForCausalLM.from_pretrained(
   "meta-llama/CodeLlama-34b-hf",
   device_map="auto",
   quantization_config=bnb_config
)

prompt = "# Write a Python function to check if a string is a palindrome\ndef is_palindrome(s):"
input_ids = tokenizer(prompt, return_tensors="pt").to(model.device)

output = model.generate(**input_ids, max_new_tokens=200, cache_implementation="static")
print(tokenizer.decode(output[0], skip_special_tokens=True))
Modelin hangi token'lara dikkat edebildiğini ve edemediğini daha iyi anlamak için AttentionMaskVisualizer'ı kullanın.
from transformers.utils.attention_visualizer import AttentionMaskVisualizer


visualizer = AttentionMaskVisualizer("meta-llama/CodeLlama-7b-hf")
visualizer("""def func(a, b):
  return a + b""")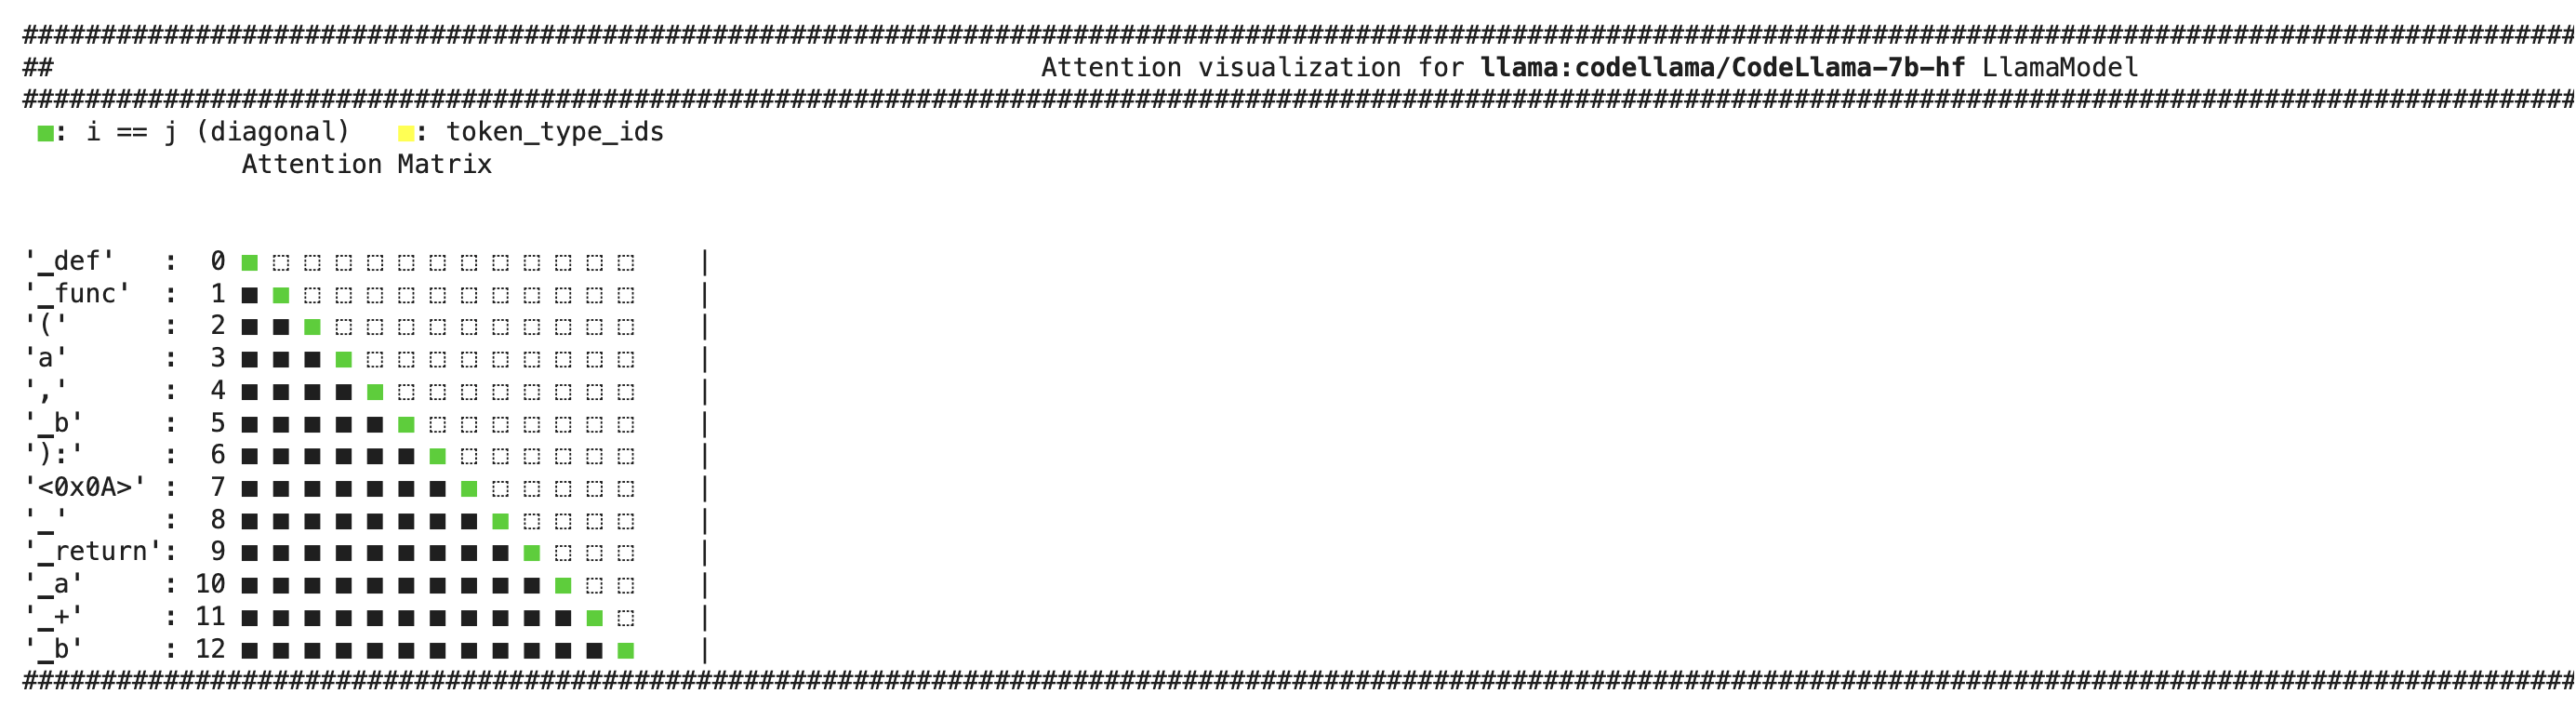
Notlar
Infilling yalnızca 7B ve 13B taban modellerinde kullanılabilir; Python, Instruct, 34B veya 70B modellerinde kullanılamaz.
Girdinizin doldurulmasını istediğiniz yerde
<FILL_ME>belirteci kullanın. Tokenizer, bu belirteci bölerek orijinal eğitim desenini takip eden biçimlendirilmiş bir girdi dizesi oluşturur. Bu, deseni kendiniz hazırlamaktan daha sağlamdır.from transformers import LlamaForCausalLM, CodeLlamaTokenizer tokenizer = CodeLlamaTokenizer.from_pretrained("meta-llama/CodeLlama-7b-hf") model = LlamaForCausalLM.from_pretrained("meta-llama/CodeLlama-7b-hf", device_map="auto") PROMPT = '''def remove_non_ascii(s: str) -> str: """ <FILL_ME> return result ''' input_ids = tokenizer(PROMPT, return_tensors="pt").to(model.device)["input_ids"] generated_ids = model.generate(input_ids, max_new_tokens=128) filling = tokenizer.batch_decode(generated_ids[:, input_ids.shape[1]:], skip_special_tokens = True)[0] print(PROMPT.replace("<FILL_ME>", filling))Daha fazla eğitim veya ince ayar için
bfloat16, çıkarım için isefloat16kullanın.BOSkarakteri, önek veya son ek kodlanırken dolgu için kullanılmaz; yalnızca her istemin başında kullanılır.Tokenizör, SentencePiece tabanlı bir bayt çifti kodlama modelidir. Çözümleme sırasında, ilk token bir kelimenin başlangıcıysa (örneğin, “Banana”), tokenizör dizinin başına boşluk önekini eklemez.
CodeLlamaTokenizer
sınıf transformers.CodeLlamaTokenizer
< source >( vocab: str | dict[str, int] | None = Nonemerges: str | list[str] | None = Noneclean_up_tokenization_spaces = Falseunk_token = '<unk>'bos_token = '<s>'eos_token = '</s>'prefix_token = '▁<PRE>'middle_token = '▁<MID>'suffix_token = '▁<SUF>'eot_token = '▁<EOT>'fill_token = '<FILL_ME>'additional_special_tokens = Noneuse_default_system_prompt: bool = Falseadd_prefix_space: bool | None = Trueadd_bos_token: bool = True**kwargs )
Parametreler
- clean_up_tokenization_spaces (
str, isteğe bağlı, varsayılanFalse) — Çözümleme sonrası boşlukların temizlenip temizlenmeyeceğini belirtir. Temizleme işlemi, ek boşluklar gibi olası artefaktların kaldırılmasını içerir. - unk_token (
str, isteğe bağlı, varsayılan"<unk>") — Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır. - bos_token (
str, isteğe bağlı, varsayılan"<s>") — Ön eğitim sırasında kullanılan dizinin başlangıç belirteci. Bir dizin sınıflandırıcı belirteci olarak kullanılabilir. - eos_token (
str, isteğe bağlı, varsayılan"</s>") — Dizi sonu belirteci. - prefix_token (
str, isteğe bağlı, varsayılan"▁<PRE>") — Doldurma (infilling) için kullanılan önek (prefix) belirteci. - middle_token (
str, isteğe bağlı, varsayılan"▁<MID>") — Doldurma (infilling) için kullanılan orta token. - suffix_token (
str, isteğe bağlı, varsayılan"▁<SUF>") — Doldurma (infilling) için kullanılan sonek (suffix) belirteci. - eot_token (
str, isteğe bağlı, varsayılan"▁<EOT>") — Doldurma (infilling) için kullanılan metin sonu belirteci. - fill_token (
str, isteğe bağlı, varsayılan"<FILL_ME>") — Önek ve son ek arasında girdiyi bölmek için kullanılan belirteç. - additional_special_tokens (
list[str], isteğe bağlı) — Tokenizör tarafından kullanılan ek özel tokenlar. - add_bos_token (
bool, isteğe bağlı, varsayılanTrue) — Dizilerin başına bir başlangıç token'ı eklenip eklenmeyeceğini belirtir. - add_eos_token (
bool, isteğe bağlı, varsayılanFalse) — Dizilerin sonuna bir dizi sonu (end of sequence) token'ı eklenip eklenmeyeceğini belirtir. - use_default_system_prompt (
bool, isteğe bağlı, varsayılanFalse) — Llama için varsayılan sistem istemcisinin kullanılıp kullanılmayacağı. - add_prefix_space (
bool, isteğe bağlı) — Girişe başlangıçta bir boşluk eklenip eklenmeyeceğini belirtir. Bu, baştaki kelimenin diğer herhangi bir kelime gibi ele alınmasını sağlar. - vocab (
str,dictveyalist, isteğe bağlı) — Özel sözlük. Sağlanmazsa, sözlük vocab_file'den yüklenir. - merges (
strveyalist, isteğe bağlı) — Özel birleştirmeler listesi. Sağlanmazsa, birleştirmeler merges_file'den yüklenir. - vocab_file (
str, isteğe bağlı) — Bir tokenizer örneği oluşturmak için gerekli sözlüğü içeren SentencePiece dosyası (genellikle .model uzantısına sahiptir).
Llama tokenizer'ı oluşturun. Bayt düzeyinde Byte-Pair-Encoding tabanlıdır.
Bu, özellikle ByteFallback kullanır ve normalizasyon uygulanmaz.
>>> from transformers import CodeLlamaTokenizer

>>> tokenizer = CodeLlamaTokenizer.from_pretrained("hf-internal-testing/llama-tokenizer")
>>> tokenizer.encode("Hello this is a test")
[1, 15043, 445, 338, 263, 1243]
bos_token veya eos_token değerlerini değiştirmek istiyorsanız, bunları modelin başlatılması sırasında belirtmekten veya işlemin doğru şekilde yapılmasını sağlamak için tokenizer.update_post_processor() çağrısını yapmaktan emin olun (aksi takdirde kodlanmış bir dizinin ilk ve son token değerleri doğru olmayacaktır). Daha fazla ayrıntı için [post-processors] (https://huggingface.co/docs/tokenizers/api/post-processors) belgesine göz atın.
Bu tokenizer, ana yöntemlerin çoğunu içeren PreTrainedTokenizerFast sınıfından devralır. Kullanıcıların bu yöntemlerle ilgili daha fazla bilgi için bu üst sınıfa başvurması gerekir. Varsayılan yapılandırma, prompt infilling'i destekleyen meta-llama/CodeLlama-7b-Instruct-hf ile eşleşir.
get_special_tokens_mask
< source >( token_ids_0: list[int]token_ids_1: list[int] | None = Nonealready_has_special_tokens: bool = False ) → A list of integers in the range [0, 1]
Parametreler
- token_ids_0 — (muhtemelen zaten biçimlendirilmiş) dizinin kimlik listesi.
- token_ids_1 —
already_has_special_tokens=Trueolduğunda kullanılmaz. Bu durumda None olmalıdır. - already_has_special_tokens — Sıralamanın özel jetonlarla zaten biçimlendirilmiş olup olmadığı.
Dönüş değeri
[0, 1] aralığında tamsayıların bir listesi
özel bir jeton için 1, bir dizi jetonu için 0.
Özel tokenlar eklenmemiş bir token listesinden dizi kimliklerini (sequence ids) alın.
Hızlı tokenizörlerde, veri toplayıcılar (data collators) bu işlemi already_has_special_tokens=True parametresiyle çağırarak, biçimlendirilmiş bir dizinin üzerine bir maske oluşturur. Bu durumda, maskeyi all_special_ids içinde üyelik kontrolü yaparak hesaplarız.
Altta yatan post işlemcisini güncel bos_token ve eos_token ile günceller.
CodeLlamaTokenizerFast
sınıf transformers.CodeLlamaTokenizer
< source >( vocab: str | dict[str, int] | None = Nonemerges: str | list[str] | None = Noneclean_up_tokenization_spaces = Falseunk_token = '<unk>'bos_token = '<s>'eos_token = '</s>'prefix_token = '▁<PRE>'middle_token = '▁<MID>'suffix_token = '▁<SUF>'eot_token = '▁<EOT>'fill_token = '<FILL_ME>'additional_special_tokens = Noneuse_default_system_prompt: bool = Falseadd_prefix_space: bool | None = Trueadd_bos_token: bool = True**kwargs )
Parametreler
- clean_up_tokenization_spaces (
str, isteğe bağlı, varsayılanFalse) — Çözümleme sonrası boşlukların temizlenip temizlenmeyeceğini belirtir. Temizleme işlemi, ek boşluklar gibi olası artefaktların kaldırılmasını içerir. - unk_token (
str, isteğe bağlı, varsayılan"<unk>") — Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır. - bos_token (
str, isteğe bağlı, varsayılan"<s>") — Ön eğitim sırasında kullanılan dizinin başlangıç belirteci. Bir dizin sınıflandırıcı belirteci olarak kullanılabilir. - eos_token (
str, isteğe bağlı, varsayılan"</s>") — Dizi sonu belirteci. - prefix_token (
str, isteğe bağlı, varsayılan"▁<PRE>") — Doldurma (infilling) için kullanılan önek (prefix) belirteci. - middle_token (
str, isteğe bağlı, varsayılan"▁<MID>") — Doldurma (infilling) için kullanılan orta token. - suffix_token (
str, isteğe bağlı, varsayılan"▁<SUF>") — Doldurma (infilling) için kullanılan sonek (suffix) belirteci. - eot_token (
str, isteğe bağlı, varsayılan"▁<EOT>") — Doldurma (infilling) için kullanılan metin sonu belirteci. - fill_token (
str, isteğe bağlı, varsayılan"<FILL_ME>") — Önek ve son ek arasında girdiyi bölmek için kullanılan belirteç. - additional_special_tokens (
list[str], isteğe bağlı) — Tokenizör tarafından kullanılan ek özel tokenlar. - add_bos_token (
bool, isteğe bağlı, varsayılanTrue) — Dizilerin başına bir başlangıç token'ı eklenip eklenmeyeceğini belirtir. - add_eos_token (
bool, isteğe bağlı, varsayılanFalse) — Dizilerin sonuna bir dizi sonu (end of sequence) token'ı eklenip eklenmeyeceğini belirtir. - use_default_system_prompt (
bool, isteğe bağlı, varsayılanFalse) — Llama için varsayılan sistem istemcisinin kullanılıp kullanılmayacağı. - add_prefix_space (
bool, isteğe bağlı) — Girişe başlangıçta bir boşluk eklenip eklenmeyeceğini belirtir. Bu, baştaki kelimenin diğer herhangi bir kelime gibi ele alınmasını sağlar. - vocab (
str,dictveyalist, isteğe bağlı) — Özel sözlük. Sağlanmazsa, sözlük vocab_file'den yüklenir. - merges (
strveyalist, isteğe bağlı) — Özel birleştirmeler listesi. Sağlanmazsa, birleştirmeler merges_file'den yüklenir. - vocab_file (
str, isteğe bağlı) — Bir tokenizer örneği oluşturmak için gerekli sözlüğü içeren SentencePiece dosyası (genellikle .model uzantısına sahiptir).
Llama tokenizer'ı oluşturun. Bayt düzeyinde Byte-Pair-Encoding tabanlıdır.
Bu, özellikle ByteFallback kullanır ve normalizasyon uygulanmaz.
>>> from transformers import CodeLlamaTokenizer

>>> tokenizer = CodeLlamaTokenizer.from_pretrained("hf-internal-testing/llama-tokenizer")
>>> tokenizer.encode("Hello this is a test")
[1, 15043, 445, 338, 263, 1243]
bos_token veya eos_token değerlerini değiştirmek istiyorsanız, bunları modelin başlatılması sırasında belirtmekten veya işlemin doğru şekilde yapılmasını sağlamak için tokenizer.update_post_processor() çağrısını yapmaktan emin olun (aksi takdirde kodlanmış bir dizinin ilk ve son token değerleri doğru olmayacaktır). Daha fazla ayrıntı için [post-processors] (https://huggingface.co/docs/tokenizers/api/post-processors) belgesine göz atın.
Bu tokenizer, ana yöntemlerin çoğunu içeren PreTrainedTokenizerFast sınıfından devralır. Kullanıcıların bu yöntemlerle ilgili daha fazla bilgi için bu üst sınıfa başvurması gerekir. Varsayılan yapılandırma, prompt infilling'i destekleyen meta-llama/CodeLlama-7b-Instruct-hf ile eşleşir.
infilling için istem formatına uyulduğundan emin olmak için normalizer'ı günceller. Infilling formatı
şu şekildedir: if suffix_first
” <PRE> <SUF>{suf} <MID> {pre}”
else:
” <PRE> {pre} <SUF>{suf} <MID>”
reset True olarak ayarlanırsa, normalizer ve post_processor, normalizer için bir önek boşluğu eklemek ve post_processor için giriş metnine bos_token eklemek olan “normal” davranışlarına sıfırlanır.