
Transformers documentation
SAM-HQ
Bu model, 2023-06-02 tarihinde HF papers'ta yayımlanmış ve 2025-04-28 tarihinde Hugging Face Transformers'a katkıda bulunmuştur.
SAM-HQ
Genel Bakış
SAM-HQ (High-Quality Segment Anything Model), Lei Ke, Mingqiao Ye, Martin Danelljan, Yifan Liu, Yu-Wing Tai, Chi-Keung Tang ve Fisher Yu tarafından Segment Anything in High Quality makalesinde önerilmiştir.
Model, SAM'in orijinal promptlanabilir tasarımını, verimliliğini ve sıfır atış genellenebilirliğini korurken, orijinal SAM modeline kıyasla önemli ölçüde daha yüksek kalitede segmentasyon maskeleri üreten bir iyileştirmedir.
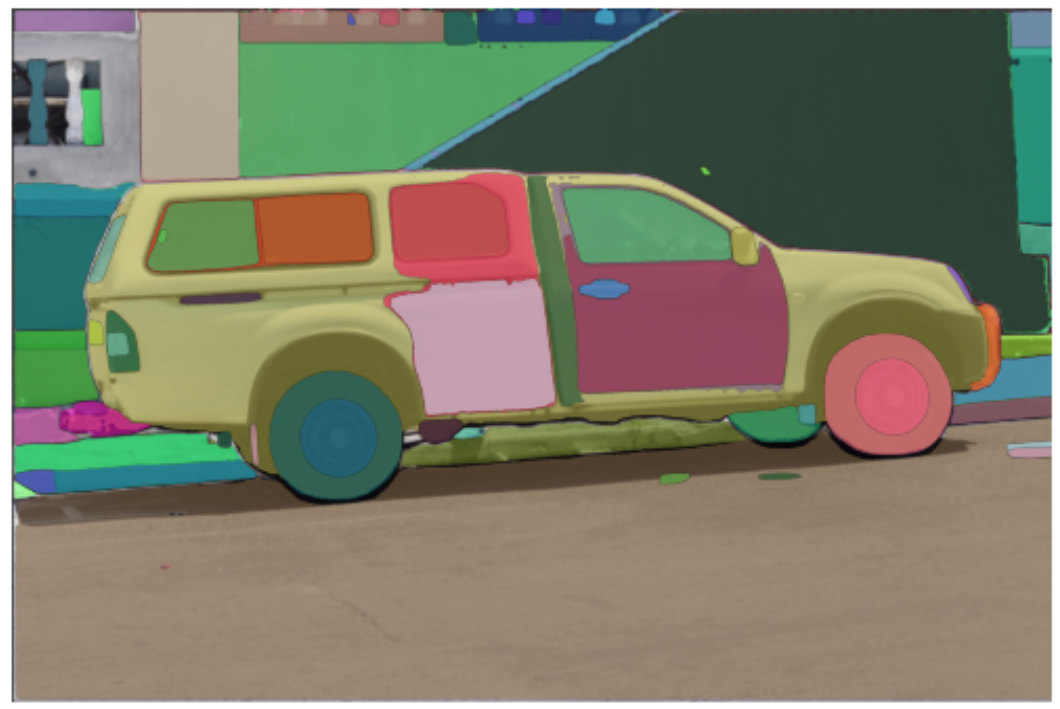
SAM-HQ, orijinal SAM modeline kıyasla birkaç önemli iyileştirme sunar:
- Yüksek Kaliteli Çıktı Belirteci: Daha yüksek kalitede maske tahmini için SAM'ın maske çözücüsüne enjekte edilen öğrenilebilir belirteç
- Küresel-yerel özellik füzyonu: Modelin farklı aşamalarından gelen özellikleri birleştirerek maske detaylarını iyileştirir
- Eğitim Verisi: SA-1B yerine 44K yüksek kaliteli maskeden oluşan özenle derlenmiş bir veri seti kullanır
- Verimlilik: Sadece %0,5 ek parametre eklerken maske kalitesini önemli ölçüde iyileştirir
- Sıfır atışlı Yetenek: SAM'ın güçlü sıfır atışlı performansını korurken doğruluğu artırır
Makalenin özeti aşağıdaki gibidir:
Yakın zamanda tanıtılan Segment Anything Model (SAM), segmentasyon modellerinin ölçeklenmesinde büyük bir sıçrama temsil etmekte ve güçlü sıfır atış (zero-shot) yetenekleri ile esnek istem (prompting) imkânı sunmaktadır. 1,1 milyar maske ile eğitilmesine rağmen SAM'in maske tahmin kalitesi birçok durumda yetersiz kalmakta, özellikle karmaşık yapıya sahip nesnelerle uğraşırken bu durum daha belirgin hale gelmektedir. HQ-SAM'ı öneriyoruz; bu model, SAM'in orijinal istemlenebilir tasarımını, verimliliğini ve sıfır atış genellenebilirliğini korurken herhangi bir nesneyi doğru bir şekilde segmente etme yeteneğini SAM'e kazandırmaktadır. Dikkatli tasarımımız, SAM'in önceden eğitilmiş model ağırlıklarını yeniden kullanarak ve koruyarak yalnızca minimal ek parametre ve hesaplama getirmektedir. Yüksek Kaliteli Çıktı Jetonu (High-Quality Output Token) adında, SAM'in maske çözücüsüne (mask decoder) enjekte edilen ve yüksek kaliteli maskenin tahmininden sorumlu olan öğrenilebilir bir jeton tasarladık. Yalnızca maske-çözücü özelliklerine uygulamak yerine, maske detaylarını iyileştirmek için önce bu özellikleri erken ve son ViT özellikleriyle birleştiriyoruz. Tanıttığımız öğrenilebilir parametreleri eğitmek için çeşitli kaynaklardan 44K ince taneli (fine-grained) maskeden oluşan bir veri seti oluşturduk. HQ-SAM yalnızca 44K maskeden oluşan bu tanıtılan veri setinde eğitilmekte ve bu işlem 8 GPU üzerinde yalnızca 4 saat sürmektedir.
İpuçları:
- SAM-HQ, özellikle karmaşık yapıya ve ince detaylara sahip nesnelerde, orijinal SAM modeline kıyasla daha yüksek kalitede maskeler üretir.
- Model, daha doğru sınırlara sahip ikili maskeler tahmin eder ve ince yapıları daha iyi işler
- SAM gibi, model girdi olarak 2B noktalar ve/veya girdi olarak sınırlayıcı kutular kullanıldığında daha iyi performans gösterir.
- Aynı görüntü için birden çok nokta girdisi sağlayabilir ve tek bir yüksek kaliteli maske tahmin edebilirsiniz
- Model, SAM'ın sıfır atışlı genelleme yeteneklerini korur
- SAM-HQ, SAM'a kıyasla yalnızca ~%0,5 ek parametre ekler
- Modelin ince ayarı henüz desteklenmiyor
Bu model sushmanth tarafından katkıda bulunmuştur. Orijinal kod burada bulunabilir.
Aşağıda, bir görüntü ve 2B bir nokta verildiğinde maske üretiminin nasıl çalıştırılacağına dair bir örnek bulunmaktadır:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
İşlemci (processor) aracılığıyla modele aktarılacak kendi maskelerinizi de giriş görselleriyle birlikte işleyebilirsiniz:
import requests
import torch
from PIL import Image

from transformers import SamHQModel, SamHQProcessor


model = SamHQModel.from_pretrained("syscv-community/sam-hq-vit-base", device_map="auto")
processor = SamHQProcessor.from_pretrained("syscv-community/sam-hq-vit-base")

img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]]  # 2D location of a window in the image

inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
    outputs = model(**inputs)

masks = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
Kaynaklar
SAM-HQ ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi:
- Modeli kullanmak için demo defter (yakında)
- Makale uygulaması ve kodu: SAM-HQ GitHub Deposu
SamHQConfig
sınıf transformers.SamHQConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneprompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonemask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneinitializer_range: float = 0.02tie_word_embeddings: bool = True )
Parametreler
- vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], isteğe bağlı) — Görüntü omurgasının yapılandırma nesnesi veya sözlüğü. - prompt_encoder_config (Union[
dict,SamHQPromptEncoderConfig], isteğe bağlı) — SamHQPromptEncoderConfig sınıfını başlatmak için kullanılan yapılandırma seçeneklerinin sözlüğü. - mask_decoder_config (Union[
dict,SamHQMaskDecoderConfig], isteğe bağlı) — SamHQMaskDecoderConfig sınıfını başlatmak için kullanılan yapılandırma seçeneklerinin sözlüğü. - initializer_range (
float, isteğe bağlı, varsayılan0.02) — Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması. - tie_word_embeddings (
bool, isteğe bağlı, varsayılanTrue) — Modelintied_weights_keyseşlemesine göre ağırlık gömme bağlamalarının yapılıp yapılmayacağı.
Bu, bir SamHQModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam Hq modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, syscv-community/sam-hq-vit-base modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
SamHQVisionConfig
sınıf transformers.SamHQVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 768output_channels: int = 256num_hidden_layers: int = 12num_attention_heads: int = 12num_channels: int = 3image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06attention_dropout: float | int = 0.0initializer_range: float = 1e-10qkv_bias: bool = Truemlp_ratio: float = 4.0use_abs_pos: bool = Trueuse_rel_pos: bool = Truewindow_size: int = 14global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11)num_pos_feats: int = 128mlp_dim: int | None = None )
Parametreler
- hidden_size (
int, isteğe bağlı, varsayılan768) — Gizli temsillerin boyutu. - output_channels (
int, isteğe bağlı, varsayılan 256) — Patch Encoder'da çıktı kanallarının boyutu. - num_hidden_layers (
int, isteğe bağlı, varsayılan12) — Transformer çözücüdeki gizli katman sayısı. - num_attention_heads (
int, isteğe bağlı, varsayılan12) — Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı. - num_channels (
int, isteğe bağlı, varsayılan3) — Giriş kanal sayısı. - image_size (
Union[int, list[int], tuple[int, int]], isteğe bağlı, varsayılan1024) — Her bir görüntünün boyutu (çözünürlüğü). - patch_size (
Union[int, list[int], tuple[int, int]], isteğe bağlı, varsayılan16) — Her yamanın boyutu (çözünürlüğü). - hidden_act (
str, isteğe bağlı, varsayılangelu) — Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin,"gelu","relu","silu"vb. - layer_norm_eps (
float, isteğe bağlı, varsayılan1e-06) — Katman normalizasyon katmanları tarafından kullanılan epsilon. - attention_dropout (
Union[float, int], isteğe bağlı, varsayılan0.0) — Dikkat olasılıkları için dropout oranı. - initializer_range (
float, isteğe bağlı, varsayılan1e-10) — Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması. - qkv_bias (
bool, isteğe bağlı, varsayılanTrue) — Sorgulara, anahtarlara ve değerlere bir sapma eklenip eklenmeyeceği. - mlp_ratio (
float, isteğe bağlı, varsayılan4.0) — MLP gizli boyutunun gömme boyutuna oranı. - use_abs_pos (
bool, isteğe bağlı, varsayılanTrue) — Mutlak konum gömme kullanılıp kullanılmayacağı. - use_rel_pos (
bool, isteğe bağlı, varsayılanTrue) — Göreceli konum gömme kullanılıp kullanılmayacağı. - window_size (
int, isteğe bağlı, varsayılan 14) — Göreceli konum için pencere boyutu. - global_attn_indexes (
list[int], isteğe bağlı, varsayılan[2, 5, 8, 11]) — Küresel dikkat katmanlarının indeksleri. - num_pos_feats (
int, isteğe bağlı, varsayılan 128) — Konum gömme (position embedding) boyutu. - mlp_dim (
int, isteğe bağlı) — Transformer kodlayıcısındaki MLP katmanının boyutluluğu.Noneise, varsayılan olarakmlp_ratio * hidden_sizedeğerini alır.
Bu, bir SamHQModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam Hq modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, syscv-community/sam-hq-vit-base modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
Örnek:
>>> from transformers import (
...     SamHQVisionConfig,
...     SamHQVisionModel,
... )

>>> # Initializing a SamHQVisionConfig with `"facebook/sam_hq-vit-huge"` style configuration
>>> configuration = SamHQVisionConfig()

>>> # Initializing a SamHQVisionModel (with random weights) from the `"facebook/sam_hq-vit-huge"` style configuration
>>> model = SamHQVisionModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
SamHQMaskDecoderConfig
sınıf transformers.SamHQMaskDecoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256hidden_act: str = 'relu'mlp_dim: int = 2048num_hidden_layers: int = 2num_attention_heads: int = 8attention_downsample_rate: int = 2num_multimask_outputs: int = 3iou_head_depth: int = 3iou_head_hidden_dim: int = 256layer_norm_eps: float = 1e-06vit_dim: int = 768 )
Parametreler
- hidden_size (
int, isteğe bağlı, varsayılan256) — Gizli temsillerin boyutu. - hidden_act (
str, isteğe bağlı, varsayılanrelu) — Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin,"gelu","relu","silu"vb. - mlp_dim (
int, isteğe bağlı, varsayılan 2048) — Transformer kodlayıcısındaki “ara” (yani, ileri beslemeli) katmanın boyutluluğu. - num_hidden_layers (
int, isteğe bağlı, varsayılan2) — Transformer decoder'ındaki gizli katman sayısı. - num_attention_heads (
int, isteğe bağlı, varsayılan8) — Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı. - attention_downsample_rate (
int, isteğe bağlı, varsayılan 2) — Dikkat katmanının indirgeme oranı. - num_multimask_outputs (
int, isteğe bağlı, varsayılan 3) —SamMaskDecodermodülünden gelen çıktıların sayısı. Segment Anything makalesinde bu değer 3 olarak ayarlanmıştır. - iou_head_depth (
int, isteğe bağlı, varsayılan 3) — IoU başlığı modülündeki katman sayısı. - iou_head_hidden_dim (
int, isteğe bağlı, varsayılan 256) — IoU başlığı modülündeki gizli durumların boyutluluğu. - layer_norm_eps (
float, isteğe bağlı, varsayılan1e-06) — Katman normalizasyon katmanları tarafından kullanılan epsilon. - vit_dim (
int, isteğe bağlı, varsayılan 768) —SamHQMaskDecodermodülünde kullanılan Vision Transformer'ın (ViT) boyutluluğu.
Bu, bir SamHQModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam Hq modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, syscv-community/sam-hq-vit-base modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
SamHQPromptEncoderConfig
sınıf transformers.SamHQPromptEncoderConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonehidden_size: int = 256image_size: int | list[int] | tuple[int, int] = 1024patch_size: int | list[int] | tuple[int, int] = 16mask_input_channels: int = 16num_point_embeddings: int = 4hidden_act: str = 'gelu'layer_norm_eps: float = 1e-06 )
Parametreler
- hidden_size (
int, isteğe bağlı, varsayılan256) — Gizli temsillerin boyutu. - image_size (
Union[int, list[int], tuple[int, int]], isteğe bağlı, varsayılan1024) — Her bir görüntünün boyutu (çözünürlüğü). - patch_size (
Union[int, list[int], tuple[int, int]], isteğe bağlı, varsayılan16) — Her yamanın boyutu (çözünürlüğü). - mask_input_channels (
int, isteğe bağlı, varsayılan 16) —MaskDecodermodülüne verilecek kanal sayısı. - num_point_embeddings (
int, isteğe bağlı, varsayılan 4) — Kullanılacak nokta gömme sayısı. - hidden_act (
str, isteğe bağlı, varsayılangelu) — Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin,"gelu","relu","silu"vb. - layer_norm_eps (
float, isteğe bağlı, varsayılan1e-06) — Katman normalizasyon katmanları tarafından kullanılan epsilon.
Bu, bir SamHQModel'in yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Sam Hq modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, syscv-community/sam-hq-vit-base modelinin yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
SamHQProcessor
sınıf transformers.SamHQProcessor
< source >( image_processor )
Bir görüntü işleyicisini tek bir işleyiciye sararak bir SamHQProcessor oluşturur.
SamHQProcessor, SamImageProcessor'ün tüm işlevlerini sunar. Daha fazla bilgi için ~SamImageProcessor sayfasına bakın.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None**kwargs: *<class 'transformers.models.sam_hq.processing_sam_hq.SamHQProcessorKwargs'> ) → ~feature_extraction_utils.BatchFeature
Parametreler
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], isteğe bağlı) — Ön işleme yapılacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsado_rescale=Falseolarak ayarlayın. - segmentation_maps (
ImageInput, kwargs, isteğe bağlı) — Girdi görüntüleriyle birlikte işlenecek gerçek segmentasyon haritaları. Bu haritalar eğitim veya değerlendirme amaçlı kullanılır ve işlenmiş görüntü boyutlarıyla eşleşecek şekilde yeniden boyutlandırılır ve normalize edilir. - input_points (
NestedList, kwargs, opsiyonel) — İstem tabanlı segmentasyon için giriş noktaları. Yapısı[image_level, object_level, point_level, [x, y]]olan iç içe geçmiş bir liste olmalıdır; her nokta, orijinal görüntü uzayında[x, y]koordinatları olarak belirtilir. Noktalar, modele iletilmeden önce hedef görüntü boyutuna göre normalize edilir. - input_labels (
NestedList, kwargs, isteğe bağlı) — Giriş noktaları için etiketler; her bir noktanın ön plan (1) mı yoksa arka plan (0) mı olduğunu belirtir. Yapısı[image_level, object_level, point_level]olan iç içe geçmiş bir liste olmalıdır.input_pointsile aynı yapıya sahip olmalıdır (koordinat boyutu hariç). - input_boxes (
NestedList, kwargs, opsiyonel) — İstem tabanlı segmentasyon için sınırlayıcı kutular. Yapısı[image_level, box_level, [x1, y1, x2, y2]]olan iç içe geçmiş bir liste olmalıdır; her kutu, orijinal görüntü uzayında[x1, y1, x2, y2]koordinatları olarak belirtilir. Kutular, modele iletilmeden önce hedef görüntü boyutuna göre normalize edilir. - point_pad_value (
int, kwargs, opsiyonel, varsayılanNone) — Farklı uzunluklardaki dizilerin toplu işlenmesi sırasında girdi noktalarını dolgu (padding) yapmak için kullanılan değer. Bu değer, dolgu konumlarını işaretler ve gerçek noktaları dolgudan ayırt etmek için koordinat normalizasyonu sırasında korunur.Noneise, işlemci yapılandırmasındaki varsayılan dolgu değeri kullanılır. - mask_size (
dict[str, *kwargs*, int], isteğe bağlı) —"height"ve"width"anahtarlarını içeren, hedef maske boyutunu belirten sözlük. Bu, modelin ürettiği çıktı segmentasyon maskelerinin çözünürlüğünü belirler. - mask_pad_size (
dict[str, *kwargs*, int], isteğe bağlı) —"height"ve"width"anahtarlarına sahip maskeler için dolgu boyutunu belirten sözlük. Bu, farklı boyutlardaki maskelerin toplu işlenmesinde tutarlı boyutlar sağlamak için kullanılır. - return_tensors (
strveya TensorType, isteğe bağlı) — Belirlenirse, belirli bir çerçeveye ait tensörler döndürülür. Kabul edilen değerler şunlardır:'pt': PyTorchtorch.Tensornesnelerini döndürür.'np': NumPynp.ndarraynesnelerini döndürür.
- **kwargs (ProcessingKwargs, isteğe bağlı) — Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
Dönüş değeri
~feature_extraction_utils.BatchFeature
- data (
dict, isteğe bağlı) — call/pad yöntemleri tarafından döndürülen listelerin/dizilerin/tensörlerin sözlüğü ('input_values', 'attention_mask' vb.). - tensor_type (
Union[None, str, TensorType], isteğe bağlı) — Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz. - skip_tensor_conversion (
list[str]veyaset[str], isteğe bağlı) —tensor_typebelirtilse bile tensöre dönüştürülmemesi gereken anahtarların listesi veya kümesi.
SamHQVisionModel
sınıf transformers.SamHQVisionModel
< source >( config: SamHQVisionConfig )
Parametreler
- config (SamHQVisionConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Üstünde herhangi bir başlık veya projeksiyon olmadan SamHQ'nin görme modeli.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SamHQVisionEncoderOutput or tuple(torch.Tensor)
Parametreler
- pixel_values (
torch.Tensor, şekli(batch_size, num_channels, image_size, image_size), isteğe bağlı) — Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri SamImageProcessor kullanılarak elde edilebilir. Ayrıntılar için SamImageProcessor.call() bölümüne bakın (SamHQProcessor, görüntüleri işlemek için SamImageProcessor kullanır).
Dönüş değeri
SamHQVisionEncoderOutput veya tuple(torch.Tensor)
SamHQVisionEncoderOutput veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırmaya (SamHQConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
SamHQVisionModel forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
image_embeds (
torch.Tensor, şekli(batch_size, output_dim), isteğe bağlı, modelwith_projection=Trueile başlatıldığında döndürülür) — pooler_output'a projeksiyon katmanının uygulanmasıyla elde edilen gömme değerleri.last_hidden_state (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size), isteğe bağlı) — Modelin son katmanının çıktısındaki gizli durumlar dizisi.hidden_states (
tuple[torch.Tensor, ...], isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, sequence_length, hidden_size)biçiminde bir demet.Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
attentions (
tuple[torch.Tensor, ...], isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —(batch_size, num_heads, sequence_length, sequence_length)biçiminde, her katman için bir adet içerentorch.Tensordemeti.Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat başlıklarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
intermediate_embeddings (
list(torch.Tensor), isteğe bağlı) — Model içindeki belirli bloklardan, genellikle pencereleme dikkati (windowed attention) içermeyen bloklardan toplanan ara gömme (embedding) listesi. Listedeki her öğenin şekli(batch_size, sequence_length, hidden_size)'dir. Bu özellik SAM-HQ'ye özgüdür ve temel SAM'de bulunmaz.
SamHQModel
sınıf transformers.SamHQModel
< source >( config: SamHQConfig )
Parametreler
- config (SamHQConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Girdi olarak bir görüntü ve isteğe bağlı 2D konum ile sınırlayıcı kutular verildiğinde maskeler üretmek için Segment Anything Model HQ (SAM-HQ).
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneinput_points: typing.Optional[torch.Tensor] = Noneinput_labels: typing.Optional[torch.LongTensor] = Noneinput_boxes: typing.Optional[torch.Tensor] = Noneinput_masks: typing.Optional[torch.LongTensor] = Noneimage_embeddings: typing.Optional[torch.Tensor] = Nonemultimask_output: bool = Truehq_token_only: bool = Falseattention_similarity: typing.Optional[torch.Tensor] = Nonetarget_embedding: typing.Optional[torch.Tensor] = Noneintermediate_embeddings: list[torch.Tensor] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> )
Parametreler
- pixel_values (
torch.Tensor, şekli(batch_size, num_channels, image_size, image_size), isteğe bağlı) — Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri SamImageProcessor kullanılarak elde edilebilir. Ayrıntılar için SamImageProcessor.call() bölümüne bakın (SamHQProcessor, görüntüleri işlemek için SamImageProcessor kullanır). - input_points (
torch.Tensor, şekli(batch_size, num_points, 2)) — Girdi 2B uzamsal noktalar; bu, prompt kodlayıcısının (prompt encoder) promptu kodlaması için kullanılır. Genel olarak çok daha iyi sonuçlar verir. Noktalar, işlemciye (processor) liste içi liste içi liste geçirilerek elde edilebilir; işlemci buna karşılık gelen 4 boyutlutorchtensörlerini oluşturur. İlk boyut görüntü parti boyutudur, ikinci boyut nokta parti boyutudur (yani girdi noktası başına modelden kaç segmentasyon maskesi tahmin etmesini istediğimiz), üçüncü boyut segmentasyon maskesi başına nokta sayısıdır (tek bir maske için birden fazla nokta geçirilebilir) ve son boyut noktanın x (dikey) ve y (yatay) koordinatlarıdır. Her görüntü için veya her maske için farklı sayıda nokta geçirilirse, işlemci (0, 0) koordinatına karşılık gelen “PAD” noktaları oluşturur ve bu noktalar için etiketler kullanılarak gömme (embedding) hesabı atlanır. - input_labels (
torch.LongTensorşeklinde(batch_size, point_batch_size, num_points)) — Noktalar için giriş etiketleri; bu, prompt kodlayıcısının prompt'u kodlamasında kullanılır. Resmi uygulamanın belirttiğine göre 3 tür etiket vardır1: nokta, ilgi nesnesini içeren bir noktadır0: nokta, ilgi nesnesini içermeyen bir noktadır-1: nokta arka plana karşılık gelir
Etiketi ekledik:
-10: nokta bir dolgu noktasıdır, bu nedenle prompt kodlayıcı tarafından yok sayılmalıdır
Dolgu etiketleri, işlemci tarafından otomatik olarak yapılmalıdır.
- input_boxes (
torch.Tensorşeklinde(batch_size, num_boxes, 4)) — Noktalar için giriş kutuları; bu, prompt kodlayıcısının (prompt encoder) prompt'u kodlaması için kullanılır. Genel olarak çok daha iyi üretilen maskeler sağlar. Kutular, işlemciye (processor) liste içeren liste içeren liste geçirilerek elde edilebilir; bu işlem birtorchtensörü oluşturur ve her boyut sırasıyla görüntü partisi boyutuna, görüntü başına kutu sayısına ve kutunun sol üst ile sağ alt noktasının koordinatlarına karşılık gelir. Sırasıyla (x1,y1,x2,y2):x1: giriş kutusunun sol üst noktasının x koordinatıy1: girdi kutusunun sol üst noktasının y koordinatıx2: giriş kutusunun sağ alt noktasının x koordinatıy2: giriş kutusunun sağ alt noktasının y koordinatı
- input_masks (
torch.Tensor, şekli(batch_size, image_size, image_size)) — SAM_HQ modeli, girdi olarak segmentasyon maskelerini de kabul eder. Maske, prompt encoder tarafından gömülecek (embed) ve daha sonra mask decoder'a beslenecek olan karşılık gelen bir gömme (embedding) üretecektir. Bu maskelerin kullanıcı tarafından manuel olarak sağlanması gerekir ve şekilleri (batch_size,image_size,image_size) olmalıdır. - image_embeddings (
torch.Tensor, şekli(batch_size, output_channels, window_size, window_size)) — Görsel gömlemeleri (embeddings); bunlar, mask decoder tarafından maskeler ve iou skorları üretmek için kullanılır. Daha bellek verimli hesaplama için kullanıcılar, önceget_image_embeddingsmetodunu kullanarak görsel gömlemelerini alabilir ve ardındanpixel_valuesyerine bunlarıforwardmetoduna girdi olarak verebilir. - multimask_output (
bool, isteğe bağlı) — Orijinal uygulama ve makalede, model her zaman görüntü başına 3 maske (ilgili durumlarda nokta başına / sınırlayıcı kutu başına) üretir. Ancak,multimask_output=Falsebelirtmek suretiyle, yalnızca “en iyi” maskeye karşılık gelen tek bir maske üretmek mümkündür. - hq_token_only (
bool, isteğe bağlı, varsayılanFalse) — Maske üretimi için yalnızca HQ token yolunun kullanılıp kullanılmayacağını belirtir. False olduğunda, hem standart hem de HQ yolları birleştirilir. Bu, SAM-HQ mimarisine özgüdür. - attention_similarity (
torch.Tensor, isteğe bağlı) — Model, PerSAM'da tanıtıldığı gibi kişiselleştirme için kullanılıyorsa hedefe yönelik dikkat için mask kodlayıcıya sağlanacak dikkat benzerlik tensörü. - target_embedding (
torch.Tensor, isteğe bağlı) — Model, PerSAM'de tanıtıldığı gibi kişiselleştirme için kullanılıyorsa, hedef-antikavram istemciliği için mask çözücüye sağlanacak hedef kavram gömme. - intermediate_embeddings (
List[torch.Tensor], isteğe bağlı) — SAM-HQ tarafından geliştirilmiş maske kalitesi için kullanılan, görüntü kodlayıcısının penceresiz bloklarından gelen ara gömlemeler. pixel_values yerine önceden hesaplanmış image_embeddings sağlandığında gereklidir.
SamHQModel forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
Örnek:
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor

>>> model = AutoModel.from_pretrained("sushmanth/sam_hq_vit_b")
>>> processor = AutoProcessor.from_pretrained("sushmanth/sam_hq_vit_b")

>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]]  # 2D location of a window on the car
>>> inputs = processor(images=image, input_points=input_points, return_tensors="pt")

>>> # Get high-quality segmentation mask
>>> outputs = model(**inputs)

>>> # For high-quality mask only
>>> outputs = model(**inputs, hq_token_only=True)

>>> # Postprocess masks
>>> masks = processor.post_process_masks(
...     outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )