
Transformers documentation
Оптимизация
Оптимизация
Модуль .optimization предоставляет:
- оптимизатор с фиксированным weight decay, который можно использовать для дообучения моделей, и
- несколько расписаний в виде объектов расписаний, наследующих от
_LRSchedule: - класс накопления градиентов для накопления градиентов нескольких батчей
AdaFactor
класс transformers.Adafactor
< source >( paramslr = Noneeps = (1e-30, 0.001)clip_threshold = 1.0decay_rate = -0.8beta1 = Noneweight_decay = 0.0scale_parameter = Truerelative_step = Truewarmup_init = False )
Параметры
- params (
Iterable[nn.parameter.Parameter]) — Итерируемый объект параметров для оптимизации или словари, определяющие группы параметров. - lr (
float, необязательный) — Внешняя скорость обучения. - eps (
tuple[float, float], необязательный, по умолчанию(1e-30, 0.001)) — Константы регуляризации для квадратного градиента и масштаба параметра соответственно - clip_threshold (
float, необязательный, по умолчанию 1.0) — Порог среднеквадратичного значения окончательного обновления градиента - decay_rate (
float, необязательный, по умолчанию -0.8) — Коэффициент, используемый для вычисления скользящих средних квадратов - beta1 (
float, необязательный) — Коэффициент, используемый для вычисления скользящих средних градиента - weight_decay (
float, необязательный, по умолчанию 0.0) — Коэффициент затухания весов (штраф L2) - scale_parameter (
bool, необязательный, по умолчаниюTrue) — Если True, скорость обучения масштабируется среднеквадратичным значением - relative_step (
bool, необязательный, по умолчаниюTrue) — Если True, вычисляется зависящая от времени скорость обучения вместо внешней скорости обучения - warmup_init (
bool, необязательный, по умолчаниюFalse) — Вычисление зависимости скорости обучения от времени зависит от того, используется ли инициализация с разгоном
Реализация AdaFactor для PyTorch может использоваться как прямая замена для Adam в исходном коде fairseq: https://github.com/pytorch/fairseq/blob/master/fairseq/optim/adafactor.py
Статья: Adafactor: Adaptive Learning Rates with Sublinear Memory Cost https://huggingface.co/papers/1804.04235 Обратите внимание, что этот оптимизатор внутренним образом корректирует скорость обучения в зависимости от параметров scale_parameter, relative_step и warmup_init. Чтобы использовать ручное (внешнее) расписание скорости обучения, необходимо установить scale_parameter=False и relative_step=False.
Эта реализация поддерживает значения с низкой точностью (FP16, bfloat), однако мы не проводили её тщательное тестирование.
Рекомендуемые настройки дообучения T5 (https://huggingface.co/proxy/discuss.huggingface.co/t/t5-finetuning-tips/684/3):
Не рекомендуется выполнять обучение без LR warmup или clip_threshold.
- использование запланированного прогрева LR до фиксированного LR
- используйте clip_threshold=1.0 (https://huggingface.co/papers/1804.04235)
Отключить относительные обновления
Используйте scale_parameter=False
Дополнительные операции оптимизатора, такие как обрезка градиентов, не следует использовать вместе с Adafactor
Пример:
Adafactor(model.parameters(), scale_parameter=False, relative_step=False, warmup_init=False, lr=1e-3)Другие сообщали, что следующая комбинация хорошо работает:
Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)При использовании lr=None вместе с Trainer, скорее всего, вам потребуется использовать AdafactorSchedule
scheduler следующим образом:
from transformers.optimization import Adafactor, AdafactorSchedule

optimizer = Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)
lr_scheduler = AdafactorSchedule(optimizer)
trainer = Trainer(..., optimizers=(optimizer, lr_scheduler))
Использование:
# replace AdamW with Adafactor
optimizer = Adafactor(
    model.parameters(),
    lr=1e-3,
    eps=(1e-30, 1e-3),
    clip_threshold=1.0,
    decay_rate=-0.8,
    beta1=None,
    weight_decay=0.0,
    relative_step=False,
    scale_parameter=False,
    warmup_init=False,
)
шаг
< source >( closure = None )
Выполняет один шаг оптимизации
Расписания
SchedulerType
класс transformers.SchedulerType
< source >( valuenames = Nonemodule = Nonequalname = Nonetype = Nonestart = 1boundary = None )
Имена планировщиков для параметра lr_scheduler_type в TrainingArguments.
По умолчанию используется «linear». Внутренне это получает планировщик get_linear_schedule_with_warmup из Trainer.
Типы планировщиков:
- “linear” = get_linear_schedule_with_warmup()
- “cosine” = get_cosine_schedule_with_warmup()
- “cosine_with_restarts” = get_cosine_with_hard_restarts_schedule_with_warmup()
- “polynomial” = get_polynomial_decay_schedule_with_warmup()
- “constant” = get_constant_schedule()
- “constant_with_warmup” = get_constant_schedule_with_warmup()
- “inverse_sqrt” = get_inverse_sqrt_schedule()
- “reduce_lr_on_plateau” = get_reduce_on_plateau_schedule()
- “cosine_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup()
- “cosine_warmup_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup_lr_rate()
- “warmup_stable_decay” = get_wsd_schedule()
- “greedy” = get_greedy_schedule()
get_scheduler
transformers.get_scheduler
< source >( name: str | SchedulerTypeoptimizer: Optimizernum_warmup_steps: int | None = Nonenum_training_steps: int | None = Nonescheduler_specific_kwargs: dict | None = None )
Параметры
- name (
strилиSchedulerType) — Имя планировщика, который следует использовать. - optimizer (
torch.optim.Optimizer) — Оптимизатор, который будет использоваться во время обучения. - num_warmup_steps (
int, необязательный) — Количество шагов прогрева. Не все планировщики требуют этот параметр (поэтому аргумент является необязательным); если он не задан, а тип планировщика его требует, функция вызовет ошибку. - num_training_steps (`int“, необязательный) — Количество шагов обучения. Не все планировщики требуют этот параметр (поэтому аргумент является необязательным); если он не задан, а тип планировщика его требует, функция вызовет ошибку.
- scheduler_specific_kwargs (
dict, необязательный) — Дополнительные параметры для планировщиков, например, для косинусного с перезапусками. Несоответствие типа планировщика и его параметров приведет к тому, что функция планировщика вызовет TypeError.
Единый API для получения любого планировщика по его имени.
get_constant_schedule
transformers.get_constant_schedule
< source >( optimizer: Optimizerlast_epoch: int = -1 )
Создайте расписание с постоянной скоростью обучения, используя скорость обучения, заданную в оптимизаторе.
get_constant_schedule_with_warmup
transformers.get_constant_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intlast_epoch: int = -1 )
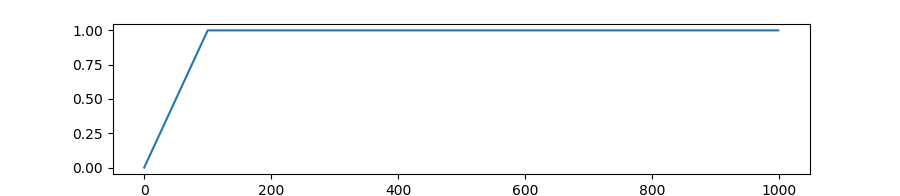
Создайте расписание с постоянной скоростью обучения, предшествующее которому период прогрева, в течение которого скорость обучения линейно возрастает от 0 до начального значения lr, заданного в оптимизаторе.
get_cosine_schedule_with_warmup
transformers.get_cosine_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - num_cycles (
float, необязательный, по умолчанию 0.5) — Количество волн в косинусной расписке (по умолчанию значение просто уменьшается от максимального до 0 по закону полукосинуса). - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
Создайте расписание с коэффициентом обучения, который уменьшается по значениям косинусоидальной функции от начального значения lr, заданного в оптимизаторе, до 0, после периода прогрева, в течение которого он линейно возрастает от 0 до начального значения lr, заданного в оптимизаторе.

get_cosine_with_hard_restarts_schedule_with_warmup
transformers.get_cosine_with_hard_restarts_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: int = 1last_epoch: int = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - num_cycles (
int, необязательный, по умолчанию 1) — Количество жёстких перезапусков. - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
Создайте расписание с коэффициентом обучения, который уменьшается по значениям косинусоидальной функции от начального значения lr, заданного в оптимизаторе, до 0, с несколькими жёсткими перезапусками, после периода прогрева, в течение которого он линейно возрастает от 0 до начального значения lr, заданного в оптимизаторе.
get_cosine_with_min_lr_schedule_with_warmup
transformers.get_cosine_with_min_lr_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = None )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - num_cycles (
float, необязательный, по умолчанию 0.5) — Количество волн в косинусной расписке (по умолчанию значение просто уменьшается от максимального до 0 по закону полукосинуса). - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения. - min_lr (
float, необязательный) — Минимальная скорость обучения, к которой нужно прийти после косинусной расписки. - min_lr_rate (
float, необязательный) — Минимальная скорость обучения как доля от начальной скорости обучения. Если задано,min_lrне должно быть задано.
Создайте расписание с коэффициентом обучения, который уменьшается по значениям косинусоидальной функции от начального lr, заданного в оптимизаторе, до min_lr, после периода прогрева, в течение которого он линейно возрастает от 0 до начального lr, заданного в оптимизаторе.
get_cosine_with_min_lr_schedule_with_warmup_lr_rate
transformers.get_cosine_with_min_lr_schedule_with_warmup_lr_rate
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = Nonewarmup_lr_rate: float | None = None )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - num_cycles (
float, необязательный, по умолчанию 0.5) — Количество волн в косинусной расписке (по умолчанию значение просто уменьшается от максимального до 0 по закону полукосинуса). - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения. - min_lr (
float, необязательный) — Минимальная скорость обучения, к которой нужно прийти после косинусной расписки. - min_lr_rate (
float, необязательный) — Минимальная скорость обучения как доля от начальной скорости обучения. Если задано,min_lrне должно быть задано. - warmup_lr_rate (
float, необязательный) — Минимальная скорость обучения в виде отношения к начальной скорости обучения. Если не задано,warmup_lr_rateбудет рассматриваться как float(1/num_warmup_steps).
Создайте расписание с коэффициентом обучения, который уменьшается по значениям косинусоидальной функции от начального lr, заданного в оптимизаторе, до min_lr, после периода прогрева, в течение которого он линейно возрастает от 0 до начального lr, заданного в оптимизаторе.

GreedyLR
класс transformers.GreedyLR
< source >( optimizer: Optimizermode: str = 'min'factor: float = 0.95patience: int = 10threshold: float = 1e-06threshold_mode: str = 'abs'cooldown: int = 0warmup: int = 0min_lr: float | list[float] = 0.001max_lr: float | list[float] = 1.0eps: float = 1e-08verbose: bool = Falsesmooth: bool = Falsewindow_size: int = 50reset_start: int = 500 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - mode (
str, необязательный, по умолчанию"min") — Одно из значений ‘min’ или ‘max’. В режиме ‘min’ LR снижается, когда метрика перестает уменьшаться; в режиме ‘max’ — когда перестает увеличиваться. - factor (
float, необязательный, по умолчанию 0.95) — Коэффициент, на который будет скорректирована скорость обучения. На плато скорость обучения умножается на factor, а при улучшении — делится на factor. Должно быть < 1.0. - patience (
int, необязательный, по умолчанию 10) — Количество эпох без улучшения, после которого будет скорректирована скорость обучения. - threshold (
float, необязательный, по умолчанию 1e-06) — Порог для измерения нового оптимума. - threshold_mode (
str, необязательный, по умолчанию"abs") — Одно из значений ‘rel’ или ‘abs’. - cooldown (
int, необязательный, по умолчанию 0) — Количество эпох ожидания перед возобновлением нормальной работы после снижения LR. - warmup (
int, необязательный, по умолчанию 0) — Количество эпох ожидания перед возобновлением нормальной работы после повышения LR. - min_lr (
floatилиlist[float], необязательный, по умолчанию 0.001) — Нижняя граница для коэффициента обучения. - max_lr (
floatилиlist[float], необязательный, по умолчанию 1.0) — Верхняя граница для коэффициента обучения. - eps (
float, необязательный, по умолчанию 1e-08) — Минимальное затухание, применяемое к lr. - verbose (
bool, необязательный, по умолчаниюFalse) — Если True, выводит сообщение в stdout для каждого обновления. - smooth (
bool, необязательный, по умолчаниюFalse) — Если True, применяется сглаживание скользящим средним к метрикам. - window_size (
int, необязательный, по умолчанию 50) — Размер окна для скользящего среднего при smooth=True. - reset_start (
int, необязательный, по умолчанию 500) — Количество шагов ожидания на min_lr перед сбросом к начальному состоянию.
Адаптивный планировщик скорости обучения, реагирующий на метрики обучения.
GreedyLR динамически корректирует скорость обучения на основе результатов обучения:
- Увеличивает LR, если метрики последовательно улучшаются (делит на коэффициент)
- Уменьшает LR при стабилизации метрик (умножает на коэффициент)
Это отличается от традиционных планировщиков, таких как косинусная аннеалинг, тем, что реагирует на фактическую динамику обучения, а не следует заранее заданному расписанию.
Ссылка: GreedyLR: A Novel Adaptive Learning Rate Scheduler <https://arxiv.org/abs/2512.14527>_
Пример:
>>> optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
>>> scheduler = GreedyLR(optimizer, mode="min", patience=10)
>>> for epoch in range(100):
...     train(...)
...     val_loss = validate(...)
... scheduler.step(val_loss)Возвращает последнее вычисленное значение коэффициента обучения текущим планировщиком.
Загрузить состояние из словаря.
Возвращает состояние планировщика в виде словаря.
шаг
< source >( metrics: floatepoch: int | None = None )
Выполнить шаг планировщика на основе переданных метрик.
get_greedy_schedule
transformers.get_greedy_schedule
< source >( optimizer: Optimizer**kwargs )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - kwargs (
dict, необязательный) — Дополнительные параметры, передаваемые планировщику. См. GreedyLR для списка возможных параметров.
Создайте адаптивный планировщик скорости обучения, который корректирует LR на основе метрик обучения.
get_linear_schedule_with_warmup
transformers.get_linear_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslast_epoch = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
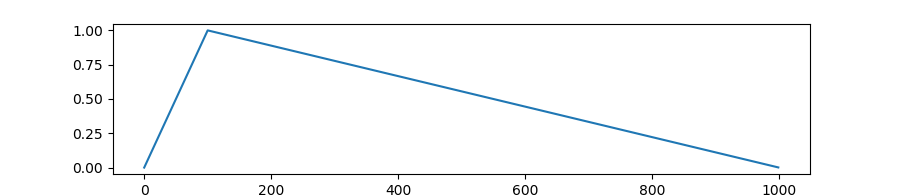
Создайте расписание с коэффициентом обучения, который линейно уменьшается от начального lr, заданного в оптимизаторе, до 0, после периода прогрева, в течение которого он линейно возрастает от 0 до начального lr, заданного в оптимизаторе.
get_polynomial_decay_schedule_with_warmup
transformers.get_polynomial_decay_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslr_end = 1e-07power = 1.0last_epoch = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_training_steps (
int) — Общее количество шагов обучения. - lr_end (
float, необязательный, по умолчанию 1e-7) — Конечное значение LR. - power (
float, необязательный, по умолчанию 1.0) — Коэффициент степени. - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
Создайте расписание с коэффициентом обучения, который уменьшается по полиномиальному закону затухания от начального lr, заданного в оптимизаторе, до конечного lr, определённого параметром lr_end, после периода прогрева, в течение которого он линейно возрастает от 0 до начального lr, заданного в оптимизаторе.
Примечание: power по умолчанию равно 1.0, как в реализации fairseq, которая, в свою очередь, основана на исходной реализации BERT по адресу https://github.com/google-research/bert/blob/f39e881b169b9d53bea03d2d341b31707a6c052b/optimization.py#L37
get_inverse_sqrt_schedule
transformers.get_inverse_sqrt_schedule
< source >( optimizer: Optimizernum_warmup_steps: inttimescale: int | None = Nonelast_epoch: int = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - timescale (
int, необязательный, по умолчаниюnum_warmup_steps) — Масштаб времени. - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
Создайте расписание с обратной квадратно-корневой функцией для скорости обучения, начиная с начального значения lr, заданного в оптимизаторе, после периода прогрева, в течение которого lr линейно увеличивается от 0 до начального значения lr, заданного в оптимизаторе.
get_reduce_on_plateau_schedule
transformers.get_reduce_on_plateau_schedule
< source >( optimizer: Optimizer**kwargs )
Создайте расписание с постоянной скоростью обучения, которая снижается, когда метрика перестала улучшаться.
get_wsd_schedule
transformers.get_wsd_schedule
< source >( optimizer: Optimizernum_warmup_steps: intnum_decay_steps: intnum_training_steps: int | None = Nonenum_stable_steps: int | None = Nonewarmup_type: str = 'linear'decay_type: str = 'cosine'min_lr_ratio: float = 0num_cycles: float = 0.5last_epoch: int = -1 )
Параметры
- optimizer (
~torch.optim.Optimizer) — Оптимизатор, для которого планируется изменение скорости обучения. - num_warmup_steps (
int) — Количество шагов для фазы прогрева. - num_decay_steps (
int) — Количество шагов фазы затухания. - num_training_steps (
int, необязательный) — Общее количество шагов обучения. Это сумма шагов разгона, стабильной фазы и фазы затухания. Еслиnum_stable_stepsне задан, длительность стабильной фазы будет равнаnum_training_steps - num_warmup_steps - num_decay_steps. - num_stable_steps (
int, необязательный) — Количество шагов для стабильной фазы. Убедитесь, чтоnum_warmup_steps + num_stable_steps + num_decay_stepsравноnum_training_steps, иначе для остальных шагов будет использоваться минимальная скорость обучения. - warmup_type (
str, необязательный, по умолчанию “linear”) — Тип warmup. Может быть ‘linear’, ‘cosine’ или ‘1-sqrt’. - decay_type (
str, необязательный, по умолчанию “cosine”) — Тип используемого затухания. Может быть ‘linear’, ‘cosine’ или ‘1-sqrt’. - min_lr_ratio (
float, необязательный, по умолчанию 0) — Минимальная скорость обучения в виде отношения к начальной скорости обучения. - num_cycles (
float, необязательный, по умолчанию 0.5) — Количество волн в косинусной расписке (по умолчанию значение просто уменьшается от максимального до 0 по закону полукосинуса). - last_epoch (
int, необязательный, по умолчанию -1) — Индекс последней эпохи при возобновлении обучения.
Создайте расписание с коэффициентом обучения, имеющим три этапа:
- warmup: увеличение с min_lr_ratio от начальной скорости обучения до начальной скорости обучения в соответствии с warmup_type.
- stable: постоянная скорость обучения.
- decay: снижение от начальной скорости обучения до значения, равного min_lr_ratio от начальной скорости обучения, в соответствии с decay_type.