
Transformers documentation
OmDet-Turbo
Este modelo se publicó en HF papers el 2024-03-11 y se contribuyó a Hugging Face Transformers el 2024-09-25.
OmDet-Turbo
Resumen
El modelo OmDet-Turbo fue propuesto en Real-time Transformer-based Open-Vocabulary Detection with Efficient Fusion Head por Tiancheng Zhao, Peng Liu, Xuan He, Lu Zhang, Kyusong Lee. OmDet-Turbo incorpora componentes de RT-DETR e introduce un módulo de fusión multimodal ágil para lograr capacidades de detección de objetos de vocabulario abierto en tiempo real, manteniendo al mismo tiempo una alta precisión. El modelo base alcanza un rendimiento de hasta 100.2 FPS y 53.4 AP en COCO zero-shot.
El resumen del artículo es el siguiente:
Los detectores basados en transformers de extremo a extremo (DETR) han demostrado un rendimiento excepcional en tareas de detección de objetos tanto en conjuntos cerrados como en vocabulario abierto (OVD) mediante la integración de modalidades de lenguaje. Sin embargo, sus exigentes requisitos computacionales han obstaculizado su aplicación práctica en escenarios de detección de objetos en tiempo real (OD). En este artículo, analizamos las limitaciones de dos modelos líderes en el benchmark OVDEval, OmDet y Grounding-DINO, e introducimos OmDet-Turbo. Este nuevo modelo de OVD en tiempo real basado en transformers incorpora un módulo innovador de Efficient Fusion Head (EFH) diseñado para aliviar los cuellos de botella observados en OmDet y Grounding-DINO. Cabe destacar que OmDet-Turbo-Base alcanza 100,2 fotogramas por segundo (FPS) al aplicar técnicas de TensorRT y caché de lenguaje. Además, en escenarios zero-shot en los conjuntos de datos COCO y LVIS, OmDet-Turbo logra niveles de rendimiento casi equivalentes a los de los modelos supervisados más avanzados actuales. Asimismo, establece nuevos benchmarks de estado del arte en ODinW y OVDEval, con un AP de 30,1 y un NMS-AP de 26,86, respectivamente. La viabilidad de OmDet-Turbo en aplicaciones industriales se resalta por su rendimiento excepcional en conjuntos de datos de referencia y su velocidad de inferencia superior, lo que lo posiciona como una opción atractiva para tareas de detección de objetos en tiempo real.
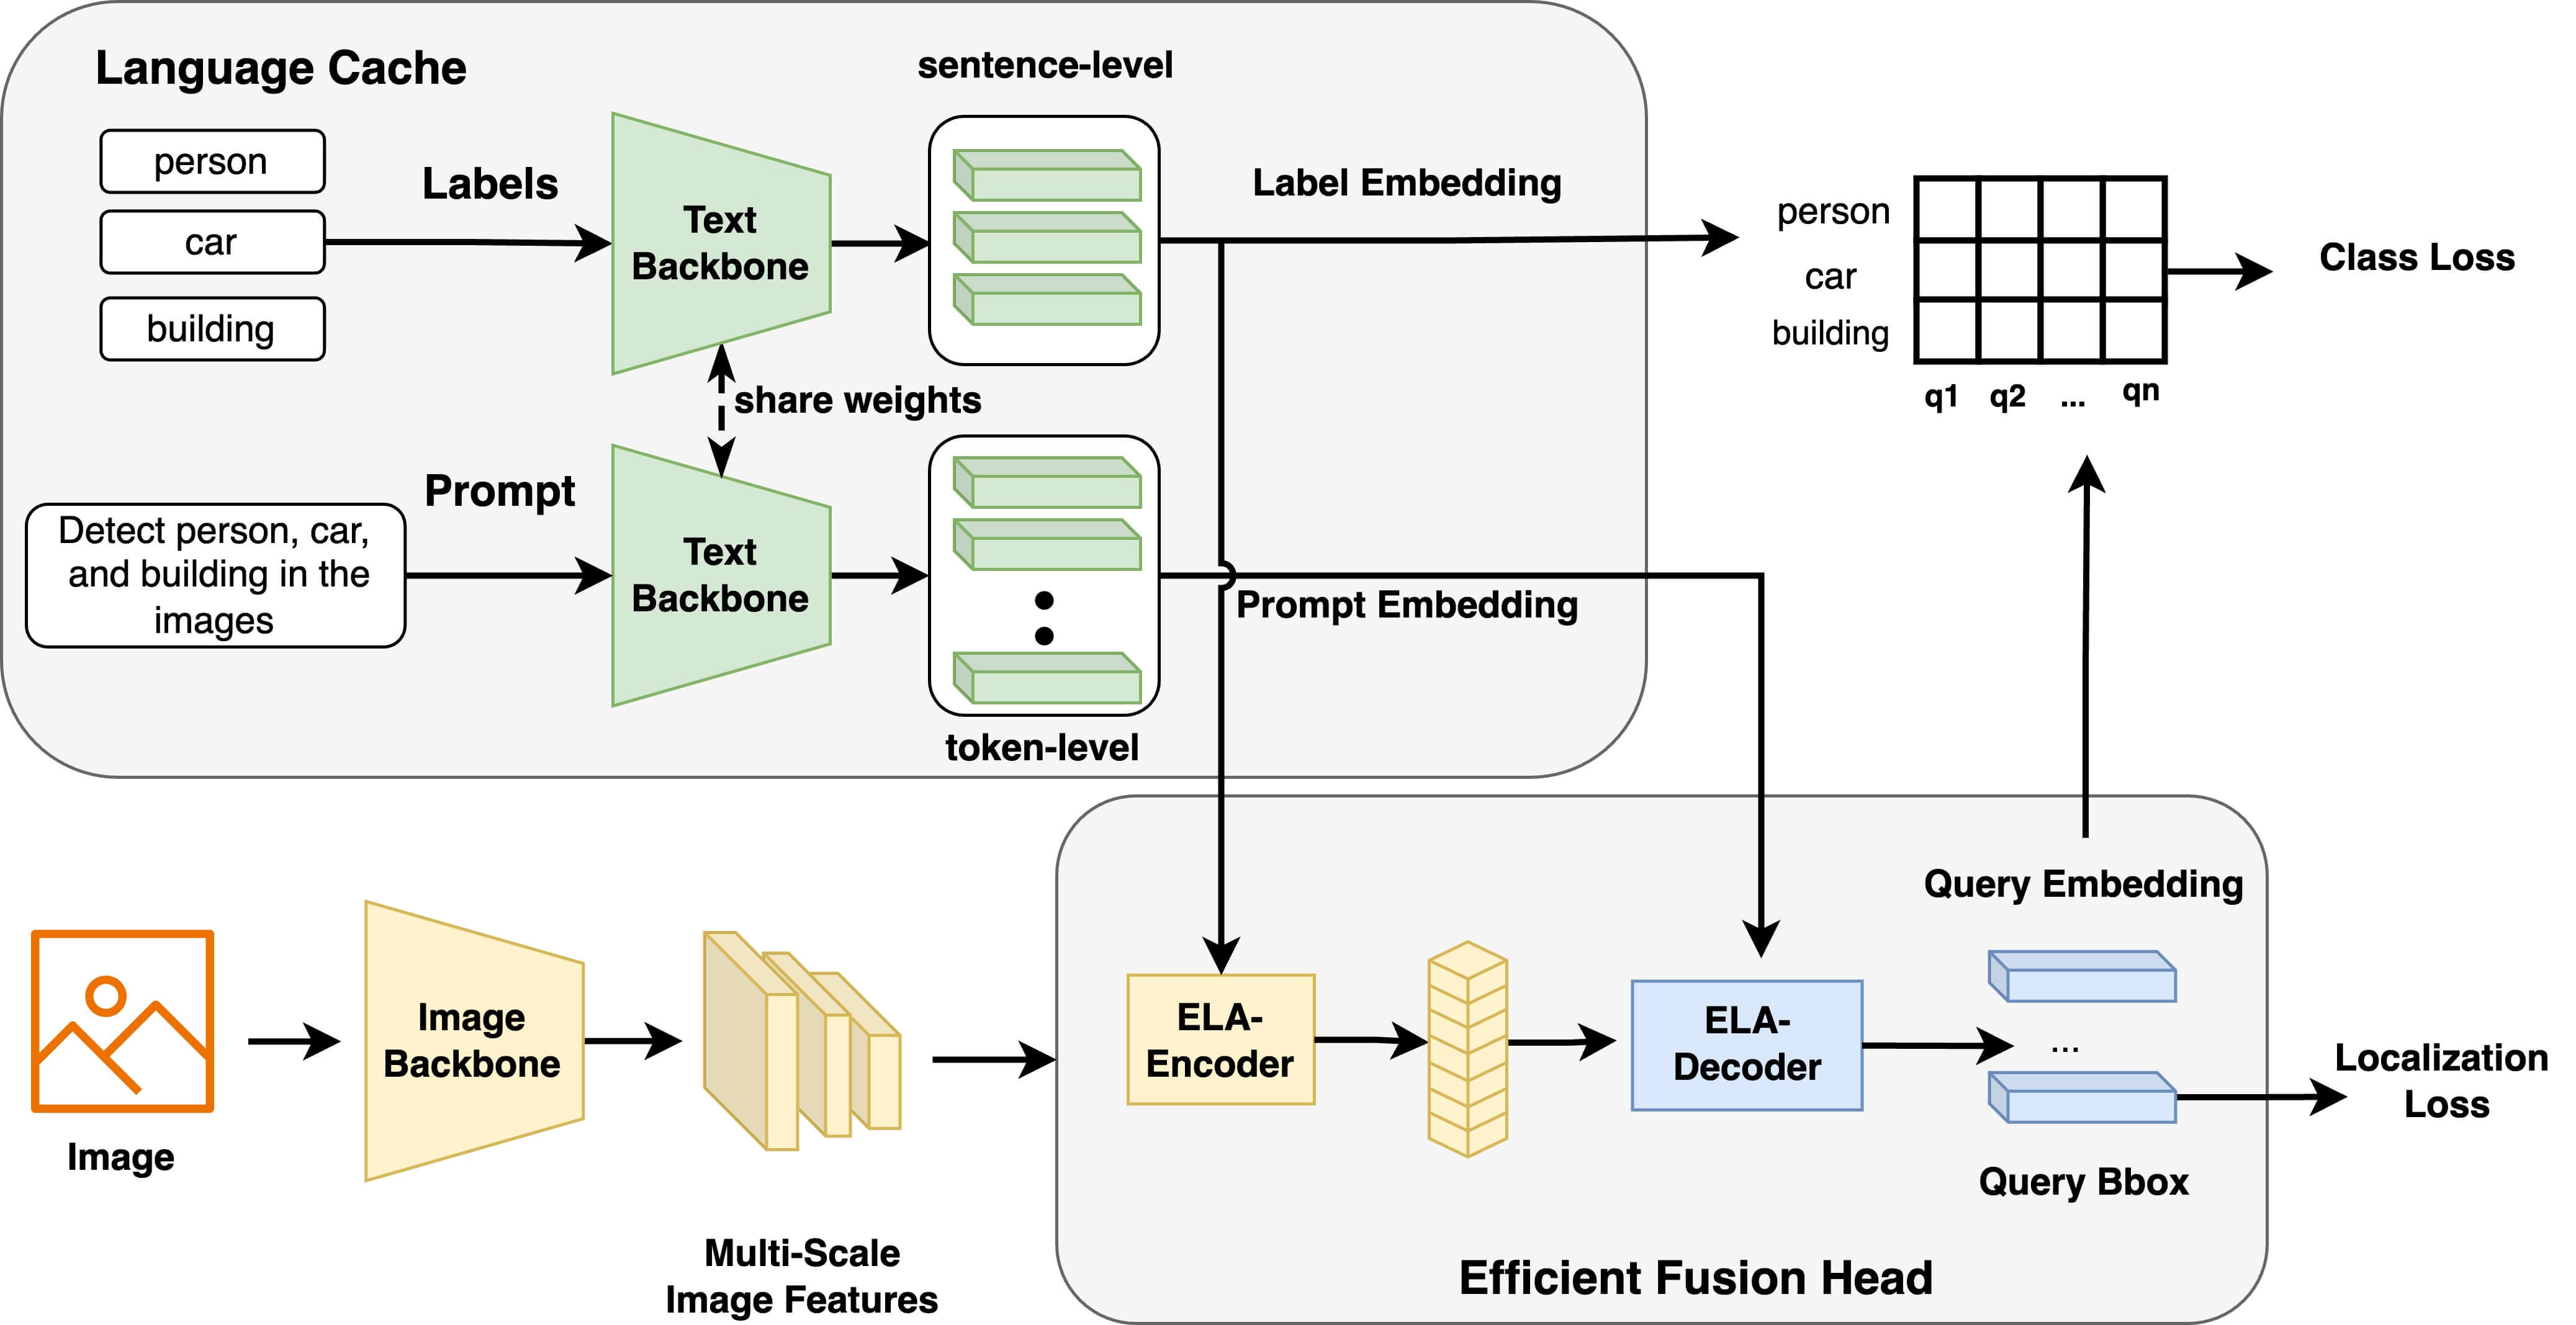 OmDet-Turbo architecture overview. Taken from the original paper.
Este modelo fue aportado por yonigozlan. El código original se puede encontrar aquí.
Consejos de uso
Una propiedad única de OmDet-Turbo en comparación con otros modelos de detección de objetos sin ejemplos, como Grounding DINO, es la estructura desacoplada de clases y embeddings de prompt que permite la caché de embeddings de texto. Esto significa que el modelo requiere tanto clases como tarea como entradas, donde classes es una lista de objetos que queremos detectar y task es el texto con anclaje utilizado para guiar la detección de vocabulario abierto. Este enfoque limita el alcance de la detección de vocabulario abierto y hace que el proceso de decodificación sea más rápido.
OmDetTurboProcessor se utiliza para preparar el tripleto de clases, tarea e imagen. La entrada de la tarea es opcional y, si no se proporciona, se usa por defecto "Detect [class1], [class2], [class3], ...". Para procesar los resultados del modelo, se puede utilizar post_process_grounded_object_detection de OmDetTurboProcessor. Cabe destacar que esta función recibe las clases de entrada, ya que, a diferencia de otros modelos de detección de objetos zero-shot, el desacoplamiento de las incrustaciones de clases y de tareas significa que no es necesario decodificar las incrustaciones de clases predichas en el paso de posprocesamiento, y las clases predichas pueden coincidir directamente con las proporcionadas.
Ejemplo de uso
Inferencia de una sola imagen
Así es como se carga el modelo y se preparan las entradas para realizar la detección de objetos sin ejemplos en una sola imagen:
import torch
import requests
from PIL import Image

from transformers import AutoProcessor, OmDetTurboForObjectDetection

processor = AutoProcessor.from_pretrained("omlab/omdet-turbo-swin-tiny-hf")
model = OmDetTurboForObjectDetection.from_pretrained("omlab/omdet-turbo-swin-tiny-hf", device_map="auto")

url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = ["cat", "remote"]
inputs = processor(image, text=text_labels, return_tensors="pt").to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

# convert outputs (bounding boxes and class logits)
results = processor.post_process_grounded_object_detection(
    outputs,
    target_sizes=[(image.height, image.width)],
    text_labels=text_labels,
    threshold=0.3,
    nms_threshold=0.3,
)
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
    box = [round(i, 2) for i in box.tolist()]
    print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected remote with confidence 0.768 at location [39.89, 70.35, 176.74, 118.04]
Detected cat with confidence 0.72 at location [11.6, 54.19, 314.8, 473.95]
Detected remote with confidence 0.563 at location [333.38, 75.77, 370.7, 187.03]
Detected cat with confidence 0.552 at location [345.15, 23.95, 639.75, 371.67]
Inferencia con múltiples imágenes
OmDet-Turbo puede realizar inferencia por lotes con múltiples imágenes, con soporte para diferentes prompts de texto y clases en el mismo lote:
import torch
import requests
from io import BytesIO
from PIL import Image
from transformers import AutoProcessor, OmDetTurboForObjectDetection

processor = AutoProcessor.from_pretrained("omlab/omdet-turbo-swin-tiny-hf")
model = OmDetTurboForObjectDetection.from_pretrained("omlab/omdet-turbo-swin-tiny-hf", device_map="auto")

url1 = "http://images.cocodataset.org/val2017/000000039769.jpg"
image1 = Image.open(BytesIO(requests.get(url1).content)).convert("RGB")
text_labels1 = ["cat", "remote"]
task1 = "Detect {}.".format(", ".join(text_labels1))

url2 = "http://images.cocodataset.org/train2017/000000257813.jpg"
image2 = Image.open(BytesIO(requests.get(url2).content)).convert("RGB")
text_labels2 = ["boat"]
task2 = "Detect everything that looks like a boat."

url3 = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/statue_of_liberty.jpg"
image3 = Image.open(BytesIO(requests.get(url3).content)).convert("RGB")
text_labels3 = ["statue", "trees"]
task3 = "Focus on the foreground, detect statue and trees."

inputs = processor(
    images=[image1, image2, image3],
    text=[text_labels1, text_labels2, text_labels3],
    task=[task1, task2, task3],
    return_tensors="pt",
)

with torch.no_grad():
    outputs = model(**inputs)

# convert outputs (bounding boxes and class logits)
results = processor.post_process_grounded_object_detection(
    outputs,
    text_labels=[text_labels1, text_labels2, text_labels3],
    target_sizes=[(image.height, image.width) for image in [image1, image2, image3]],
    threshold=0.2,
    nms_threshold=0.3,
)

for i, result in enumerate(results):
    for score, text_label, box in zip(
        result["scores"], result["text_labels"], result["boxes"]
    ):
        box = [round(i, 1) for i in box.tolist()]
        print(
            f"Detected {text_label} with confidence "
            f"{round(score.item(), 2)} at location {box} in image {i}"
        )
Detected remote with confidence 0.77 at location [39.9, 70.4, 176.7, 118.0] in image 0
Detected cat with confidence 0.72 at location [11.6, 54.2, 314.8, 474.0] in image 0
Detected remote with confidence 0.56 at location [333.4, 75.8, 370.7, 187.0] in image 0
Detected cat with confidence 0.55 at location [345.2, 24.0, 639.8, 371.7] in image 0
Detected boat with confidence 0.32 at location [146.9, 219.8, 209.6, 250.7] in image 1
Detected boat with confidence 0.3 at location [319.1, 223.2, 403.2, 238.4] in image 1
Detected boat with confidence 0.27 at location [37.7, 220.3, 84.0, 235.9] in image 1
Detected boat with confidence 0.22 at location [407.9, 207.0, 441.7, 220.2] in image 1
Detected statue with confidence 0.73 at location [544.7, 210.2, 651.9, 502.8] in image 2
Detected trees with confidence 0.25 at location [3.9, 584.3, 391.4, 785.6] in image 2
Detected trees with confidence 0.25 at location [1.4, 621.2, 118.2, 787.8] in image 2
Detected statue with confidence 0.2 at location [428.1, 205.5, 767.3, 759.5] in image 2
OmDetTurboConfig
clase transformers.OmDetTurboConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneapply_layernorm_after_vision_backbone: bool = Trueimage_size: int | list[int] | tuple[int, int] = 640disable_custom_kernels: bool = Falselayer_norm_eps: float = 1e-05batch_norm_eps: float = 1e-05init_std: float = 0.02text_projection_in_dim: int = 512text_projection_out_dim: int = 512task_encoder_hidden_dim: int = 1024class_embed_dim: int = 512class_distance_type: typing.Literal['cosine', 'dot'] = 'cosine'num_queries: int = 900csp_activation: str = 'silu'conv_norm_activation: str = 'gelu'encoder_feedforward_activation: str = 'relu'encoder_feedforward_dropout: float | int = 0.0encoder_dropout: float | int = 0.0hidden_expansion: int = 1encoder_hidden_dim: int = 256vision_features_channels: list[int] | tuple[int, ...] = (256, 256, 256)encoder_in_channels: list[int] | tuple[int, ...] = (192, 384, 768)encoder_projection_indices: list[int] | tuple[int, ...] = (2,)encoder_attention_heads: int = 8encoder_dim_feedforward: int = 2048encoder_layers: int = 1positional_encoding_temperature: int = 10000num_feature_levels: int = 3decoder_hidden_dim: int = 256decoder_num_heads: int = 8decoder_num_layers: int = 6decoder_activation: str = 'relu'decoder_dim_feedforward: int = 2048decoder_num_points: int = 4decoder_dropout: float | int = 0.0eval_size: int | None = Nonelearn_initial_query: bool = Falsecache_size: int = 100 )
Parámetros
- is_encoder_decoder (
bool, opcional, valor predeterminadoTrue) — Indica si el modelo se utiliza como codificador/decodificador o no. - text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — El objeto de configuración o el diccionario del backbone de texto. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — La configuración del modelo backbone. - apply_layernorm_after_vision_backbone (
bool, opcional, valor predeterminadoTrue) — Si se aplica la normalización de capas a los mapas de características de la salida del vision backbone. - image_size (
Union[int, list[int], tuple[int, int]], opcional, valor predeterminado640) — El tamaño (resolución) de cada imagen. - disable_custom_kernels (
bool, opcional, valor predeterminadoFalse) — Si se desactivan los kernels personalizados. - layer_norm_eps (
float, opcional, valor predeterminado1e-05) — El epsilon utilizado por las capas de normalización de capa. - batch_norm_eps (
float, opcional, valor predeterminado1e-05) — La epsilon utilizada por las capas de normalización por lote. - init_std (
float, opcional, valor predeterminado0.02) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - text_projection_in_dim (
int, opcional, valor predeterminado 512) — La dimensión de entrada para la proyección de texto. - text_projection_out_dim (
int, opcional, valor predeterminado 512) — La dimensión de salida para la proyección de texto. - task_encoder_hidden_dim (
int, opcional, valor predeterminado 1024) — La dimensión del feedforward para el codificador de tareas. - class_embed_dim (
int, opcional, valor predeterminado 512) — La dimensión de las incrustaciones de clases. - class_distance_type (
str, opcional, valor predeterminado"cosine") — El tipo de distancia para comparar las clases predichas con las incrustaciones de las clases proyectadas. Puede ser"cosine"o"dot". - num_queries (
int, opcional, valor predeterminado 900) — El número de consultas. - csp_activation (
str, opcional, valor predeterminado"silu") — La función de activación de las redes Cross Stage Partial (CSP) del codificador. - conv_norm_activation (
str, opcional, valor predeterminado"gelu") — La función de activación de las capas ConvNormLayer del codificador. - encoder_feedforward_activation (
str, opcional, valor predeterminado"relu") — La función de activación de la red feedforward del codificador. - encoder_feedforward_dropout (
float, opcional, valor predeterminado 0.0) — La tasa de dropout que sigue a la activación de la red feedforward del codificador. - encoder_dropout (
Union[float, int], opcional, valor predeterminado0.0) — La proporción para todas las capas de dropout. - hidden_expansion (
int, opcional, valor predeterminado 1) — La expansión oculta de las redes CSP en el codificador. - encoder_hidden_dim (
int, opcional, valor predeterminado256) — Dimensión de las representaciones ocultas. - vision_features_channels (
tuple(int), opcional, valor predeterminado[256, 256, 256]) — Los canales de características visuales proyectadas que se utilizan como entradas para el decodificador. - encoder_in_channels (
List(int), opcional, valor predeterminado[192, 384, 768]) — Los canales de entrada para el codificador. - encoder_projection_indices (
List(int), opcional, valor predeterminado[2]) — Los índices de las características de entrada proyectadas por cada capa. - encoder_attention_heads (
int, opcional, valor predeterminado8) — Número de cabezas de atención para cada capa de atención en el codificador Transformer. - encoder_dim_feedforward (
int, opcional, valor predeterminado 2048) — La dimensión del feedforward para el codificador. - encoder_layers (
int, opcional, valor predeterminado1) — Número de capas ocultas en el codificador del Transformer. Usará el mismo valor quenum_layerssi no se establece. - positional_encoding_temperature (
int, opcional, valor predeterminado 10000) — La temperatura de la codificación posicional en el codificador. - num_feature_levels (
int, opcional, valor predeterminado 3) — El número de niveles de características para el módulo de atención deformable multiescala del decodificador. - decoder_hidden_dim (
int, opcional, valor predeterminado256) — Dimensión de las representaciones ocultas. - decoder_num_heads (
int, opcional, valor predeterminado8) — Número de cabezas de atención para cada capa de atención en el decodificador del Transformer. - decoder_num_layers (
int, opcional, valor predeterminado6) — Número de capas ocultas en el decodificador del Transformer. Si no se establece, se usará el mismo valor quenum_layers. - decoder_activation (
str, opcional, valor predeterminado"relu") — La función de activación para el decodificador. - decoder_dim_feedforward (
int, opcional, valor predeterminado 2048) — La dimensión del feedforward para el decodificador. - decoder_num_points (
int, opcional, valor predeterminado 4) — El número de puntos muestreados en el módulo de atención deformable multiescala del decodificador. - decoder_dropout (
float, opcional, valor predeterminado 0.0) — La tasa de dropout para el decodificador. - eval_size (
tuple[int, int], opcional) — Altura y ancho utilizados para calcular la altura y el ancho efectivos de los embeddings de posición después de tener en cuenta el stride (ver RTDetr). - learn_initial_query (
bool, opcional, valor predeterminadoFalse) — Si se debe aprender la consulta inicial. - cache_size (
int, opcional, valor predeterminado 100) — El tamaño de la caché para las cachés de clases y prompts.
Esta es la clase de configuración para almacenar la configuración de un Omdet TurboModel. Se utiliza para instanciar un modelo Omdet Turbo según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de omlab/omdet-turbo-swin-tiny-hf
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplos:
>>> from transformers import OmDetTurboConfig, OmDetTurboForObjectDetection

>>> # Initializing a OmDet-Turbo omlab/omdet-turbo-swin-tiny-hf style configuration
>>> configuration = OmDetTurboConfig()

>>> # Initializing a model (with random weights) from the omlab/omdet-turbo-swin-tiny-hf style configuration
>>> model = OmDetTurboForObjectDetection(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
OmDetTurboProcessor
clase transformers.OmDetTurboProcessor
< source >( image_processortokenizer )
Construye un OmDetTurboProcessor que envuelve un procesador de imágenes y un tokenizador en un único procesador.
OmDetTurboProcessor ofrece todas las funcionalidades de DetrImageProcessor y CLIPTokenizer. Consulte ~DetrImageProcessor y ~CLIPTokenizer para obtener más información.
__call__
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: list[str] | list[list[str]] | None = None**kwargs: *<class 'transformers.models.omdet_turbo.processing_omdet_turbo.OmDetTurboProcessorKwargs'> ) → ~feature_extraction_utils.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]], opcional) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - text (
Union[list[str], list[list[str]]], opcional) — La secuencia o lote de secuencias que se van a codificar. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas de caracteres (cadenas pretokenizadas). Si se pasa una entrada pretokenizada, establezcais_split_into_words=Truepara evitar ambigüedad con las entradas por lotes. - task (
str, kwargs,list[str],TextInputoPreTokenizedInput, opcional) — La descripción de la tarea de detección a codificar. Si no se proporciona, se genera una descripción de tarea predeterminada a partir de la entradatext(p. ej., “Detect {text}.”). Puede ser una sola cadena, una lista de cadenas (una por imagen) o una entrada pretokenizada. La descripción de la tarea guía al modelo sobre qué objetos detectar en las imágenes. - return_tensors (
stro TensorType, opcional) — Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son:'pt': Devuelve objetostorch.Tensorde PyTorch.'np': Devuelve objetosnp.ndarrayde NumPy.
- **kwargs (ProcessingKwargs, opcional) — Opciones de procesamiento adicionales para cada modalidad (texto, imágenes, videos, audio). Los parámetros específicos del modelo se enumeran arriba; consulte la clase TypedDict para obtener la lista completa de argumentos admitidos.
Devuelve
~feature_extraction_utils.BatchFeature
- data (
dict, opcional) — Diccionario de listas/arrays/tensores devueltos por los métodos call/pad (‘input_values’, ‘attention_mask’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización. - skip_tensor_conversion (
list[str]oset[str], opcional) — Lista o conjunto de claves que NO deben convertirse en tensores, incluso cuando se especificatensor_type.
post_process_grounded_object_detection
< source >( outputs: OmDetTurboObjectDetectionOutputtext_labels: list[str] | list[list[str]] | None = Nonethreshold: float = 0.3nms_threshold: float = 0.5target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = Nonemax_num_det: int | None = None ) → list[Dict]
Parámetros
- outputs (
OmDetTurboObjectDetectionOutput) — Salidas crudas del modelo. - text_labels (Union[list[str], list[list[str]]], opcional) —
Los nombres de las clases de entrada. Si no se proporciona,
text_labelsse establecerá enNoneenoutputs. - threshold (float, valor predeterminado 0.3) — Solo devuelve detecciones con una puntuación de confianza que supere este umbral.
- nms_threshold (float, valor predeterminado 0.5) — Umbral a utilizar para la supresión de no máximos de las cajas. Valor en [0, 1].
- target_sizes (
torch.Tensorolist[tuple[int, int]], opcional) — Tensor de forma(batch_size, 2)o lista de tuplas (tuple[int, int]) que contiene el tamaño objetivo(height, width)de cada imagen del lote. Si no se establece, las predicciones no se redimensionarán. - max_num_det (
int, opcional) — El número máximo de detecciones a devolver.
Devuelve
list[Dict]
Una lista de diccionarios, donde cada diccionario contiene las puntuaciones, clases y cajas para una imagen del lote, tal como las predice el modelo.
Convierte la salida cruda de OmDetTurboForObjectDetection en cajas delimitadoras finales en el formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y) y obtiene la clase de texto asociada.
OmDetTurboForObjectDetection
clase transformers.OmDetTurboForObjectDetection
< source >( config: OmDetTurboConfig )
Parámetros
- config (OmDetTurboConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El modelo OmDetTurbo (que consta de un backbone de visión y un backbone de texto, y de una arquitectura encoder-decoder) genera bounding boxes y puntuaciones de clases para tareas como la detección COCO.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: Tensorclasses_input_ids: LongTensorclasses_attention_mask: LongTensortasks_input_ids: LongTensortasks_attention_mask: LongTensorclasses_structure: LongTensorlabels: typing.Optional[torch.LongTensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OmDetTurboObjectDetectionOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando DetrImageProcessor. Consulte DetrImageProcessor.call() para más detalles (OmDetTurboProcessor utiliza DetrImageProcessor para procesar las imágenes). - classes_input_ids (
torch.LongTensorde forma(total_classes (>= batch_size), sequence_length)) — Índices de los tokens de la secuencia de clases de entrada en el vocabulario del modelo de lenguaje. Se pueden proporcionar varias clases para cada tarea, por lo que las clases tokenizadas se aplanan y la estructura de las clases se proporciona en elclasses_structureargumento.Los índices se pueden obtener usando OmDetTurboProcessor. Consulte OmDetTurboProcessor.call() para obtener más detalles.
- classes_attention_mask (
torch.BoolTensorde forma(total_classes (>= batch_size), num_classes, sequence_length)) — Máscara de atención para las clases. Esta es una máscara binaria que indica qué tokens deben ser atendidos y cuáles no. - tasks_input_ids (
torch.LongTensorde forma(batch_size, sequence_length)) — Índices de los tokens de la secuencia de tareas de entrada en el vocabulario del modelo de lenguaje. Los índices se pueden obtener usando OmDetTurboProcessor. Consulte OmDetTurboProcessor.call() para más detalles. ¿Qué son los IDs de entrada?Los índices se pueden obtener usando OmDetTurboProcessor. Consulte OmDetTurboProcessor.call() para obtener más detalles.
- tasks_attention_mask (
torch.BoolTensorde forma(batch_size, sequence_length)) — Máscara de atención para las tareas. Esta es una máscara binaria que indica qué tokens deben ser atendidos y cuáles no. - classes_structure (
torch.LongTensorde forma(batch_size)) — Estructura de las clases. Este tensor indica el número de clases para cada tarea. - labels (
list[Dict]de longitud(batch_size,), opcional) — Etiquetas para calcular la pérdida de bipartite matching. Lista de diccionarios, donde cada diccionario contiene al menos las siguientes 2 claves: ‘class_labels’ y ‘boxes’ (las etiquetas de clase y las cajas delimitadoras de una imagen del lote, respectivamente). Las etiquetas de clase en sí deben ser untorch.LongTensorde longitud(number of bounding boxes in the image,)y las cajas untorch.Tensorde forma(number of bounding boxes in the image, 4). - output_attentions (
bool, opcional) — Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulteattentionsen los tensores devueltos para obtener más detalles. - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple.
Devuelve
OmDetTurboObjectDetectionOutput o tuple(torch.Tensor)
Un OmDetTurboObjectDetectionOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (OmDetTurboConfig) y las entradas.
El método forward de OmDetTurboForObjectDetection sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
- loss (
torch.Tensor, opcional) — El valor de la pérdida. - decoder_coord_logits (
torch.Tensorde forma(batch_size, num_queries, 4)) — Los logits de coordenadas predichos de los objetos. - decoder_class_logits (
torch.Tensorde forma(batch_size, num_queries, num_classes)) — La clase predicha de los objetos. - init_reference_points (
torch.Tensorde forma(batch_size, num_queries, 4)) — Los puntos de referencia iniciales. - intermediate_reference_points (
tuple[tuple[torch.Tensor]], opcional) — Los puntos de referencia intermedios. - encoder_coord_logits (
torch.Tensorde forma(batch_size, num_queries, 4)) — Las coordenadas predichas de los objetos por el codificador. - encoder_class_logits (
tuple[torch.Tensor], opcional) — La clase predicha de los objetos por el codificador. - encoder_extracted_states (
torch.Tensor, opcional) — Los estados extraídos de la Feature Pyramid Network (FPN) y la Path Aggregation Network (PAN) del codificador. - decoder_hidden_states (
tuple[torch.Tensor], opcional) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos del modelo en la salida de cada capa más las salidas de los embeddings iniciales. - decoder_attentions (
tuple[tuple[torch.Tensor]], opcional) — Tupla de tuplas detorch.Tensor(una para la atención de cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención, atención cruzada y atención deformable multiescala. - encoder_hidden_states (
tuple[torch.Tensor], opcional) — Tupla detorch.Tensor(una para la salida de las incrustaciones + una para la salida de cada capa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos del modelo en la salida de cada capa más las salidas de las incrustaciones iniciales. - encoder_attentions (
tuple[tuple[torch.Tensor]], opcional) — Tupla de tuplas detorch.Tensor(una para la atención de cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de atención después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención, atención cruzada y atención deformable multiescala. - classes_structure (
torch.LongTensor, opcional) — El número de clases consultadas para cada imagen.
Ejemplos:
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image

>>> from transformers import AutoProcessor, OmDetTurboForObjectDetection

>>> processor = AutoProcessor.from_pretrained("omlab/omdet-turbo-swin-tiny-hf")
>>> model = OmDetTurboForObjectDetection.from_pretrained("omlab/omdet-turbo-swin-tiny-hf")

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))
>>> classes = ["cat", "remote"]
>>> task = "Detect {}.".format(", ".join(classes))
>>> inputs = processor(image, text=classes, task=task, return_tensors="pt")

>>> outputs = model(**inputs)

>>> # convert outputs (bounding boxes and class logits)
>>> results = processor.post_process_grounded_object_detection(
...     outputs,
...     classes=classes,
...     target_sizes=[image.size[::-1]],
...     score_threshold=0.3,
...     nms_threshold=0.3,
>>> )[0]
>>> for score, class_name, box in zip(results["scores"], results["classes"], results["boxes"]):
...     box = [round(i, 1) for i in box.tolist()]
...     print(
...         f"Detected {class_name} with confidence "
...         f"{round(score.item(), 2)} at location {box}"
...     )
Detected remote with confidence 0.76 at location [39.9, 71.3, 176.5, 117.9]
Detected cat with confidence 0.72 at location [345.1, 22.5, 639.7, 371.9]
Detected cat with confidence 0.65 at location [12.7, 53.8, 315.5, 475.3]
Detected remote with confidence 0.57 at location [333.4, 75.6, 370.7, 187.0]