
Transformers documentation
OneFormer
Este modelo se publicó en HF papers el 2022-11-10 y se contribuyó a Hugging Face Transformers el 2023-01-19.
OneFormer
Resumen
El modelo OneFormer se propuso en OneFormer: One Transformer to Rule Universal Image Segmentation de Jitesh Jain, Jiachen Li, MangTik Chiu, Ali Hassani, Nikita Orlov, Humphrey Shi. OneFormer es un marco universal de segmentación de imágenes que puede entrenarse en un único conjunto de datos panóptico para realizar tareas de segmentación semántica, de instancias y panóptica. OneFormer utiliza un token de tarea para condicionar el modelo en la tarea en cuestión, lo que hace que la arquitectura sea guiada por la tarea para el entrenamiento y dinámica según la tarea para la inferencia.
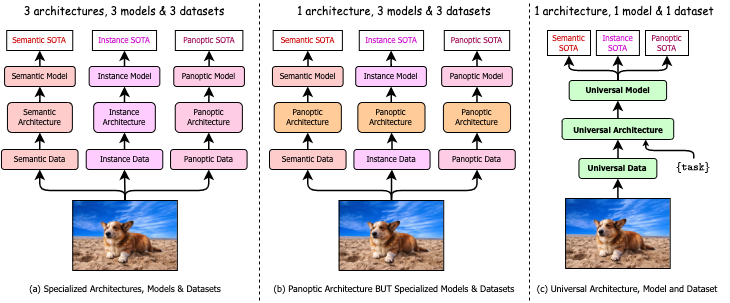
El resumen del artículo es el siguiente:
La segmentación universal de imágenes no es un concepto nuevo. Los intentos anteriores de unificar la segmentación de imágenes en las últimas décadas incluyen el análisis de escenas, la segmentación panóptica y, más recientemente, nuevas arquitecturas panópticas. Sin embargo, dichas arquitecturas panópticas no unifican realmente la segmentación de imágenes, ya que deben entrenarse individualmente en la segmentación semántica, de instancias o panóptica para lograr el mejor rendimiento. Idealmente, un marco verdaderamente universal debería entrenarse solo una vez y lograr un rendimiento SOTA en las tres tareas de segmentación de imágenes. Con ese fin, proponemos OneFormer, un marco universal de segmentación de imágenes que unifica la segmentación con un diseño multi-tarea de entrenamiento único. Primero, proponemos una estrategia de entrenamiento conjunto condicionada por la tarea que permite entrenar con las verdades de cada dominio (segmentación semántica, de instancias y panóptica) dentro de un único proceso de entrenamiento multi-tarea. En segundo lugar, introducimos un token de tarea para condicionar nuestro modelo en la tarea en cuestión, lo que hace que nuestro modelo sea dinámico en cuanto a la tarea para soportar el entrenamiento y la inferencia multi-tarea. En tercer lugar, proponemos utilizar una pérdida contrastiva de consulta-texto durante el entrenamiento para establecer mejores distinciones entre tareas y entre clases. Cabe destacar que nuestro único modelo OneFormer supera a los modelos especializados Mask2Former en las tres tareas de segmentación en ADE20k, CityScapes y COCO, a pesar de que estos últimos se entrenan individualmente en cada una de las tres tareas con tres veces más recursos. Con nuevas columnas ConvNeXt y DiNAT, observamos una mejora aún mayor del rendimiento. Creemos que OneFormer es un paso significativo hacia una segmentación de imágenes más universal y accesible.
La figura siguiente ilustra la arquitectura de OneFormer. Tomada del artículo original.
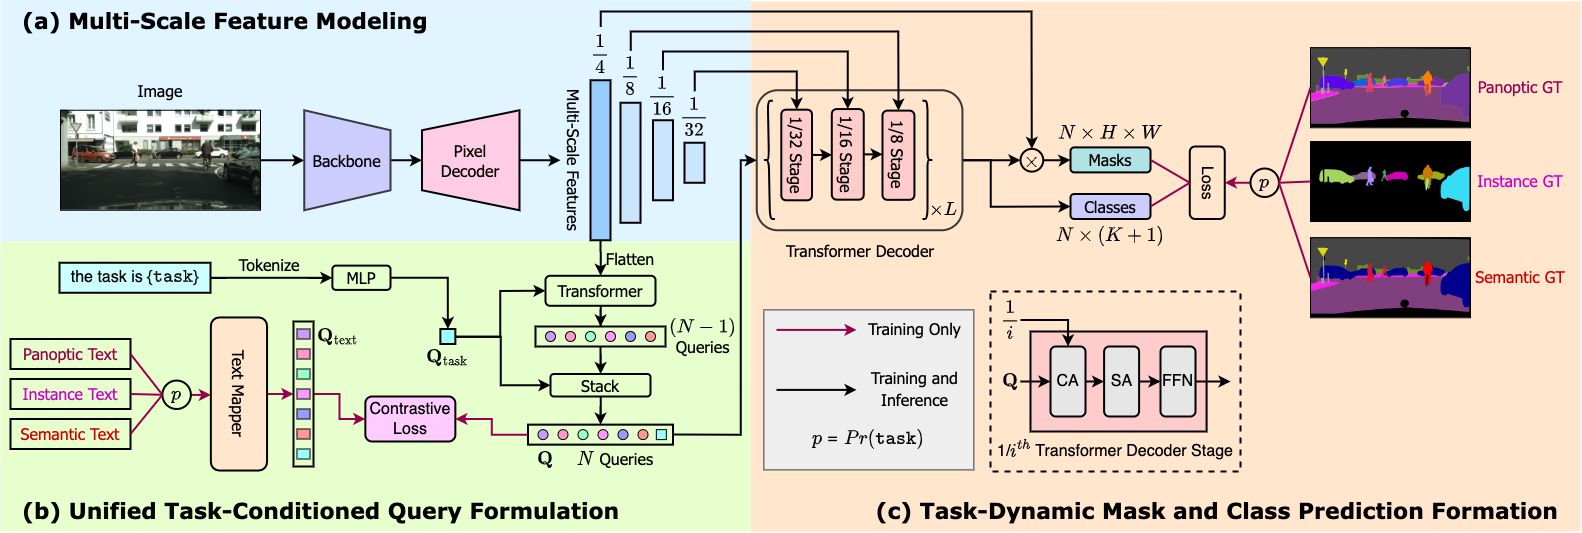
Este modelo fue aportado por Jitesh Jain. El código original se puede encontrar aquí.
Consejos de uso
- OneFormer requiere dos entradas durante la inferencia: image y task token.
- Durante el entrenamiento, OneFormer solo utiliza anotaciones panópticas.
- Si desea entrenar el modelo en un entorno distribuido en varios nodos, debe actualizar la función
get_num_masksdentro de la claseOneFormerLossdemodeling_oneformer.py. Al entrenar en varios nodos, este valor debe establecerse como el número promedio de máscaras objetivo en todos los nodos, como se puede ver en la implementación original aquí. - Se puede usar OneFormerProcessor para preparar las imágenes de entrada y las entradas de la tarea para el modelo, así como los objetivos opcionales para el modelo. OneFormerProcessor encapsula OneFormerImageProcessor y CLIPTokenizer en una única instancia para preparar las imágenes y codificar las entradas de la tarea.
- Para obtener la segmentación final, dependiendo de la tarea, puedes llamar a
post_process_semantic_segmentation()o post_process_instance_segmentation() o post_process_panoptic_segmentation(). Las tres tareas pueden resolverse utilizando la salida de OneFormerForUniversalSegmentation; la segmentación panóptica acepta un argumento opcionallabel_ids_to_fusepara fusionar las instancias del objeto u objetos objetivo (p. ej., el cielo).
Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con OneFormer.
- Los cuadernos de demostración sobre inferencia y ajuste fino con datos personalizados se encuentran aquí.
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Idealmente, el recurso debería demostrar algo nuevo en lugar de duplicar un recurso existente.
Salidas específicas de OneFormer
clase transformers.models.oneformer.modeling_oneformer.OneFormerModelOutput
< source >( encoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: tuple[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.Tensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_auxiliary_predictions: tuple[dict[str, torch.Tensor]] | None = Nonetext_queries: typing.Optional[torch.Tensor] = Nonetask_token: typing.Optional[torch.Tensor] = Noneattentions: tuple[torch.Tensor] | None = None )
Parámetros
- encoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo codificador en la salida de cada etapa. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo decodificador de píxeles en la salida de cada etapa. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos (también llamados mapas de características) del decodificador transformer en la salida de cada etapa. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de salida de la última capa del decodificador transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas del decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Predicciones de máscara de la última capa del decodificador transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Predicciones de clase de la última capa del decodificador transformer. - transformer_decoder_auxiliary_predictions (
Tuplede Dict destr, torch.Tensor, opcional) — Tupla de predicciones de clase y máscara de cada capa del decodificador transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas de la lista de texto de entrada, utilizadas para calcular la pérdida contrastiva durante el entrenamiento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarea 1D para condicionar las consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self y Cross Attentions del decodificador del transformer.
Clase para las salidas de OneFormerModel. Esta clase devuelve todos los estados ocultos necesarios para calcular los logits.
clase transformers.models.oneformer.modeling_oneformer.OneFormerForUniversalSegmentationOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneclass_queries_logits: typing.Optional[torch.Tensor] = Nonemasks_queries_logits: typing.Optional[torch.Tensor] = Noneauxiliary_predictions: list = Noneencoder_hidden_states: tuple[torch.Tensor] | None = Nonepixel_decoder_hidden_states: list[torch.Tensor] | None = Nonetransformer_decoder_hidden_states: typing.Optional[torch.Tensor] = Nonetransformer_decoder_object_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_contrastive_queries: typing.Optional[torch.Tensor] = Nonetransformer_decoder_mask_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_class_predictions: typing.Optional[torch.Tensor] = Nonetransformer_decoder_auxiliary_predictions: list[dict[str, torch.Tensor]] | None = Nonetext_queries: typing.Optional[torch.Tensor] = Nonetask_token: typing.Optional[torch.Tensor] = Noneattentions: tuple[tuple[torch.Tensor]] | None = None )
Parámetros
- loss (
torch.Tensor, opcional) — La pérdida calculada, devuelta cuando hay etiquetas presentes. - class_queries_logits (
torch.Tensor, opcional) — Un tensor de forma(batch_size, num_queries, num_labels + 1)que representa las clases propuestas para cada consulta. Tenga en cuenta que el+ 1es necesario porque incorporamos la clase nula. - masks_queries_logits (
torch.Tensor, opcional) — Un tensor de forma(batch_size, num_queries, height, width)que representa las máscaras propuestas para cada consulta. - auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista de predicciones de clase y máscara de cada capa del decodificador del transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo codificador en la salida de cada etapa. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo decodificador de píxeles en la salida de cada etapa. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos (también llamados mapas de características) del decodificador transformer en la salida de cada etapa. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de salida de la última capa del decodificador transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas del decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Predicciones de máscara de la última capa del decodificador transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Predicciones de clase de la última capa del decodificador transformer. - transformer_decoder_auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista de predicciones de clase y máscara de cada capa del decodificador transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas de la lista de texto de entrada, utilizadas para calcular la pérdida contrastiva durante el entrenamiento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarea 1D para condicionar las consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self y Cross Attentions del decodificador del transformer.
Clase para las salidas de OneFormerForUniversalSegmentationOutput.
Esta salida se puede pasar directamente a post_process_semantic_segmentation() o post_process_instance_segmentation() o post_process_panoptic_segmentation() según la tarea. Consulte [`~OneFormerImageProcessor] para obtener detalles sobre su uso.
OneFormerConfig
clase transformers.OneFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneignore_value: int = 255num_queries: int = 150no_object_weight: float = 0.1class_weight: float = 2.0mask_weight: float = 5.0dice_weight: float = 5.0contrastive_weight: float = 0.5contrastive_temperature: float = 0.07train_num_points: int = 12544oversample_ratio: float = 3.0importance_sample_ratio: float = 0.75init_std: float = 0.02init_xavier_std: float = 1.0layer_norm_eps: float = 1e-05is_training: bool = Falseuse_auxiliary_loss: bool = Trueoutput_auxiliary_logits: bool = Truestrides: list[int] | tuple[int, ...] = (4, 8, 16, 32)task_seq_len: int = 77text_encoder_width: int = 256text_encoder_context_length: int = 77text_encoder_num_layers: int = 6text_encoder_vocab_size: int = 49408text_encoder_proj_layers: int = 2text_encoder_n_ctx: int = 16conv_dim: int = 256mask_dim: int = 256hidden_dim: int = 256encoder_feedforward_dim: int = 1024norm: str = 'GN'encoder_layers: int = 6decoder_layers: int = 10use_task_norm: bool = Truenum_attention_heads: int = 8dropout: float | int = 0.1dim_feedforward: int = 2048pre_norm: bool = Falseenforce_input_proj: bool = Falsequery_dec_layers: int = 2common_stride: int = 4 )
Parámetros
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], opcional) — La configuración del modelo backbone. - ignore_value (
int, opcional, valor predeterminado 255) — Valores que se ignoran en la etiqueta GT al calcular la pérdida. - num_queries (
int, opcional, valor predeterminado 150) — Número de consultas de objetos. - no_object_weight (
float, opcional, valor predeterminado0.1) — Peso de clasificación relativo de la clase sin objeto en la pérdida de detección de objetos. - class_weight (
float, opcional, valor predeterminado2.0) — Peso relativo del error de clasificación en el coste de correspondencia húngara. - mask_weight (
float, opcional, valor predeterminado5.0) — Peso relativo de la pérdida focal en la pérdida de segmentación panóptica. - dice_weight (
float, opcional, valor predeterminado5.0) — Peso relativo de la pérdida dice en la pérdida de segmentación panóptica. - contrastive_weight (
float, opcional, valor predeterminado 0.5) — Peso para la pérdida contrastiva. - contrastive_temperature (
float, opcional, valor predeterminado 0.07) — Valor inicial para escalar los logits contrastivos. - train_num_points (
int, opcional, valor predeterminado 12544) — Número de puntos que se muestrean al calcular las pérdidas en las predicciones de máscara. - oversample_ratio (
float, opcional, valor predeterminado 3.0) — Proporción para decidir cuántos puntos sobremuestrear. - importance_sample_ratio (
float, opcional, valor predeterminado 0.75) — Proporción de puntos que se muestrean mediante muestreo de importancia. - init_std (
float, opcional, valor predeterminado0.02) — La desviación estándar del truncated_normal_initializer para inicializar todas las matrices de pesos. - init_xavier_std (
float, opcional, valor predeterminado1.0) — El factor de escala utilizado para la inicialización de Xavier de los pesos de la atención cruzada. - layer_norm_eps (
float, opcional, valor predeterminado1e-05) — El epsilon utilizado por las capas de normalización de capa. - is_training (
bool, opcional, valor predeterminadoFalse) — Si se ejecuta en modo de entrenamiento o de inferencia. - use_auxiliary_loss (
bool, opcional, valor predeterminadoTrue) — Si se calcula la pérdida utilizando predicciones intermedias del decodificador transformer. - output_auxiliary_logits (
bool, opcional, valor predeterminadoTrue) — Si se deben devolver las predicciones intermedias del decodificador transformer. - strides (
list, opcional, valor predeterminado[4, 8, 16, 32]) — Lista que contiene los strides para los mapas de características en el codificador. - task_seq_len (
int, opcional, valor predeterminado 77) — Longitud de la secuencia para tokenizar la entrada de lista de texto. - text_encoder_width (
int, opcional, valor predeterminado 256) — Tamaño oculto para el codificador de texto. - text_encoder_context_length (
int, opcional, valor predeterminado 77) — Longitud de la secuencia de entrada para el codificador de texto. - text_encoder_num_layers (
int, opcional, valor predeterminado 6) — Número de capas del transformer en el codificador de texto. - text_encoder_vocab_size (
int, opcional, valor predeterminado 49408) — Tamaño del vocabulario para el tokenizador. - text_encoder_proj_layers (
int, opcional, valor predeterminado 2) — Número de capas en el MLP para proyectar las consultas de texto. - text_encoder_n_ctx (
int, opcional, valor predeterminado 16) — Número de consultas de contexto de texto aprendibles. - conv_dim (
int, opcional, valor predeterminado 256) — Dimensión del mapa de características para mapear las salidas del backbone. - mask_dim (
int, opcional, valor predeterminado 256) — Dimensión para los mapas de características en el decodificador de píxeles. - hidden_dim (
int, opcional, valor predeterminado 256) — Dimensión de los estados ocultos en el decodificador transformer. - encoder_feedforward_dim (
int, opcional, valor predeterminado 1024) — Dimensión de la capa FFN en el decodificador de píxeles. - norm (
str, opcional, valor predeterminado"GN") — Tipo de normalización. - encoder_layers (
int, opcional, valor predeterminado6) — Número de capas ocultas en el codificador del Transformer. Usará el mismo valor quenum_layerssi no se establece. - decoder_layers (
int, opcional, valor predeterminado10) — Número de capas ocultas en el decodificador del Transformer. Si no se establece, se usará el mismo valor quenum_layers. - use_task_norm (
bool, opcional, valor predeterminadoTrue) — Si se debe normalizar el token de tarea. - num_attention_heads (
int, opcional, valor predeterminado8) — Número de cabezas de atención para cada capa de atención en el decodificador Transformer. - dropout (
Union[float, int], opcional, valor predeterminado0.1) — La proporción para todas las capas de dropout. - dim_feedforward (
int, opcional, valor predeterminado 2048) — Dimensión de la capa FFN en el decodificador del transformer. - pre_norm (
bool, opcional, valor predeterminadoFalse) — Si se normalizan los estados ocultos antes de las capas de atención en el decodificador de transformador. - enforce_input_proj (
bool, opcional, valor predeterminadoFalse) — Si se deben proyectar los estados ocultos en el decodificador de transformador. - query_dec_layers (
int, opcional, valor predeterminado 2) — Número de capas en el transformador de consulta. - common_stride (
int, opcional, valor predeterminado 4) — Paso común utilizado para las características en el decodificador de píxeles.
Esta es la clase de configuración para almacenar la configuración de un OneFormerModel. Se utiliza para instanciar un modelo Oneformer según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de shi-labs/oneformer_ade20k_swin_tiny
Los objetos de configuración heredan de PreTrainedConfig y se pueden usar para controlar las salidas del modelo. Lea la documentación de PreTrainedConfig para obtener más información.
Ejemplos:
>>> from transformers import OneFormerConfig, OneFormerModel

>>> # Initializing a OneFormer shi-labs/oneformer_ade20k_swin_tiny configuration
>>> configuration = OneFormerConfig()
>>> # Initializing a model (with random weights) from the shi-labs/oneformer_ade20k_swin_tiny style configuration
>>> model = OneFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
OneFormerImageProcessor
clase transformers.OneFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'shortest_edge' -- 800, 'longest_edge': 1333}): Describe las dimensiones de entrada máximas para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto2) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - repo_path (
str, kwargs, opcional, valor predeterminadoshi-labs/oneformer_demo) — Ruta a un directorio local o a un repositorio de HuggingFace Hub que contiene los metadatos del modelo. - class_info_file (
str, kwargs, opcional) — Ruta al archivo JSON dentro del repositorio que contiene los metadatos de la clase. - num_text (
int, kwargs, opcional) — Número de consultas de texto para el codificador de texto, utilizadas como indicaciones que guían la tarea. - num_labels (
int, kwargs, opcional) — Número de clases semánticas para la segmentación, que determina el tamaño de la capa de salida. - ignore_index (
int, kwargs, opcional) — Etiqueta a ignorar en los mapas de segmentación, a menudo utilizada para el relleno. - do_reduce_labels (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe restar 1 a todos los valores de las etiquetas, mapeando la clase de fondo aignore_index.
Construye un procesador de imágenes OneFormerImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - task_inputs (
list[str], opcional) — Lista de tareas ("panoptic","instance","semantic") para cada imagen del lote. - segmentation_maps (
ImageInput, opcional) — Los mapas de segmentación. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Un mapeo de IDs de instancia a IDs semánticos. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - repo_path (
str, kwargs, opcional, valor predeterminadoshi-labs/oneformer_demo) — Ruta a un directorio local o a un repositorio de HuggingFace Hub que contiene los metadatos del modelo. - class_info_file (
str, kwargs, opcional) — Ruta al archivo JSON dentro del repositorio que contiene los metadatos de la clase. - num_text (
int, kwargs, opcional) — Número de consultas de texto para el codificador de texto, utilizadas como indicaciones que guían la tarea. - num_labels (
int, kwargs, opcional) — Número de clases semánticas para la segmentación, que determina el tamaño de la capa de salida. - ignore_index (
int, kwargs, opcional) — Etiqueta a ignorar en los mapas de segmentación, a menudo utilizada para el relleno. - do_reduce_labels (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe restar 1 a todos los valores de las etiquetas, mapeando la clase de fondo aignore_index.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parámetros
- outputs (OneFormerForUniversalSegmentation) — Salidas sin procesar del modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (Tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción. Si se deja en None, las predicciones no se redimensionarán. - return_segmentation_scores (
bool, opcional, valor predeterminadoFalse) — Indica si se deben devolver las puntuaciones de segmentación junto con el mapa de segmentación. CuandoTrue, cada elemento de la lista devuelta es unSemanticSegmentationPostProcessorOutputcon los campossegmentation(IDs de clase, forma(height, width)) ysegmentation_scores(forma(num_classes, height, width)).
Devuelve
list[torch.Tensor] o list[SemanticSegmentationPostProcessorOutput]
Cuando
return_segmentation_scores=False (por defecto), se devuelve una lista de longitud batch_size donde cada elemento es un
mapa de segmentación de forma (height, width) con IDs de clase. Cuando return_segmentation_scores=True,
se devuelve una lista de SemanticSegmentationPostProcessorOutput con los campos segmentation (IDs de clase, forma
(height, width)) y segmentation_scores (forma (num_classes, height, width)). En ambos casos,
(height, width) corresponde al tamaño objetivo (si se especifica target_sizes).
Convierte la salida de OneFormerForUniversalSegmentation en mapas de segmentación semántica. Solo admite PyTorch.
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
Parámetros
- outputs (
OneFormerForUniversalSegmentationOutput) — Las salidas deOneFormerForUniversalSegmentationOutput. - task_type (
str, opcional, valor predeterminado “instance”) — El posprocesado depende del token de tarea de entrada. Sitask_typees “panoptic”, debemos ignorar las predicciones de stuff. - is_demo (
bool, opcional, valor predeterminadoTrue) — Indica si el modelo está en modo de demostración. Si es verdadero, se utiliza el umbral para predecir las máscaras finales. - threshold (
float, opcional, valor predeterminado 0.5) — Umbral de puntuación de probabilidad para conservar las máscaras de instancias predichas. - mask_threshold (
float, opcional, valor predeterminado 0.5) — Umbral a utilizar al convertir las máscaras predichas en valores binarios. - overlap_mask_area_threshold (
float, opcional, valor predeterminado 0.8) — Umbral del área de la máscara de solapamiento para fusionar o descartar pequeñas partes desconectadas dentro de cada máscara binaria de instancia. - target_sizes (
List[Tuple], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (Tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción del lote. Si se deja en None, las predicciones no se redimensionarán. - return_coco_annotation (
bool, opcional, valor predeterminadoFalse) — Si se deben devolver las predicciones en formato COCO.
Devuelve
List[Dict]
Una lista de diccionarios, uno por imagen, donde cada diccionario contiene dos claves:
- segmentation — un tensor de forma
(height, width)donde cada píxel representa unsegment_id, establecido enNonesi no se encuentra ninguna máscara por encima dethreshold. Si se especificatarget_sizes, la segmentación se redimensiona a la entrada correspondiente detarget_sizes. - segments_info — Un diccionario que contiene información adicional sobre cada segmento.
- id — un entero que representa el
segment_id. - label_id — Un entero que representa el identificador de etiqueta/clase semántica correspondiente a
segment_id. - was_fused — un booleano,
Truesilabel_idestaba enlabel_ids_to_fuse,Falseen caso contrario. Se fusionaron varias instancias de la misma clase / etiqueta y se les asignó un únicosegment_id. - score — Puntuación de predicción del segmento con
segment_id.
- id — un entero que representa el
Convierte la salida de OneFormerForUniversalSegmentationOutput en predicciones de segmentación de instancias de imagen. Solo admite PyTorch.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parámetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — Las salidas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, valor predeterminado 0.5) — Umbral de puntuación de probabilidad para conservar las máscaras de instancias predichas. - mask_threshold (
float, opcional, valor predeterminado 0.5) — Umbral a utilizar al convertir las máscaras predichas en valores binarios. - overlap_mask_area_threshold (
float, opcional, valor predeterminado 0.8) — Umbral del área de la máscara de solapamiento para fusionar o descartar pequeñas partes desconectadas dentro de cada máscara binaria de instancia. - label_ids_to_fuse (
Set[int], opcional) — Las etiquetas en este estado fusionarán todas sus instancias. Por ejemplo, podríamos decir que solo puede haber un cielo en una imagen, pero varias personas, por lo que el ID de etiqueta para cielo estaría en ese conjunto, pero no el de persona. - target_sizes (
list[Tuple], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción del lote. Si se deja en None, las predicciones no se redimensionarán.
Devuelve
list[Dict]
Una lista de diccionarios, uno por imagen, donde cada diccionario contiene dos claves:
- segmentation — un tensor de forma
(height, width)donde cada píxel representa unsegment_id, establecido enNonesi no se encuentra ninguna máscara por encima dethreshold. Si se especificatarget_sizes, la segmentación se redimensiona a la entrada correspondiente detarget_sizes. - segments_info — Un diccionario que contiene información adicional sobre cada segmento.
- id — un entero que representa el
segment_id. - label_id — Un entero que representa el identificador de etiqueta/clase semántica correspondiente a
segment_id. - was_fused — un booleano,
Truesilabel_idestaba enlabel_ids_to_fuse,Falseen caso contrario. Se fusionaron varias instancias de la misma clase / etiqueta y se les asignó un únicosegment_id. - score — Puntuación de predicción del segmento con
segment_id.
- id — un entero que representa el
Convierte la salida de MaskFormerForInstanceSegmentationOutput en predicciones de segmentación panóptica de imagen. Solo admite PyTorch.
OneFormerImageProcessorPil
clase transformers.OneFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> )
Parámetros
- do_convert_rgb (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, por defecto{'shortest_edge' -- 800, 'longest_edge': 1333}): Describe las dimensiones de entrada máximas para el modelo. - default_to_square (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, por defecto2) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeraciónPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional, valor predeterminado0.00392156862745098) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional, valor predeterminadoTrue) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.485, 0.456, 0.406]) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional, valor predeterminado[0.229, 0.224, 0.225]) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - repo_path (
str, kwargs, opcional, valor predeterminadoshi-labs/oneformer_demo) — Ruta a un directorio local o a un repositorio de HuggingFace Hub que contiene los metadatos del modelo. - class_info_file (
str, kwargs, opcional) — Ruta al archivo JSON dentro del repositorio que contiene los metadatos de la clase. - num_text (
int, kwargs, opcional) — Número de consultas de texto para el codificador de texto, utilizadas como indicaciones que guían la tarea. - num_labels (
int, kwargs, opcional) — Número de clases semánticas para la segmentación, que determina el tamaño de la capa de salida. - ignore_index (
int, kwargs, opcional) — Etiqueta a ignorar en los mapas de segmentación, a menudo utilizada para el relleno. - do_reduce_labels (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe restar 1 a todos los valores de las etiquetas, mapeando la clase de fondo aignore_index.
Construye un procesador de imágenes OneFormerImageProcessor.
preprocesar
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]task_inputs: list[str] | None = Nonesegmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = Noneinstance_id_to_semantic_id: list[dict[int, int]] | dict[int, int] | None = None**kwargs: *<class 'transformers.models.oneformer.image_processing_pil_oneformer.OneFormerImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Parámetros
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezcado_rescale=False. - task_inputs (
list[str], opcional) — Lista de tareas ("panoptic","instance","semantic") para cada imagen del lote. - segmentation_maps (
ImageInput, opcional) — Los mapas de segmentación. - instance_id_to_semantic_id (
Union[list[dict[int, int]], dict[int, int]], opcional) — Un mapeo de IDs de instancia a IDs semánticos. - do_convert_rgb (
bool, kwargs, opcional) — Si se debe convertir la imagen a RGB. - do_resize (
bool, kwargs, opcional) — Si se debe redimensionar la imagen. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Describe las dimensiones de entrada máximas del modelo. - default_to_square (
bool, kwargs, opcional) — Si se debe usar una imagen cuadrada por defecto al redimensionar, si size es un int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Tamaño de la imagen de salida tras aplicarcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los enumPILImageResampling. Solo tiene efecto sido_resizeestá establecido enTrue. - do_rescale (
bool, kwargs, opcional) — Si se debe reescalar la imagen. - rescale_factor (
float, kwargs, opcional) — Factor de reescalado para reescalar la imagen sido_rescaleestá establecido enTrue. - do_normalize (
bool, kwargs, opcional) — Si se debe normalizar la imagen. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Media de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opcional) — Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto sido_normalizeestá establecido enTrue. - do_pad (
bool, kwargs, opcional) — Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — El tamaño en{"height": int, "width" int}al que se rellenan las imágenes. Debe ser mayor que cualquier tamaño de imagen proporcionado para el preprocesamiento. Si no se proporcionapad_size, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuandodo_pad=True. - do_center_crop (
bool, kwargs, opcional) — Si se debe recortar la imagen centrada. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — Solo se admiteChannelDimension.FIRST. Se añadió para garantizar la compatibilidad con los procesadores lentos. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, opcional) — El formato de la dimensión de canales para la imagen de entrada. Si no se establece, el formato de la dimensión de canales se infiere a partir de la imagen de entrada. Puede ser uno de:"channels_first"oChannelDimension.FIRST: imagen en formato (num_channels, height, width)."channels_last"oChannelDimension.LAST: imagen en formato (altura, ancho, num_canales)."none"oChannelDimension.NONE: imagen en formato (altura, ancho).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — El dispositivo en el que se procesarán los videos. Si no se establece, el dispositivo se infiere a partir de los videos de entrada. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Devuelve tensores apilados si se establece en'pt'; en caso contrario, devuelve una lista de tensores. - disable_grouping (
bool, kwargs, opcional) — Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, opcional) — El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Añadido por compatibilidad con versiones anteriores, pero en futuros modelos debería establecerse como un atributo del procesador. - repo_path (
str, kwargs, opcional, valor predeterminadoshi-labs/oneformer_demo) — Ruta a un directorio local o a un repositorio de HuggingFace Hub que contiene los metadatos del modelo. - class_info_file (
str, kwargs, opcional) — Ruta al archivo JSON dentro del repositorio que contiene los metadatos de la clase. - num_text (
int, kwargs, opcional) — Número de consultas de texto para el codificador de texto, utilizadas como indicaciones que guían la tarea. - num_labels (
int, kwargs, opcional) — Número de clases semánticas para la segmentación, que determina el tamaño de la capa de salida. - ignore_index (
int, kwargs, opcional) — Etiqueta a ignorar en los mapas de segmentación, a menudo utilizada para el relleno. - do_reduce_labels (
bool, kwargs, opcional, valor predeterminadoFalse) — Si se debe restar 1 a todos los valores de las etiquetas, mapeando la clase de fondo aignore_index.
Devuelve
~image_processing_base.BatchFeature
- data (
dict) — Diccionario de listas/arrays/tensores devueltos por el método call (‘pixel_values’, etc.). - tensor_type (
Union[None, str, TensorType], opcional) — Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
post_process_semantic_segmentation
< source >( outputstarget_sizes: list[tuple[int, int]] | None = Nonereturn_segmentation_scores: bool = False ) → list[torch.Tensor] or list[SemanticSegmentationPostProcessorOutput]
Parámetros
- outputs (OneFormerForUniversalSegmentation) — Salidas sin procesar del modelo.
- target_sizes (
list[tuple[int, int]], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (Tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción. Si se deja en None, las predicciones no se redimensionarán. - return_segmentation_scores (
bool, opcional, valor predeterminadoFalse) — Indica si se deben devolver las puntuaciones de segmentación junto con el mapa de segmentación. CuandoTrue, cada elemento de la lista devuelta es unSemanticSegmentationPostProcessorOutputcon los campossegmentation(IDs de clase, forma(height, width)) ysegmentation_scores(forma(num_classes, height, width)).
Devuelve
list[torch.Tensor] o list[SemanticSegmentationPostProcessorOutput]
Cuando
return_segmentation_scores=False (por defecto), se devuelve una lista de longitud batch_size donde cada elemento es un
mapa de segmentación de forma (height, width) con IDs de clase. Cuando return_segmentation_scores=True,
se devuelve una lista de SemanticSegmentationPostProcessorOutput con los campos segmentation (IDs de clase, forma
(height, width)) y segmentation_scores (forma (num_classes, height, width)). En ambos casos,
(height, width) corresponde al tamaño objetivo (si se especifica target_sizes).
Convierte la salida de OneFormerForUniversalSegmentation en mapas de segmentación semántica. Solo admite PyTorch.
post_process_instance_segmentation
< source >( outputstask_type: str = 'instance'is_demo: bool = Truethreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8target_sizes: list[tuple[int, int]] | None = Nonereturn_coco_annotation: bool | None = False ) → List[Dict]
Parámetros
- outputs (
OneFormerForUniversalSegmentationOutput) — Las salidas deOneFormerForUniversalSegmentationOutput. - task_type (
str, opcional, valor predeterminado “instance”) — El posprocesado depende del token de tarea de entrada. Sitask_typees “panoptic”, debemos ignorar las predicciones de stuff. - is_demo (
bool, opcional, valor predeterminadoTrue) — Indica si el modelo está en modo de demostración. Si es verdadero, se utiliza el umbral para predecir las máscaras finales. - threshold (
float, opcional, valor predeterminado 0.5) — Umbral de puntuación de probabilidad para conservar las máscaras de instancias predichas. - mask_threshold (
float, opcional, valor predeterminado 0.5) — Umbral a utilizar al convertir las máscaras predichas en valores binarios. - overlap_mask_area_threshold (
float, opcional, valor predeterminado 0.8) — Umbral del área de la máscara de solapamiento para fusionar o descartar pequeñas partes desconectadas dentro de cada máscara binaria de instancia. - target_sizes (
List[Tuple], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (Tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción del lote. Si se deja en None, las predicciones no se redimensionarán. - return_coco_annotation (
bool, opcional, valor predeterminadoFalse) — Si se deben devolver las predicciones en formato COCO.
Devuelve
List[Dict]
Una lista de diccionarios, uno por imagen, donde cada diccionario contiene dos claves:
- segmentation — un tensor de forma
(height, width)donde cada píxel representa unsegment_id, establecido enNonesi no se encuentra ninguna máscara por encima dethreshold. Si se especificatarget_sizes, la segmentación se redimensiona a la entrada correspondiente detarget_sizes. - segments_info — Un diccionario que contiene información adicional sobre cada segmento.
- id — un entero que representa el
segment_id. - label_id — Un entero que representa el identificador de etiqueta/clase semántica correspondiente a
segment_id. - was_fused — un booleano,
Truesilabel_idestaba enlabel_ids_to_fuse,Falseen caso contrario. Se fusionaron varias instancias de la misma clase / etiqueta y se les asignó un únicosegment_id. - score — Puntuación de predicción del segmento con
segment_id.
- id — un entero que representa el
Convierte la salida de OneFormerForUniversalSegmentationOutput en predicciones de segmentación de instancias de imagen. Solo admite PyTorch.
post_process_panoptic_segmentation
< source >( outputsthreshold: float = 0.5mask_threshold: float = 0.5overlap_mask_area_threshold: float = 0.8label_ids_to_fuse: set[int] | None = Nonetarget_sizes: list[tuple[int, int]] | None = None ) → list[Dict]
Parámetros
- outputs (
MaskFormerForInstanceSegmentationOutput) — Las salidas de MaskFormerForInstanceSegmentation. - threshold (
float, opcional, valor predeterminado 0.5) — Umbral de puntuación de probabilidad para conservar las máscaras de instancias predichas. - mask_threshold (
float, opcional, valor predeterminado 0.5) — Umbral a utilizar al convertir las máscaras predichas en valores binarios. - overlap_mask_area_threshold (
float, opcional, valor predeterminado 0.8) — Umbral del área de la máscara de solapamiento para fusionar o descartar pequeñas partes desconectadas dentro de cada máscara binaria de instancia. - label_ids_to_fuse (
Set[int], opcional) — Las etiquetas en este estado fusionarán todas sus instancias. Por ejemplo, podríamos decir que solo puede haber un cielo en una imagen, pero varias personas, por lo que el ID de etiqueta para cielo estaría en ese conjunto, pero no el de persona. - target_sizes (
list[Tuple], opcional) — Lista de longitud (batch_size), donde cada elemento de la lista (tuple[int, int]]) corresponde al tamaño final solicitado (altura, ancho) de cada predicción del lote. Si se deja en None, las predicciones no se redimensionarán.
Devuelve
list[Dict]
Una lista de diccionarios, uno por imagen, donde cada diccionario contiene dos claves:
- segmentation — un tensor de forma
(height, width)donde cada píxel representa unsegment_id, establecido enNonesi no se encuentra ninguna máscara por encima dethreshold. Si se especificatarget_sizes, la segmentación se redimensiona a la entrada correspondiente detarget_sizes. - segments_info — Un diccionario que contiene información adicional sobre cada segmento.
- id — un entero que representa el
segment_id. - label_id — Un entero que representa el identificador de etiqueta/clase semántica correspondiente a
segment_id. - was_fused — un booleano,
Truesilabel_idestaba enlabel_ids_to_fuse,Falseen caso contrario. Se fusionaron varias instancias de la misma clase / etiqueta y se les asignó un únicosegment_id. - score — Puntuación de predicción del segmento con
segment_id.
- id — un entero que representa el
Convierte la salida de MaskFormerForInstanceSegmentationOutput en predicciones de segmentación panóptica de imagen. Solo admite PyTorch.
OneFormerProcessor
clase transformers.OneFormerProcessor
< source >( image_processor = Nonetokenizer = Nonemax_seq_length: int = 77task_seq_length: int = 77**kwargs )
Parámetros
- image_processor (
OneFormerImageProcessor) — El procesador de imágenes es una entrada obligatoria. - tokenizer (
CLIPTokenizer) — El tokenizador es una entrada obligatoria. - max_seq_length (
int, opcional, valor predeterminado77) — Longitud máxima de la secuencia para codificar nombres de clases y entradas de texto. Este parámetro controla el número máximo de tokens utilizados al tokenizar nombres de clases y otras entradas de texto para el modelo. - task_seq_length (
int, opcional, valor predeterminado77) — Longitud máxima de secuencia específica para codificar descripciones de tareas. Las descripciones de tareas (p. ej., “the task is semantic”) se tokenizan con este límite de longitud, que puede diferir de la longitud de secuencia general del texto.
Construye un OneFormerProcessor que envuelve un procesador de imágenes y un tokenizador en un único procesador.
OneFormerProcessor ofrece todas las funcionalidades de OneFormerImageProcessor y CLIPTokenizer. Consulte ~OneFormerImageProcessor y ~CLIPTokenizer para obtener más información.
__call__
< source >( images = Nonetask_inputs = Nonesegmentation_maps = None**kwargs ) → BatchFeature
Parámetros
- images (`
) -- Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, setdo_rescale=False`. - task_inputs (
strolist[str], obligatorio) — El tipo o tipos de tarea para la segmentación. Debe ser uno o más de"semantic","instance"o"panoptic". Puede ser una sola cadena de caracteres para una sola imagen, o una lista de cadenas de caracteres (una por imagen) para el procesamiento por lotes. El tipo de tarea determina qué tipo de segmentación realizará el modelo en las imágenes de entrada. - segmentation_maps (
ImageInput, opcional) — Los mapas de segmentación semántica correspondientes con las anotaciones a nivel de píxel.(
bool, opcional, valor predeterminadoTrue): Indica si se deben rellenar las imágenes hasta el tamaño de la imagen más grande del lote y crear una máscara de píxeles.Si se deja en el valor predeterminado, devolverá una máscara de píxeles que es:
- 1 para los píxeles reales (es decir, no enmascarados),
- 0 para los píxeles que son relleno (es decir, mascarados).
- return_tensors (
stro TensorType, opcional) — Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son:'pt': Devuelve objetostorch.Tensorde PyTorch.'np': Devuelve objetosnp.ndarrayde NumPy.
Devuelve
Un BatchFeature con los siguientes campos:
- task_inputs — Lista de ids de tokens que se enviarán a un modelo. Se devuelve cuando
textno esNone. - pixel_values — Valores de píxeles que se enviarán a un modelo. Se devuelve cuando
imagesno esNone.
OneFormerModel
clase transformers.OneFormerModel
< source >( config: OneFormerConfig )
Parámetros
- config (OneFormerConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
El modelo Oneformer básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerModelOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando OneFormerImageProcessor. Consulte OneFormerImageProcessor.call() para más detalles (OneFormerProcessor utiliza OneFormerImageProcessor para procesar las imágenes). - task_inputs (
torch.Tensorde forma(batch_size, sequence_length)) — Entradas de la tarea. Las entradas de la tarea se pueden obtener usando AutoImageProcessor. Consulte OneFormerProcessor.call() para más detalles. - text_inputs (
list[torch.Tensor], opcional) — Tensor de forma(num_queries, sequence_length)para alimentar a un modelo - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en[0, 1]:- 1 para los píxeles reales (es decir, no enmascarados),
- 0 para los píxeles que son relleno (es decir, mascarados).
- output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles. - output_attentions (
bool, opcional) — Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulteattentionsen los tensores devueltos para obtener más detalles. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple.
Devuelve
OneFormerModelOutput o tuple(torch.Tensor)
Un OneFormerModelOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (OneFormerConfig) y las entradas.
El método forward de OneFormerModel sobrescribe el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
- encoder_hidden_states (
tuple(torch.Tensor), opcional, devuelto cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo codificador en la salida de cada etapa. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo decodificador de píxeles en la salida de cada etapa. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos (también llamados mapas de características) del decodificador transformer en la salida de cada etapa. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de salida de la última capa del decodificador transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas del decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Predicciones de máscaras de la última capa del decodificador transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Predicciones de clase de la última capa del decodificador transformer. - transformer_decoder_auxiliary_predictions (
Tuplede Dict destr, torch.Tensor, opcional) — Tupla de predicciones de clase y máscara de cada capa del decodificador transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas de la lista de texto de entrada, utilizadas para calcular la pérdida contrastiva durante el entrenamiento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarea 1D para condicionar las consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self y Cross Attentions del decodificador del transformer.
Ejemplo:
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import OneFormerProcessor, OneFormerModel

>>> # download test image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # load processor for preprocessing the inputs
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerModel.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)

>>> mask_predictions = outputs.transformer_decoder_mask_predictions
>>> class_predictions = outputs.transformer_decoder_class_predictions

>>> f"👉 Mask Predictions Shape: {list(mask_predictions.shape)}, Class Predictions Shape: {list(class_predictions.shape)}"
'👉 Mask Predictions Shape: [1, 150, 128, 171], Class Predictions Shape: [1, 150, 151]'
OneFormerForUniversalSegmentation
clase transformers.OneFormerForUniversalSegmentation
< source >( config: OneFormerConfig )
Parámetros
- config (OneFormerConfig) — Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método from_pretrained() para cargar los pesos del modelo.
Modelo OneFormer para segmentación de imágenes instanciada, semántica y panóptica.
Este modelo hereda de PreTrainedModel. Consulta la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de torch.nn.Module de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
forward
< source >( pixel_values: Tensortask_inputs: Tensortext_inputs: typing.Optional[torch.Tensor] = Nonemask_labels: list[torch.Tensor] | None = Noneclass_labels: list[torch.Tensor] | None = Nonepixel_mask: typing.Optional[torch.Tensor] = Noneoutput_auxiliary_logits: bool | None = Noneoutput_hidden_states: bool | None = Noneoutput_attentions: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → OneFormerForUniversalSegmentationOutput or tuple(torch.Tensor)
Parámetros
- pixel_values (
torch.Tensorde forma(batch_size, num_channels, image_size, image_size)) — Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener utilizando OneFormerImageProcessor. Consulte OneFormerImageProcessor.call() para más detalles (OneFormerProcessor utiliza OneFormerImageProcessor para procesar las imágenes). - task_inputs (
torch.Tensorde forma(batch_size, sequence_length)) — Entradas de la tarea. Las entradas de la tarea se pueden obtener usando AutoImageProcessor. Consulte OneFormerProcessor.call() para más detalles. - text_inputs (
list[torch.Tensor], opcional) — Tensor de forma(num_queries, sequence_length)para alimentar a un modelo - mask_labels (
list[torch.Tensor], opcional) — Lista de etiquetas de máscara de forma(num_labels, height, width)para alimentar a un modelo - class_labels (
list[torch.LongTensor], opcional) — lista de etiquetas de clase objetivo de forma(num_labels, height, width)para alimentar a un modelo. Identifican las etiquetas demask_labels, p. ej. la etiqueta demask_labels[i][j]siclass_labels[i][j]. - pixel_mask (
torch.Tensorde forma(batch_size, height, width), opcional) — Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en[0, 1]:- 1 para los píxeles reales (es decir, no enmascarados),
- 0 para los píxeles que son relleno (es decir, mascarados).
- output_auxiliary_logits (
bool, opcional) — Si se deben o no generar logits auxiliares. - output_hidden_states (
bool, opcional) — Indica si se deben devolver los estados ocultos de todas las capas. Consultehidden_statesen los tensores devueltos para obtener más detalles. - output_attentions (
bool, opcional) — Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulteattentionsen los tensores devueltos para obtener más detalles. - return_dict (
bool, opcional) — Indica si se debe devolver un ModelOutput en lugar de una tupla simple.
Devuelve
OneFormerForUniversalSegmentationOutput o tuple(torch.Tensor)
Un OneFormerForUniversalSegmentationOutput o una tupla de
torch.Tensor (si se pasa return_dict=False o cuando config.return_dict=False) que comprende varios
elementos según la configuración (OneFormerConfig) y las entradas.
El método forward de OneFormerForUniversalSegmentation reemplaza el método especial __call__.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de
Moduledespués en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de pre y postprocesamiento, mientras que la segunda los ignora silenciosamente.
- loss (
torch.Tensor, opcional) — La pérdida calculada, devuelta cuando hay etiquetas presentes. - class_queries_logits (
torch.Tensor, opcional) — Un tensor de forma(batch_size, num_queries, num_labels + 1)que representa las clases propuestas para cada consulta. Tenga en cuenta que el+ 1es necesario porque incorporamos la clase nula. - masks_queries_logits (
torch.Tensor, opcional) — Un tensor de forma(batch_size, num_queries, height, width)que representa las máscaras propuestas para cada consulta. - auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista de predicciones de clase y máscara de cada capa del decodificador del transformer. - encoder_hidden_states (
tuple(torch.Tensor), opcional, devuelto cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de las incrustaciones + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo codificador en la salida de cada etapa. - pixel_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, num_channels, height, width). Estados ocultos (también llamados mapas de características) del modelo decodificador de píxeles en la salida de cada etapa. - transformer_decoder_hidden_states (
tuple(torch.Tensor), opcional, se devuelve cuando se pasaoutput_hidden_states=Trueo cuandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(una para la salida de los embeddings + una para la salida de cada etapa) de forma(batch_size, sequence_length, hidden_size). Estados ocultos (también llamados mapas de características) del decodificador transformer en la salida de cada etapa. - transformer_decoder_object_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas de objeto de salida de la última capa del decodificador transformer. - transformer_decoder_contrastive_queries (
torch.Tensorde forma(batch_size, num_queries, hidden_dim)) — Consultas contrastivas del decodificador transformer. - transformer_decoder_mask_predictions (
torch.Tensorde forma(batch_size, num_queries, height, width)) — Predicciones de máscaras de la última capa del decodificador transformer. - transformer_decoder_class_predictions (
torch.Tensorde forma(batch_size, num_queries, num_classes+1)) — Predicciones de clase de la última capa del decodificador transformer. - transformer_decoder_auxiliary_predictions (
Listde Dict destr, torch.Tensor, opcional) — Lista de predicciones de clase y máscara de cada capa del decodificador transformer. - text_queries (
torch.Tensor, opcional de forma(batch_size, num_queries, hidden_dim)) — Consultas de texto derivadas de la lista de texto de entrada, utilizadas para calcular la pérdida contrastiva durante el entrenamiento. - task_token (
torch.Tensorde forma(batch_size, hidden_dim)) — token de tarea 1D para condicionar las consultas. - attentions (
tuple(tuple(torch.Tensor)), opcional, se devuelve cuando se pasaoutput_attentions=Trueo cuandoconfig.output_attentions=True) — Tupla detuple(torch.Tensor)(una por cada capa) de forma(batch_size, num_heads, sequence_length, sequence_length). Pesos de Self y Cross Attentions del decodificador del transformer.
Ejemplo:
Ejemplo de segmentación universal:
>>> from transformers import OneFormerProcessor, OneFormerForUniversalSegmentation
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch

>>> # load OneFormer fine-tuned on ADE20k for universal segmentation
>>> processor = OneFormerProcessor.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")
>>> model = OneFormerForUniversalSegmentation.from_pretrained("shi-labs/oneformer_ade20k_swin_tiny")

>>> url = (
...     "https://huggingface.co/datasets/hf-internal-testing/fixtures_ade20k/resolve/main/ADE_val_00000001.jpg"
... )
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> # Semantic Segmentation
>>> inputs = processor(image, ["semantic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for semantic postprocessing
>>> predicted_semantic_map = processor.post_process_semantic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]
>>> f"👉 Semantic Predictions Shape: {list(predicted_semantic_map.shape)}"
'👉 Semantic Predictions Shape: [512, 683]'

>>> # Instance Segmentation
>>> inputs = processor(image, ["instance"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for instance postprocessing
>>> predicted_instance_map = processor.post_process_instance_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Instance Predictions Shape: {list(predicted_instance_map.shape)}"
'👉 Instance Predictions Shape: [512, 683]'

>>> # Panoptic Segmentation
>>> inputs = processor(image, ["panoptic"], return_tensors="pt")

>>> with torch.no_grad():
...     outputs = model(**inputs)
>>> # model predicts class_queries_logits of shape `(batch_size, num_queries)`
>>> # and masks_queries_logits of shape `(batch_size, num_queries, height, width)`
>>> class_queries_logits = outputs.class_queries_logits
>>> masks_queries_logits = outputs.masks_queries_logits

>>> # you can pass them to processor for panoptic postprocessing
>>> predicted_panoptic_map = processor.post_process_panoptic_segmentation(
...     outputs, target_sizes=[(image.height, image.width)]
... )[0]["segmentation"]
>>> f"👉 Panoptic Predictions Shape: {list(predicted_panoptic_map.shape)}"
'👉 Panoptic Predictions Shape: [512, 683]'